
RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法|生成AIのしくみ 第7回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第7回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①RAGは、質問のたびに関係する資料を探して渡し、それを根拠に答えさせる方法であること、②ファインチューニングは、追加の学習でモデルの重みそのものを調整する方法であること、③AIエージェントは、LLMが道具を使いながら複数の手順を自分で進める仕組みであること。そして、この3つをどう使い分けるか。
前回は、LLMの苦手として、ハルシネーション、知識の期限、長い入力の見落とし、正確な計算などを見ました。今回は、こうした苦手を補い、LLMを実際の業務に組み込むための代表的な3つの方法を整理します。生成AIの導入を検討するとき、ベンダーの提案書には必ずと言っていいほどこれらの言葉が出てきます。仕組みが分かれば、提案の中身を自分で判断できるようになります。
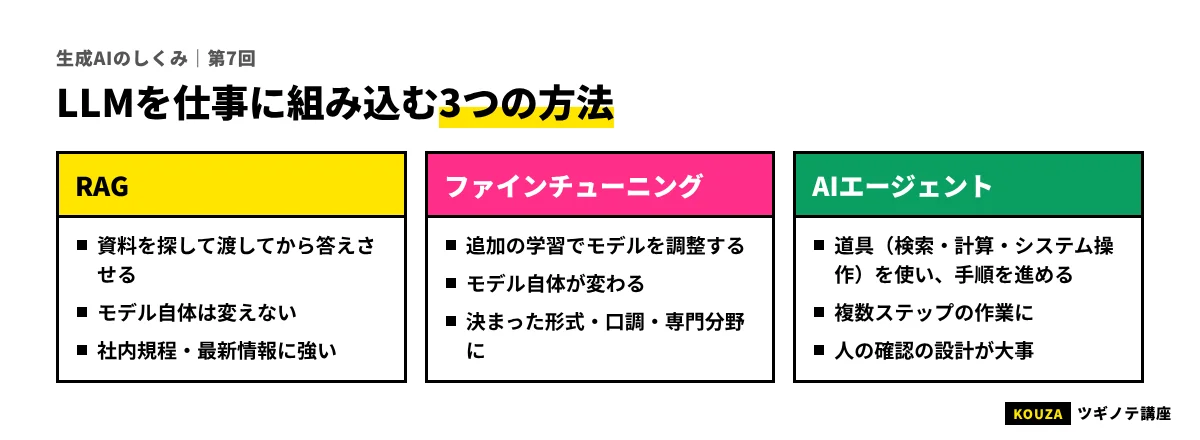
3つの方法をひとことで
まず全体像をつかみましょう。新しく配属された優秀な新人(LLM)に、社内の仕事をしてもらう場面にたとえます。
| 方法 | 新人へのたとえ | モデル自体は変わる? | 向いていること |
|---|---|---|---|
| RAG(検索拡張生成) | 質問のたびに、関係する社内資料を机に置いてから答えてもらう | 変わらない | 社内規程・マニュアル・最新情報にもとづく回答 |
| ファインチューニング | 研修を受けさせて、社内の言葉づかいや判断のクセを身につけてもらう | 変わる(重みを追加で調整) | 決まった形式・文体・専門的な分類 |
| AIエージェント | 電話・パソコン・社内システムを使わせて、仕事を最後まで任せる | 変わらない(道具の使い方を指示する) | 調べる・計算する・登録するなど複数の手順がある作業 |
順番に見ていきます。
RAG:資料を渡してから答えさせる
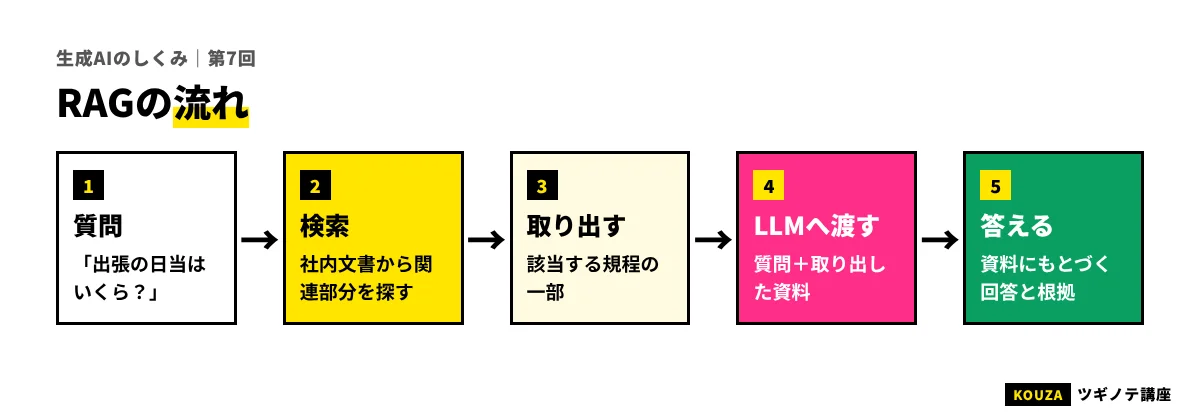
RAG(Retrieval-Augmented Generation、検索拡張生成)は、2020年に発表された研究で名前が広まった方法です。LLMに直接答えさせるのではなく、まず関係する資料を検索して取り出し、それをプロンプト(指示文)に添えて、資料にもとづいて答えさせます。
RAGの流れ
- 準備:社内規程やマニュアルなどの文書を、適当な長さの断片(チャンク)に分け、それぞれを第3回で見た埋め込み(ベクトル)に変換して保存しておく(このための保存庫を「ベクトルデータベース」と呼ぶことがあります)
- 検索:ユーザーの質問も埋め込みに変換し、意味の近い断片を探して数件取り出す(キーワード検索と組み合わせることも多い)
- 生成:「次の資料にもとづいて答えてください。資料にないことは分からないと答えてください」といった指示とともに、取り出した断片と質問をLLMに渡して答えさせる
- 出典の表示:どの資料のどこを根拠にしたかを、答えと一緒に示す
RAGの長所と注意点
長所は、モデルを再学習せずに、社内の最新情報を答えに反映できることです。文書を差し替えれば、すぐに答えも変わります。根拠となる資料を示せるので、人が確認しやすいのも大きな利点です。
一方で、RAGの答えの質は、検索で正しい資料を取り出せるかどうかに大きく左右されます。
- 文書の分け方が悪い(表が途中で切れる、見出しと本文が離れる)と、必要な情報がうまく取り出せない
- 古い版と新しい版の規程が混在していると、古い方を根拠にしてしまう
- 検索で関係の薄い断片を拾うと、それに引っ張られて誤った答えになる
「RAGを入れたのに精度が出ない」というとき、原因の多くはLLMではなく、文書の整備や検索の部分にあると言われます。
RAGの説明として最も適切なものはどれでしょう?
- 社内文書を使って、LLMの重みを一から学習し直す方法
- 質問に関係する資料を検索して取り出し、それを根拠として答えさせる方法
- LLMの出力を、別のLLMに翻訳させる方法
答えと解説
正解は2。RAGはモデルそのものは変えずに、質問のたびに関係する資料を検索して渡し、それにもとづいて答えさせる方法です。資料を差し替えれば、すぐに答えに反映されます。
ファインチューニング:モデルを追加で学習させる
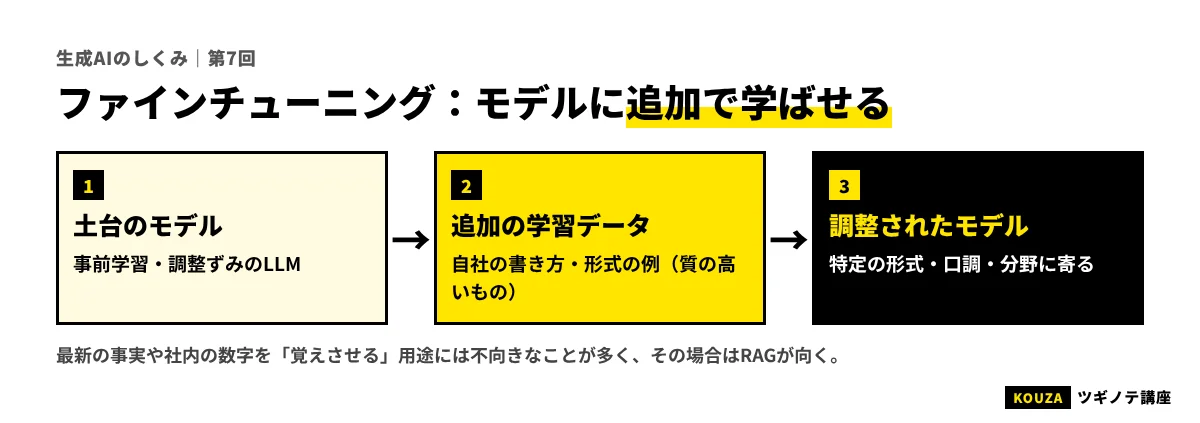
ファインチューニングは、すでに学習済みのLLMに、特定の目的のデータで追加の学習を行い、重みを調整する方法です。第5回で見た「指示チューニング」も、ファインチューニングの一種です。
向いていること、向いていないこと
ファインチューニングが効果を発揮しやすいのは、「どう答えるか(振る舞い)」を変えたいときです。
- 社内の決まった報告書の形式や文体で、毎回そろった出力をさせたい
- 問い合わせを、自社独自のカテゴリに分類させたい
- 特定の分野の専門用語や言い回しに慣れさせたい
- 長い指示を毎回書く代わりに、振る舞いをモデルに覚えさせて、コストや応答時間を減らしたい
一方で、「新しい知識を覚えさせる」目的には、注意が必要です。追加学習で事実を覚えさせても、正確に思い出せるとは限らず、かえってハルシネーションを招くことがあると指摘されています。また、情報が更新されるたびに学習し直す必要があります。社内の知識を答えさせたいなら、まずRAGを検討するのが一般的です。
もう一歩深く
大きなモデルの重みをすべて調整し直すには、膨大な計算資源が必要です。そこで、元の重みは固定したまま、小さな追加の部品だけを学習する方法がよく使われます。代表的なものが2021年に発表された「LoRA(低ランク適応)」で、学習するパラメータ数を大幅に減らしながら、全体を調整した場合に近い性能が得られると報告されています。こうした手法をまとめて「パラメータ効率のよいファインチューニング(PEFT)」と呼びます。
AIエージェント:道具を使って、仕事を進める
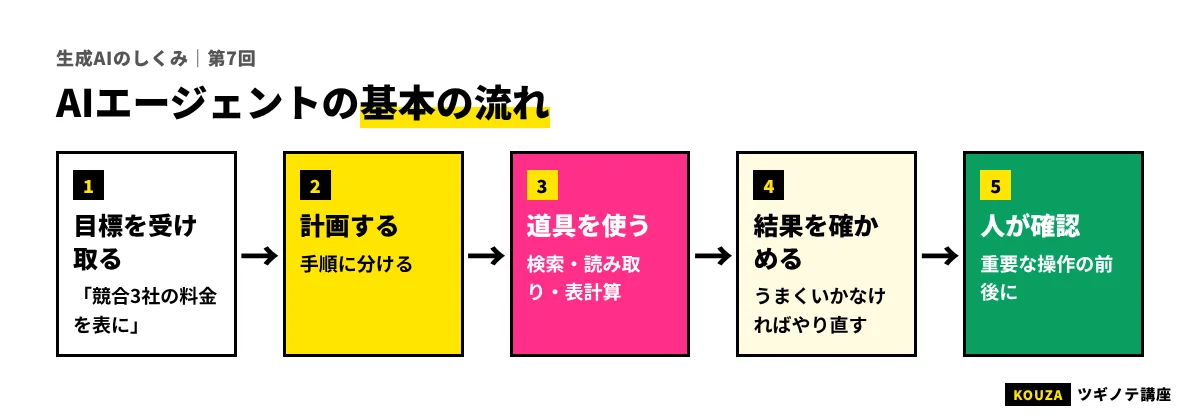
AIエージェントは、LLMが「答えを返す」だけでなく、目的を達成するために、自分で手順を考え、道具(ツール)を使い、結果を見て次の行動を決める仕組みです。
道具を使えるようになる仕組み
LLM自体は文章を生成するだけですが、「使える道具の一覧と使い方」を指示文で伝えておくと、「この場面では、検索ツールを、このキーワードで使う」といった指示を、決まった形式で出力できます。その出力を受けて、周りのプログラムが実際に検索を実行し、結果をLLMに返します。LLMはその結果を読んで、次の行動を決めます。この仕組みは「ツール利用(関数呼び出し)」などと呼ばれます。
道具の例は次のとおりです。
- Web検索、社内文書の検索(RAGもエージェントの道具の1つになりうる)
- 計算や表の集計のためのプログラム実行
- メールやチャットの送信、カレンダーの登録
- 社内システムやデータベースの読み書き
- ブラウザの操作
エージェントの基本の流れ
研究では、「考える→行動する→結果を観察する」を繰り返す方式(ReActなど)が知られています。
- 目的を受け取る(例:「来週の出張の候補便を調べて、予算内のものを表にまとめて」)
- 次にやるべきことを考える(「まず日程と予算を確認し、便を検索する」)
- 道具を使う(検索を実行する)
- 結果を観察する(候補が見つかった、または条件に合わなかった)
- 目的を達成するまで2〜4を繰り返し、最後に結果をまとめる
AIエージェントの特徴として、最も適切なものはどれでしょう?
- 答えを1回だけ返し、それ以上は何もしない
- モデルの重みを毎回学習し直して、賢くなっていく
- 目的に向けて手順を考え、道具を使い、結果を見て次の行動を決めることを繰り返す
答えと解説
正解は3。エージェントは、LLMが検索や計算などの道具を使いながら、複数の手順を自分で進める仕組みです。通常、重みそのものを毎回学習し直すわけではありません。
エージェントで注意すべきこと
エージェントは、できることが広がる分、リスクも大きくなります。
- 誤りの連鎖:途中の判断を1つ誤ると、それを前提に次の行動を重ねてしまう(第4回で見た「前の出力に引っ張られる」性質)
- 取り返しのつかない操作:メール送信、支払い、データの削除などを、確認なしに実行させるのは危険
- 外部からの指示の混入:検索したWebページや受け取ったメールの中に、AIへの指示を装った文章(プロンプトインジェクション)が仕込まれていると、それに従ってしまうおそれがある
- コストと時間:何度も道具を使い、何度もLLMを呼び出すため、単純な質問応答より時間も費用もかかる
そのため実務では、「調べる・下書きする」まではエージェントに任せ、「送信・登録・支払い」の前には人が確認する、という線引きがよく採られます。
よくある誤解:エージェントにすれば、どんな仕事も丸ごと任せられる
2026年11月時点でも、エージェントの得意不得意は作業によって大きく異なります。手順が決まっていて、結果を確かめやすい作業から小さく始め、確認の仕組みを組み込みながら範囲を広げるのが現実的です。
3つの使い分け:どれから検討するか
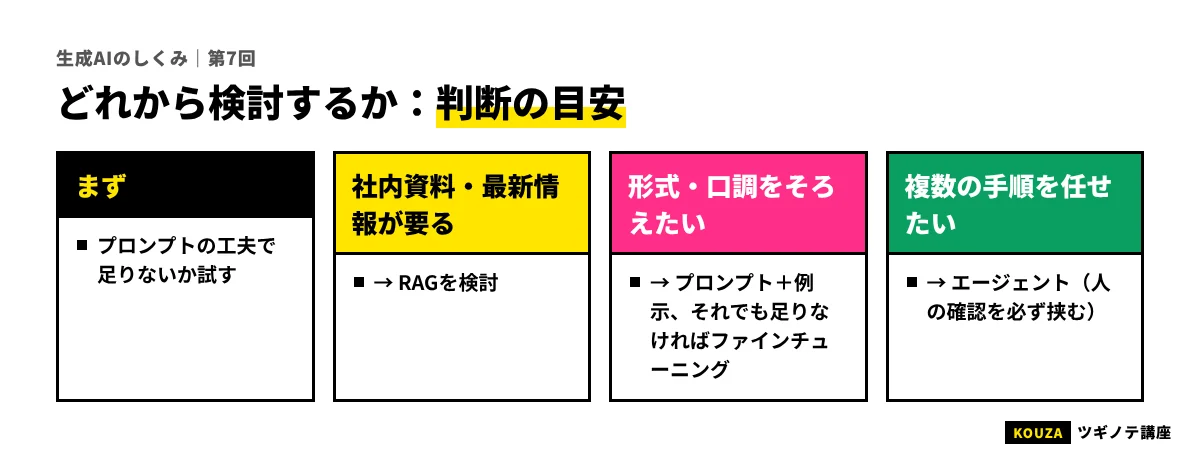
実務での検討順は、おおむね次のようになります。
- まずはプロンプト(指示)の工夫:多くの課題は、指示の書き方と、資料を一緒に渡すことで改善できます。最も安く、早く試せます。
- 社内の知識が必要ならRAG:規程・マニュアル・商品情報など、更新される知識にもとづいて答えさせたい場合。
- 形式や振る舞いをそろえたいならファインチューニング:大量に同じ形式の処理をする場合や、指示だけでは安定しない場合。
- 複数の手順を任せたいならエージェント:調べる・計算する・まとめるといった一連の作業を自動化したい場合。人の確認ポイントを必ず設計する。
これらは組み合わせて使うことも多く、「エージェントが道具としてRAGを使う」「ファインチューニングしたモデルにRAGで資料を渡す」といった構成もよく見られます。
実務ではこう使う:導入の相談で聞くべき質問
ベンダーやツールを選ぶとき、次の質問をすると中身が見えやすくなります。
- 「RAGの場合、文書の分け方や更新はどうするのか。古い版はどう扱うのか」
- 「答えに出典は表示されるか。資料にない質問にはどう答えるか」
- 「ファインチューニングは何のために行うのか。プロンプトやRAGではだめなのか」
- 「エージェントが実行できる操作の範囲はどこまでか。人の承認はどこで入るか」
- 「入力したデータは、モデルの学習に使われるのか」
法人向けの生成AIツールや、導入を支援する会社を比べる際は、法人向け生成AIツールのおすすめ比較やAI導入支援のおすすめ比較も参考にしてください。実際に社内で活用した企業の例は、生成AIの成功事例にまとめています。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- RAGは、質問のたびに関係資料を検索して渡し、それを根拠に答えさせる方法。モデルは変えず、最新の社内情報を反映できる。精度は検索と文書の整備に左右される。
- ファインチューニングは、追加の学習で重みを調整する方法。形式・文体・分類など「振る舞い」を変えるのに向く。知識の追加には慎重に。
- AIエージェントは、道具を使いながら「考える→行動する→観察する」を繰り返して作業を進める仕組み。誤りの連鎖や、取り返しのつかない操作に注意。
- 検討の順番は、プロンプトの工夫→RAG→ファインチューニング→エージェント。組み合わせて使うことも多い。
確認テスト
Q1. 社内規程にもとづいて従業員の質問に答えるAIをつくりたい。規程は年に数回改定される。最初に検討すべき方法はどれでしょう?
- RAG(規程を検索して渡し、それを根拠に答えさせる)
- 規程の改定のたびに、モデルを一から事前学習し直す
- 何も渡さずに、LLMの知識だけで答えさせる
答えと解説
正解は1。更新される社内の知識にもとづいて答えさせたい場合は、文書を差し替えるだけで反映できるRAGが向いています。根拠となる規程の箇所を示せる点も利点です。
Q2. ファインチューニングが特に向いている目的はどれでしょう?
- 毎日変わる株価を正確に答えさせる
- インターネット上の最新ニュースを調べさせる
- 問い合わせを、自社独自の分類に毎回そろった形式で振り分けさせる
答えと解説
正解は3。ファインチューニングは、形式や分類など「振る舞い」をそろえるのに向いています。頻繁に変わる情報や最新情報は、RAGや検索ツールで扱うのが一般的です。
Q3. RAGの答えの精度が上がらないとき、まず見直すべき点として最も適切なものはどれでしょう?
- パソコンの画面の明るさ
- 文書の分け方や、古い版の混在など、検索で正しい資料を取り出せているか
- 質問の文字の色
答えと解説
正解は2。RAGの精度は、検索で正しい資料を取り出せるかに大きく左右されます。文書の分け方、版の管理、検索方法の見直しが、改善の第一歩になることが多くあります。
Q4. AIエージェントを業務で使うときの線引きとして、適切なものはどれでしょう?
- 調べる・下書きするまでは任せ、送信・登録・支払いの前には人が確認する
- すべての操作を確認なしで実行させる
- Webページに書かれた指示には、すべて従わせる
答えと解説
正解は1。エージェントは誤りを重ねたり、外部の文章に紛れた指示に従ってしまったりするおそれがあります。取り返しのつかない操作の前に、人の確認を入れるのが基本です。
次回予告
第8回からは、文章から画像へと舞台を移します。画像生成AIは、どんな技術の積み重ねで今の姿になったのか。VAE、GAN、拡散モデルという3つの系譜を、まずは全体像からつかみましょう。
参考資料
- Lewis, P. et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” arXiv:2005.11401, 2020.(確認日:2026年11月12日)
- Hu, E. J. et al. “LoRA: Low-Rank Adaptation of Large Language Models.” arXiv:2106.09685, 2021.(確認日:2026年11月12日)
- Yao, S. et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” arXiv:2210.03629, 2022.(確認日:2026年11月12日)
- Schick, T. et al. “Toolformer: Language Models Can Teach Themselves to Use Tools.” arXiv:2302.04761, 2023.(確認日:2026年11月12日)
- Greshake, K. et al. “Not what you’ve signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection.” arXiv:2302.12173, 2023.(確認日:2026年11月12日)
- Gekhman, Z. et al. “Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?” arXiv:2405.05904, 2024.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較