
LLMの得意と苦手:ハルシネーション・コンテキスト長・推論|生成AIのしくみ 第6回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第6回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①ハルシネーション(もっともらしい誤り)は、LLMが「確からしい続き」を生成する仕組みから自然に生まれること、②一度に扱える文章の長さ(コンテキストウィンドウ)には上限があり、長くなると途中を見落としやすいこと、③「考える過程」を書かせると推論が改善することがあるが、万能ではないこと。
ここまでの5回で、LLMがどうできていて、どう育てられるかを見てきました。今回はその知識を使って、LLMの「得意」と「苦手」を整理します。苦手の理由が仕組みから分かると、「AIは信用できない」「AIは何でもできる」のどちらでもない、ちょうどよい付き合い方が見えてきます。
まずは得意なことを整理する
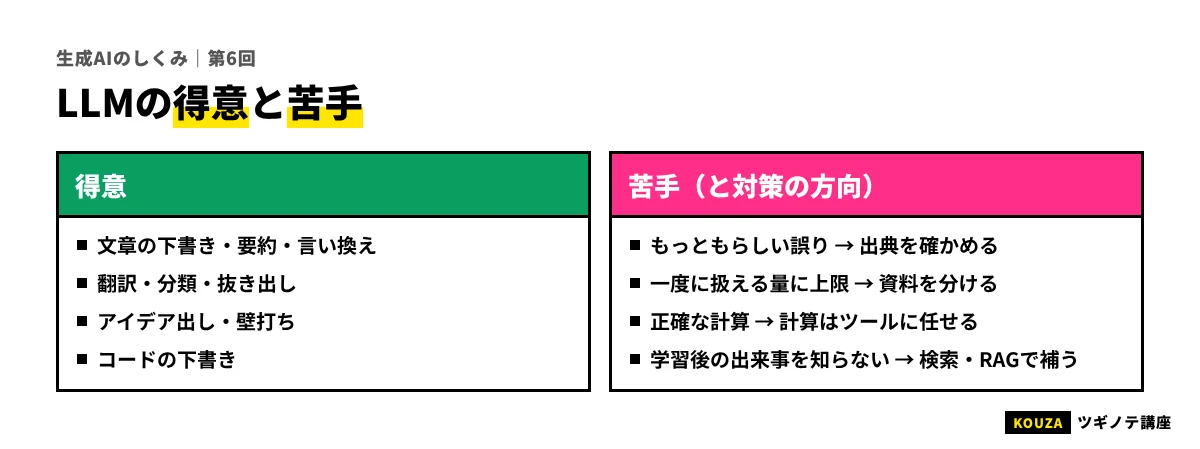
LLMの得意分野は、ひとことで言えば「言葉のパターンを扱う仕事」です。
| 得意なこと | 理由 | 業務の例 |
|---|---|---|
| 文章の要約・言い換え | 文章の構造と意味のパターンを大量に学んでいる | 議事録の要約、専門文書をやさしく書き直す |
| 文章の下書き | よく使われる文章の型を知っている | メール、提案書の骨子、報告書のたたき台 |
| 翻訳 | 多言語の文章を学習している | 海外向け資料の翻訳、問い合わせの一次翻訳 |
| アイデア出し | 多様な組み合わせを素早く出せる | キャッチコピー案、企画の切り口 |
| 形式の変換 | 型の変換は規則的なパターン | 箇条書き⇔表、文章⇔チェックリスト |
| プログラムの作成補助 | コードも大量に学習している | 簡単なスクリプト、エラーの原因の見当づけ |
共通しているのは、「よい答え」に幅があり、人が最終チェックできる仕事だという点です。逆に、1つの正解しかない事実を、確認なしに任せる仕事は、次に見る苦手と重なります。
苦手①:ハルシネーション(もっともらしい誤り)
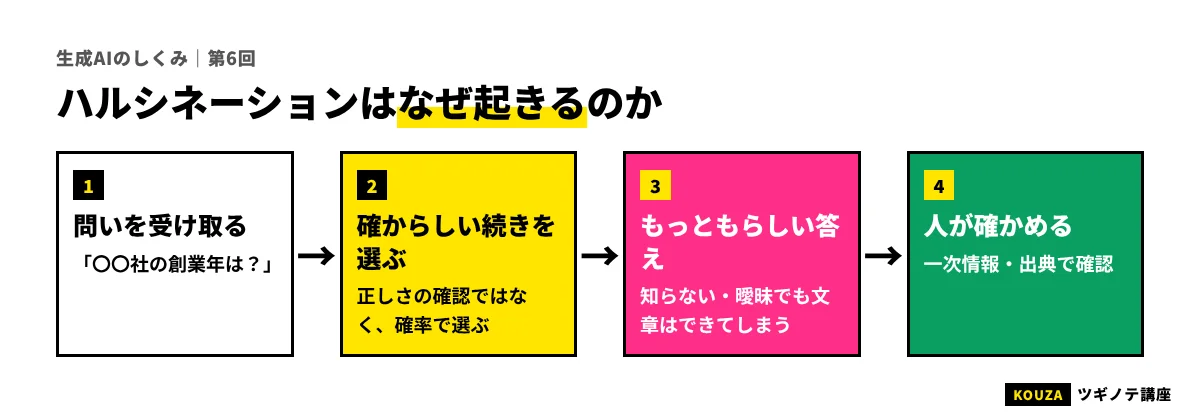
ハルシネーションとは、LLMが事実と異なる内容を、もっともらしく、自信ありげに出力してしまう現象です。実在しない論文や判例をそれらしく挙げたり、存在しない機能を説明したりする例がよく知られています。
なぜ起きるのか:「正しさ」ではなく「確からしさ」で選んでいる
第4回で見たように、LLMは「次に来るトークンの確率」を計算し、それにもとづいて言葉を選びます。ここで選ばれるのは、文脈から見て「ありそう」な言葉であって、「事実として正しい」と確認された言葉ではありません。
たとえば「〇〇株式会社の創業年は」と聞かれたとき、学習データにその会社の情報がたくさんあれば、正しい年が高い確率になります。しかし、情報が少ない、あるいは似た会社と混ざっている場合でも、モデルは「創業年らしい数字」を出すことはできます。文章としての自然さは保たれるので、もっともらしい誤りになるのです。
ハルシネーションが起きやすいのは、次のような場面です。
- 学習データに情報が少ない話題(中小企業、ニッチな分野、最近の出来事)
- 正確な数字・日付・固有名詞・出典を求められたとき
- 質問自体に誤った前提が含まれているとき(「〇〇が2019年に出した新製品について教えて」で、実際には出していない場合など)
- 「分かりません」と答えるより、答えた方が好まれるような調整がかかっているとき
よくある誤解:ハルシネーションはバグなので、そのうち完全になくなる
性能の向上や、検索との組み合わせ(第7回)によって、ハルシネーションは減らすことができます。しかし、「確からしい言葉を生成する」という仕組みそのものに根ざしているため、完全にゼロにするのは難しいと考えられています。人の確認を前提にした運用が大切です。
ハルシネーションが起きる根本的な理由として、最も適切なものはどれでしょう?
- LLMは事実かどうかを確認するのではなく、文脈から見て確からしい言葉を選んでいるから
- LLMがわざとうそをつくように設計されているから
- インターネットの回線が不安定だから
答えと解説
正解は1。LLMは次のトークンの確率にもとづいて言葉を選ぶため、情報が不足していても「それらしい」答えを組み立ててしまうことがあります。意図的なうそではありません。
出力の「ゆらぎ」と温度
LLMは確率分布から言葉を選ぶとき、毎回いちばん確率の高い言葉を選ぶとは限りません。確率に応じてくじ引きのように選ぶことで、表現に変化をもたせています。このくじ引きのばらつき具合を調整する設定が「温度(temperature)」です。
- 温度を低くする:確率の高い言葉が選ばれやすくなり、答えが安定する(ただし単調になりやすい)
- 温度を高くする:確率の低い言葉も選ばれやすくなり、多様で意外な答えが出る(ただし誤りも増えやすい)
APIで使う場合はこの値を調整できることが多く、事実を答えさせる用途では低め、アイデア出しでは高め、といった使い分けをします。ただし、温度を下げてもハルシネーションがなくなるわけではありません。確率の高い答えそのものが誤っていることもあるからです。
苦手②:コンテキストウィンドウ(一度に覚えていられる量)
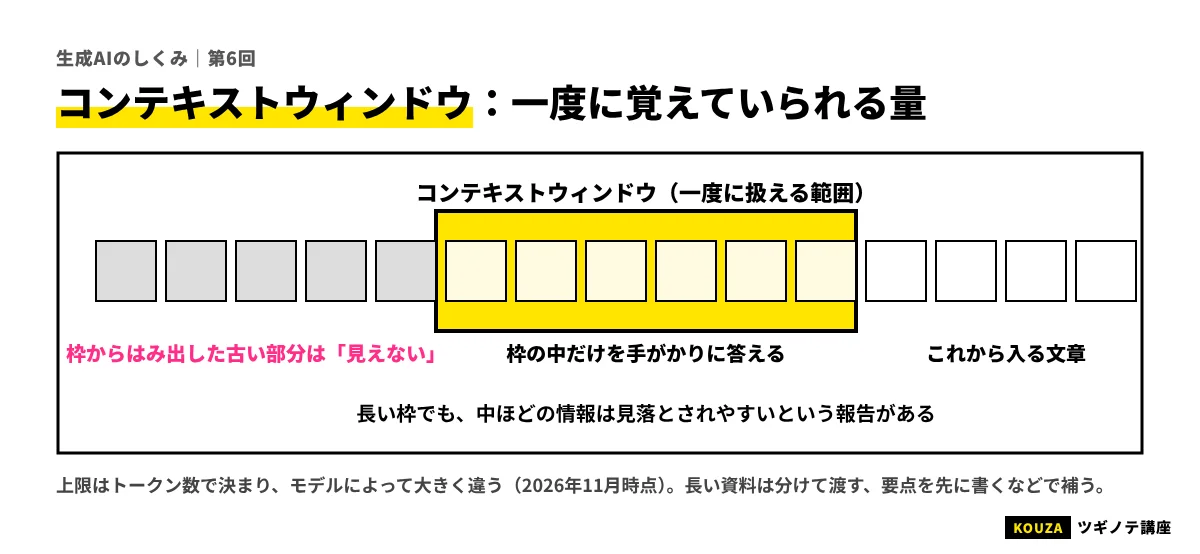
LLMが一度に読み込める文章の量には上限があり、これを「コンテキストウィンドウ」と呼びます。単位はトークンです(第3回)。入力した質問や資料、これまでの会話、そしてLLM自身の出力も、すべてこの枠の中に収まっている必要があります。
枠を超えると、どうなるか
- 長い会話を続けると、古いやりとりが枠からはみ出し、最初に伝えた条件を「忘れた」ように振る舞うことがある(サービスによっては、古い会話を自動で要約して詰め込む仕組みもある)
- 枠より長い資料は、そもそも一度には読み込めない
たとえばGoogleが2024年2月に発表したGemini 1.5 Proは、標準で12万8千トークン、一部の利用者向けに最大100万トークンのコンテキストウィンドウを提供しました。2026年11月時点では、本1冊分を超える文章を一度に入れられるモデルも珍しくなくなっています。ただし、枠が大きければすべて解決、というわけではありません。
枠の中でも「真ん中」は見落としやすい
2023年に発表された研究(「Lost in the Middle」)では、長い入力の中から必要な情報を探させると、情報が冒頭や末尾にあるときに比べて、真ん中にあるときに正答率が下がる傾向が報告されました。人間が長い会議資料を読むとき、最初と最後はよく覚えているのに、中ほどの内容がおぼろげになるのと少し似ています。その後のモデルでは改善も報告されていますが、長い入力ほど注意が分散しやすい、という性質は意識しておく価値があります。
もう一歩深く
第4回で見た注意機構は、すべてのトークン同士の関係を計算します。そのため、入力が2倍になると、計算量はおおよそ4倍になります(トークン数の2乗に比例)。長い入力を扱うための計算の工夫は、現在も活発に研究されている分野です。長い資料を入れるほど、応答が遅くなったり、料金が高くなったりするのはこのためです。
コンテキストウィンドウについて、正しい説明はどれでしょう?
- LLMが学習したデータの総量のこと
- LLMが一度に読み込める入力・会話・出力を合わせた量の上限のこと
- 枠が大きければ、長い資料のどこにある情報も必ず正確に使える
答えと解説
正解は2。コンテキストウィンドウは一度に扱えるトークン数の上限で、学習データの量とは別物です。枠が大きくても、長い入力の途中の情報を見落とすことがあると報告されています。
苦手③と工夫:推論・計算
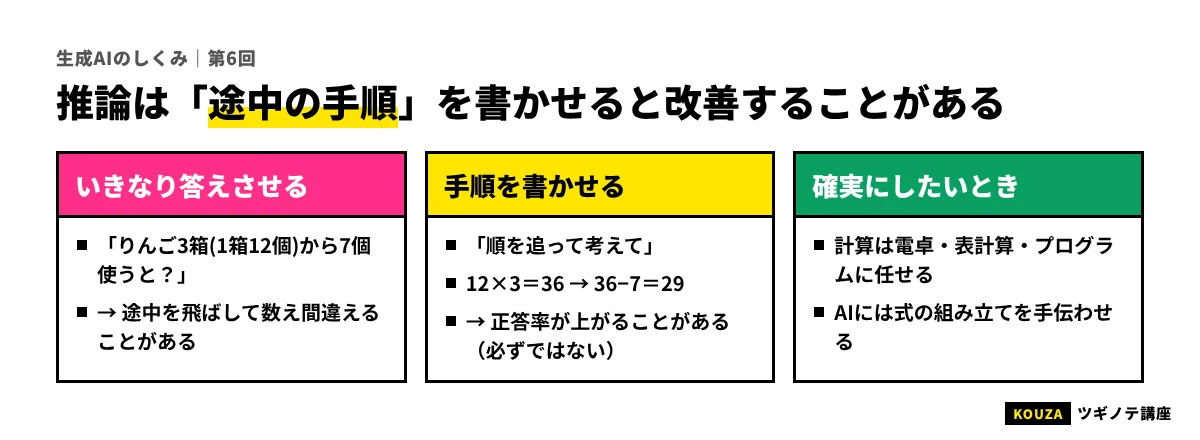
LLMは、複数の手順を踏む論理的な問題や、正確な計算が苦手だと言われてきました。1トークンずつ前から書き足す仕組みのため、途中の計算を「頭の中」だけで一気に済ませるのが難しいからです。
「考える過程」を書かせると、正答率が上がることがある
2022年の研究で、答えだけを求めるのではなく、「段階的に考えて」と促したり、途中の考え方を例として見せたりすると、算数の文章題などの正答率が大きく上がることが報告されました。これを「思考の連鎖(Chain-of-Thought)」と呼びます。途中の考えを文章として書き出すことで、その文章自体が次の推論の手がかりになり、1ステップずつ進められるようになる、と説明されます。
この考え方を発展させ、答える前に内部で長く考える時間をとるよう訓練した「推論(リーズニング)モデル」と呼ばれるLLMも、2024年ごろから各社が提供するようになりました。数学やプログラミングの難しい問題で性能が上がったと報告されています。
ただし、注意点もあります。
- 書き出された「考える過程」が、実際にモデル内部で行われた計算を正確に表しているとは限らない、という研究もある
- 考える時間が長いほど、応答が遅く、コストも高くなる
- 正確な計算は、LLMに頭の中で解かせるより、計算ツールやプログラムを実行させる(第7回)方が確実
苦手④:知識の期限と、自分の限界を知ること
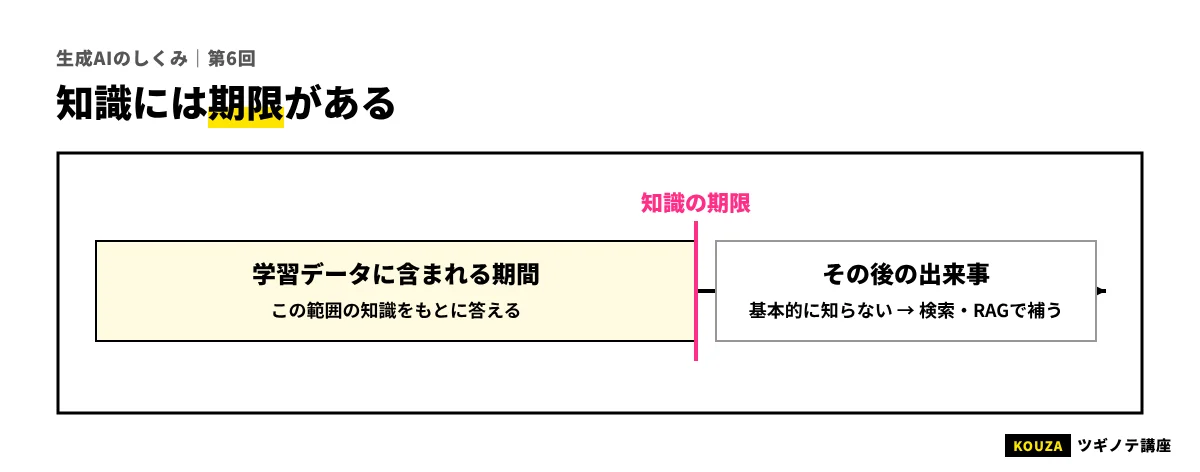
第5回で見たように、LLMの知識は学習データを集めた時点(カットオフ)で止まっています。また、LLMは「自分が知らないこと」を正確に把握するのが苦手で、知らないことでも答えてしまう傾向があります。最近のモデルは「分かりません」と答えるよう調整が進んでいますが、完全ではありません。
実務ではこう使う:苦手を前提にした使い方
仕組みからくる苦手は、使い方でかなり補えます。
| 苦手 | 対策 |
|---|---|
| ハルシネーション | 数字・日付・固有名詞・出典は必ず一次情報で確認する。「根拠となる資料を示して」「分からない場合は分からないと答えて」と指示する。資料を渡してから質問する(第7回のRAG) |
| 長い入力の見落とし | 資料は必要な部分に絞る。大事な指示は冒頭と末尾に置く。長い資料は章ごとに分けて処理する |
| 推論・計算 | 「段階的に考えて」と促す。計算は表計算ソフトやコード実行機能を使わせる |
| 知識の期限 | 最新情報が必要なら検索機能を使うか、資料を渡す |
| 出力のゆらぎ | 出力の形式(項目、文字数、表の列)を指定する。重要な文書は複数回出力させて比べる |
こうした使い方を社内でそろえるには、利用ガイドラインと研修を組み合わせるのが効果的です。研修の選び方はAI研修のおすすめ比較が参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- LLMは要約・下書き・翻訳・アイデア出し・形式変換など「言葉のパターン」を扱う仕事が得意。
- ハルシネーションは、正しさではなく確からしさで言葉を選ぶ仕組みから生まれる。完全にゼロにするのは難しく、人の確認が前提。
- 温度は出力のばらつきを調整する設定。下げても誤りはなくならない。
- コンテキストウィンドウには上限があり、枠内でも長い入力の途中は見落としやすい。
- 「考える過程」を書かせると推論が改善することがあるが、正確な計算はツールに任せる方が確実。
確認テスト
Q1. ハルシネーションが起きやすい場面として、最も当てはまるものはどれでしょう?
- 渡した文章を、短く要約させるとき
- メールの文面を丁寧な言い方に直させるとき
- 情報の少ない中小企業の創業年や、論文の出典を答えさせるとき
答えと解説
正解は3。学習データに情報が少ない事柄や、正確な数字・出典を求める質問では、もっともらしい誤りが出やすくなります。渡した文章の要約や言い換えは、比較的得意な仕事です。
Q2. 温度(temperature)を低く設定したときの説明として正しいものはどれでしょう?
- ハルシネーションが完全になくなる
- 確率の高い言葉が選ばれやすくなり、答えが安定する
- コンテキストウィンドウが大きくなる
答えと解説
正解は2。温度を下げると、確率の高い言葉が選ばれやすくなり、出力のばらつきが減ります。ただし、確率の高い答え自体が誤っていることもあるため、ハルシネーションがなくなるわけではありません。
Q3. 長い資料をLLMに読ませるときの工夫として、最も適切なものはどれでしょう?
- 必要な部分に絞り、重要な指示は冒頭と末尾に置く
- できるだけ多くの資料を一度に詰め込み、指示は真ん中に書く
- 指示は書かず、資料だけを渡す
答えと解説
正解は1。長い入力の途中は見落とされやすいと報告されているため、資料を絞り、重要な指示を冒頭と末尾に置くと安定しやすくなります。
Q4. 「思考の連鎖(Chain-of-Thought)」の説明として正しいものはどれでしょう?
- 複数のAIを鎖のようにつないで、同時に答えさせる方法
- 答えを短くするほど正確になるという性質
- 途中の考え方を書き出させることで、複数の手順が必要な問題の正答率が上がることがある、という工夫
答えと解説
正解は3。段階的に考えを書き出させると、その文章が次の推論の手がかりになり、算数の文章題などで正答率が上がることが報告されています。ただし万能ではなく、正確な計算はツールに任せる方が確実です。
次回予告
第7回では、LLMの苦手を補い、業務に組み込むための3つの方法を見ていきます。社内文書を参照させる「RAG」、追加で学習させる「ファインチューニング」、道具を使って作業を進める「AIエージェント」。それぞれの仕組みと使い分けを整理しましょう。
参考資料
- Ji, Z. et al. “Survey of Hallucination in Natural Language Generation.” arXiv:2202.03629, 2022.(確認日:2026年11月12日)
- Liu, N. F. et al. “Lost in the Middle: How Language Models Use Long Contexts.” arXiv:2307.03172, 2023.(確認日:2026年11月12日)
- Wei, J. et al. “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models.” arXiv:2201.11903, 2022.(確認日:2026年11月12日)
- Kojima, T. et al. “Large Language Models are Zero-Shot Reasoners.” arXiv:2205.11916, 2022.(確認日:2026年11月12日)
- Turpin, M. et al. “Language Models Don’t Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting.” arXiv:2305.04388, 2023.(確認日:2026年11月12日)
- Holtzman, A. et al. “The Curious Case of Neural Text Degeneration.” arXiv:1904.09751, 2019.(確認日:2026年11月12日)
- Google “Introducing Gemini 1.5, Google’s next-generation AI model”(2024年2月15日)(確認日:2026年11月12日)
- OpenAI “OpenAI o3-mini System Card”(2025年1月31日)(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較