
GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる|生成AIのしくみ 第9回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第9回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①GANは、画像をつくる「生成器」と、本物か偽物かを見分ける「識別器」を競わせて学習する仕組みであること、②その競争はバランスが崩れやすく、学習の不安定さや「モード崩壊」といった問題があること、③DCGAN・pix2pix・CycleGAN・StyleGANなどの改良で、GANが高画質な顔写真や画像変換を実現してきた流れ。
前回は、画像生成AIの3つの系譜(VAE・GAN・拡散モデル)を概観しました。今回は、そのうちGAN(敵対的生成ネットワーク、Generative Adversarial Network)を詳しく見ていきます。2026年11月時点では、テキストから画像をつくる用途の主流は拡散モデルに移っていますが、GANの「2つのネットワークを競わせる」という発想は、生成AIの歴史を語るうえで欠かせない、とても面白いアイデアです。
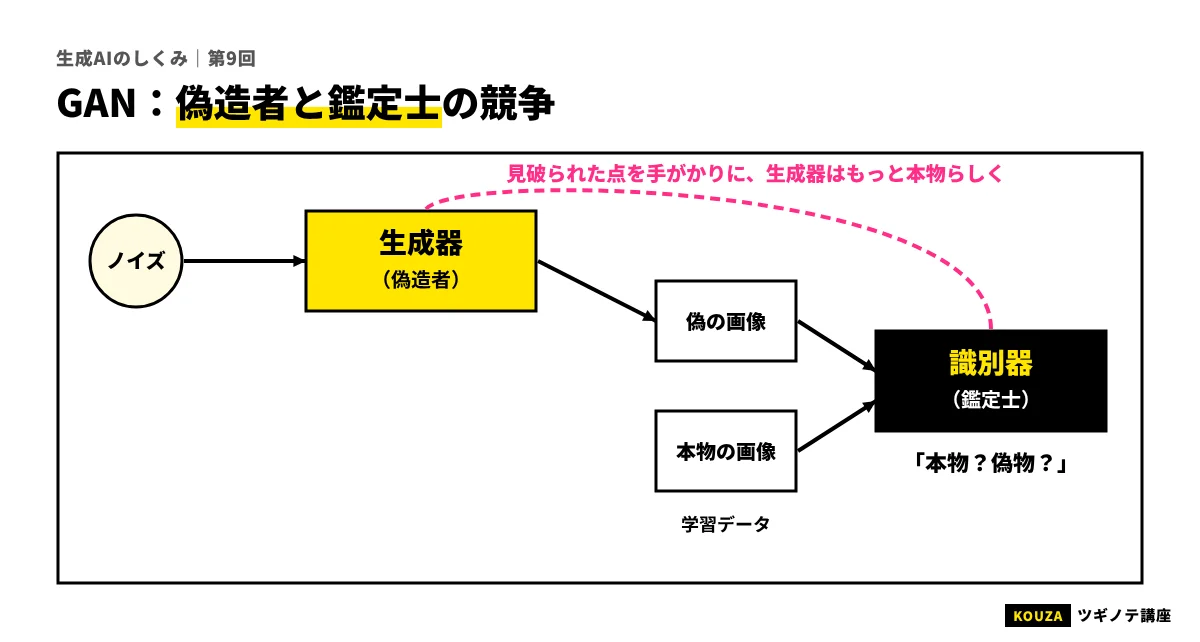
GANの登場人物:生成器と識別器
GANは、2014年にイアン・グッドフェローらが発表した論文で提案されました。登場人物は2つのニューラルネットワークです。
| 役 | たとえ | 受け取るもの | 出すもの | 目標 |
|---|---|---|---|---|
| 生成器(Generator) | 偽造者(偽札づくり) | ランダムな数値の列(ノイズ) | 画像 | 識別器に「本物」と判定させる |
| 識別器(Discriminator) | 鑑定士 | 本物の画像、または生成器がつくった画像 | 「本物である確率」 | 本物と偽物を正しく見分ける |
生成器は、本物の画像を一度も直接見ることはありません。生成器が受け取るのは、識別器からの「その画像は偽物っぽい」という反応だけです。それでも、この反応を手がかりに、少しずつ本物らしい画像をつくれるようになっていきます。
生成器が受け取る「ランダムな数値」の意味
生成器の入力は、たとえば100個程度のランダムな数値です。この数値の組み合わせを変えると、生成される画像が変わります。学習がうまくいくと、この数値の空間(潜在空間)が、画像の特徴の「つまみ」のような役割を持つようになります。ある方向に動かすと顔の向きが変わる、別の方向に動かすと笑顔になる、といった具合です。第3回の埋め込みで「意味が方向として表れる」話をしましたが、画像でも似たことが起きるのです。
学習の流れ:いたちごっこを交互に進める
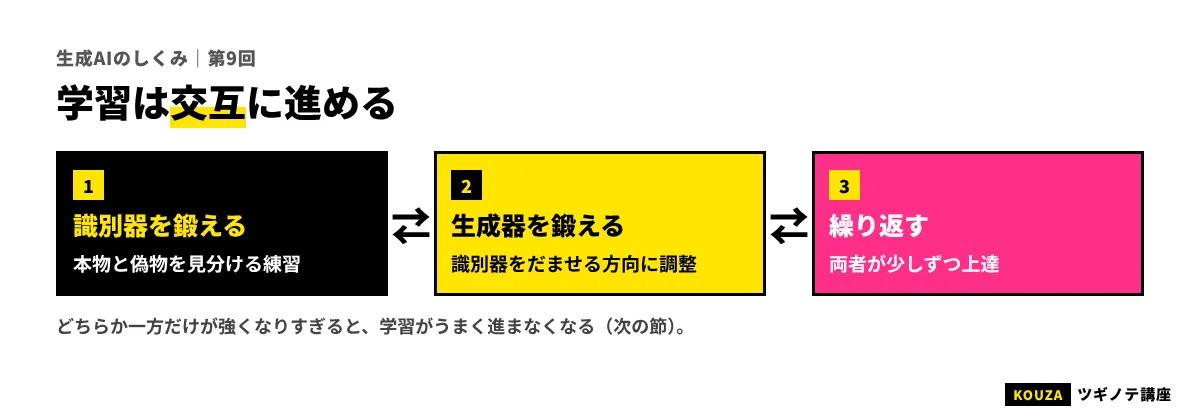
GANの学習は、識別器と生成器の訓練を交互に繰り返します。
- 識別器の番:本物の画像(ラベル「本物」)と、生成器がつくった画像(ラベル「偽物」)を見せ、正しく見分けられるように識別器の重みを直す
- 生成器の番:生成器に画像をつくらせ、識別器に判定させる。識別器が「本物」と言う確率が上がる方向に、生成器の重みを直す(識別器の重みはこのとき固定)
- 1と2を何万回も繰り返す
第2回で見た誤差逆伝播が、ここでも活躍します。生成器の番では、識別器の判定結果から、識別器の中を逆にたどり、さらに生成器の中までさかのぼって、「どの重みをどう直せば、識別器をだましやすくなるか」を計算します。識別器は、生成器にとっての「先生」の役割も果たしているわけです。
理想的には、この競争の末に、生成器は本物と区別できない画像をつくれるようになり、識別器は本物か偽物かを五分五分でしか当てられなくなります。これが、元の論文で示された理論上のゴールです。
GANの学習で、生成器が受け取る「学びの手がかり」はどれでしょう?
- 本物の画像そのものを直接コピーした情報
- 識別器が、生成した画像をどれくらい「本物らしい」と判定したかの反応
- 人が1枚ずつ付けた点数
答えと解説
正解は2。生成器は本物の画像を直接見るのではなく、識別器の判定を手がかりに、識別器をだませる方向へ重みを調整します。識別器が生成器の「先生」の役割を果たしています。
GANの難しさ:バランスが崩れやすい競争
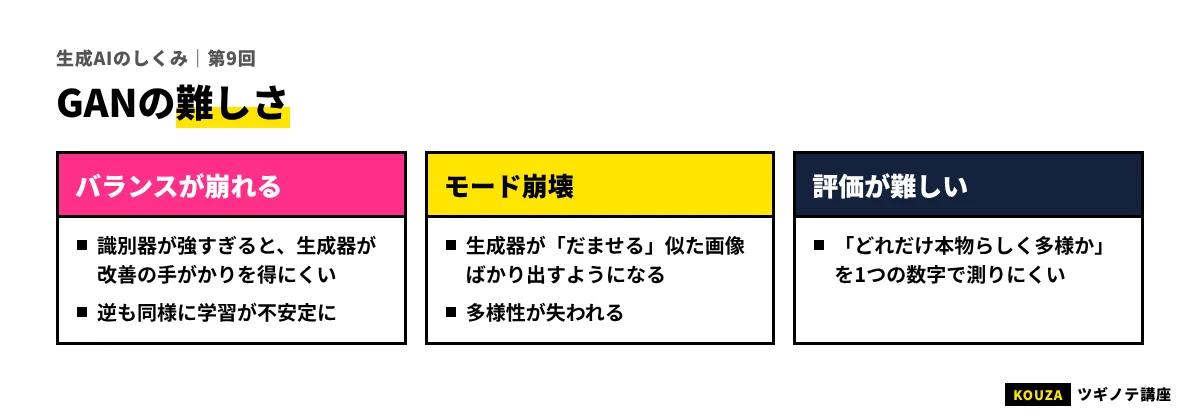
GANのアイデアはシンプルですが、実際に学習させるのは難しいことで知られていました。偽造者と鑑定士の力関係が崩れると、競争がうまく進まないからです。
問題1:学習の不安定さ
- 鑑定士が強すぎる:識別器が序盤から偽物を簡単に見破れるようになると、生成器には「全部だめ」という反応しか返ってこず、どちらに直せばよいかの手がかりが得られなくなる(学習が進まない)
- 偽造者が一時的に勝つ:生成器が識別器の弱点を突く画像ばかりつくると、識別器がそれに対応し、今度は生成器が別の弱点を探す……と、行ったり来たりを続けて落ち着かない
第2回で見た通常の学習は「1つの損失を下げる」坂下りでしたが、GANは「2人が互いに相手を出し抜こうとする」ゲームです。片方が下がると片方が上がる関係のため、坂を素直に下るようには進みません。
問題2:モード崩壊
もう1つの代表的な問題が「モード崩壊(mode collapse)」です。生成器が、識別器をだませる特定の種類の画像ばかりをつくるようになり、多様性が失われる現象です。
たとえば、0〜9の手書き数字を学習させたのに、生成器が「1」ばかりを出すようになる、といったことが起こります。「1」で識別器をだませるなら、わざわざ難しい「8」を描く必要がないからです。偽造者が、一番バレにくい1種類の偽札ばかり刷るようなものです。
もう一歩深く
モード崩壊や不安定さへの対策として、多くの改良が提案されました。代表例が2017年の「WGAN(Wasserstein GAN)」です。識別器に「本物か偽物か」を二択で答えさせる代わりに、本物の分布と偽物の分布の「ずれの大きさ」を測る役をさせることで、生成器に、より安定した学習の手がかりを与えようとしました。ほかにも、識別器の重みの変化を抑える工夫(スペクトル正規化)など、学習を安定させる技術が次々に生まれました。
GANの「モード崩壊」とはどんな現象でしょう?
- 識別器が壊れて、何も判定しなくなる現象
- 生成した画像がすべて真っ黒になる現象
- 生成器が、識別器をだませる特定の種類の画像ばかりつくり、多様性が失われる現象
答えと解説
正解は3。生成器にとって「だましやすい」種類の画像に偏ってしまい、学習データのような多様な画像が出なくなるのがモード崩壊です。
GANの進化:主な改良の流れ
難しさを抱えながらも、GANは2010年代後半に急速に進化しました。主な流れを表にまとめます。
| 年 | 名前 | 何ができるようになったか |
|---|---|---|
| 2014 | GAN(元論文) | 2つのネットワークを競わせる枠組みを提案 |
| 2015 | DCGAN | 画像処理が得意な畳み込みニューラルネットワークを使い、学習を安定させる設計の指針を示した |
| 2016〜17 | pix2pix | 対応する画像のペア(線画と着色画、昼と夜など)から、画像を別のスタイルに変換する |
| 2017 | CycleGAN | ペアのデータがなくても、2つの画像グループ間で変換を学ぶ(馬の写真をシマウマ風に、など) |
| 2017〜18 | Progressive GAN | 小さな解像度から少しずつ大きくして学習し、高解像度の画像を実現 |
| 2018〜 | StyleGAN | 実在しない人物の、写真と見分けにくい顔画像を生成。顔の向き・髪型・質感などを段階的に制御 |
| 2018 | BigGAN | 大規模化によって、多様な種類の物体の画像を高品質に生成 |
StyleGANと「この人物は存在しません」
NVIDIAの研究者らが発表したStyleGAN(2018年〜)は、生成した顔写真の品質で世界を驚かせました。生成器の中で、「大まかな構図(顔の向きや輪郭)」「中くらいの特徴(髪型や目の形)」「細かい質感(肌のきめや髪の毛の流れ)」を段階的に注入する設計で、それぞれを別々に操作できるようにしたのが特徴です。
その結果、実在しない人物の顔写真が、人の目では本物と区別がつきにくい品質で生成できるようになりました。これは技術の大きな成果であると同時に、偽の人物プロフィールや、本人になりすました画像(ディープフェイク)への悪用という、新しい社会問題を浮かび上がらせることにもなりました(第12回で扱います)。
よくある誤解:GANはもう使われていない古い技術
テキストから画像をつくる用途では、拡散モデルが主流になりました。しかし、GANは生成が1回の計算で済み高速なため、画像の高解像度化、画像の変換、リアルタイムの処理などで、現在も使われる場面があります。また、拡散モデルの生成を速くする研究に、GANの「識別器で本物らしさを鍛える」考え方が取り入れられることもあります。GANの発想は、形を変えて生き続けています。
なぜ拡散モデルに主役が移ったのか
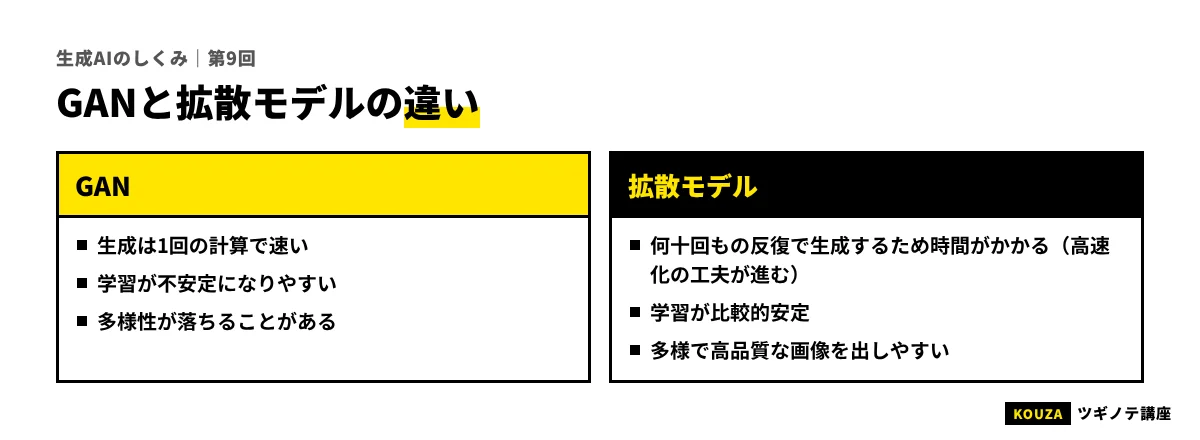
2020年ごろから、画像生成の主役は拡散モデルへ移っていきました。比べると、次のような違いがあります。
| 観点 | GAN | 拡散モデル |
|---|---|---|
| 学習の安定性 | 2者の競争で不安定になりやすい | 「ノイズを当てる」という1つの課題を解くので安定しやすい |
| 多様性 | モード崩壊で偏りやすい | 学習データの多様性を保ちやすい |
| 生成の速さ | 1回の計算で速い | 何段階もの計算が必要で遅い(改良が進んでいる) |
| 言葉での指定 | 工夫すれば可能だが難しい面があった | 言葉の情報を各段階で取り込みやすい |
特に「学習が安定していて、多様性を保ちやすい」点が、大量の多様なデータで大規模なモデルを学習させる流れに合っていました。そして、言葉で細かく指定できることが、一般の人にも使いやすい画像生成AIの普及につながりました。
実務ではこう使う:GANの知識が役立つ場面
- 画像の高解像度化・補正ツール:古い写真の補正や拡大などで、GAN系の技術が使われていることがあります。仕組みとして「もっともらしい細部を描き足している」ことを理解しておくと、証拠写真など、正確さが求められる用途には使わない、といった判断ができます。
- ディープフェイクへの備え:顔写真や動画は、本物そっくりに生成できる時代です。取引先の本人確認や、SNSで拡散される画像の真偽については、画像だけで判断しない運用が必要です。
- 合成データ:個人情報を含む実データの代わりに、生成した疑似データでAIを学習させる研究や取り組みもあります。
画像や動画の生成ツールを業務で選ぶ際は、AI動画生成ツールのおすすめ比較も参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- GANは、生成器(偽造者)と識別器(鑑定士)を競わせ、交互に学習させる仕組み。生成器は識別器の判定を手がかりに腕を上げる。
- 競争のバランスが崩れやすく、学習の不安定さや、同じような画像ばかり出るモード崩壊が課題だった。
- DCGAN、pix2pix、CycleGAN、StyleGANなどの改良で、画像変換や、本物と見分けにくい顔画像の生成が可能になった。
- 安定性・多様性・言葉での指定のしやすさから、主役は拡散モデルに移ったが、GANの発想は高速化や画像処理で生き続けている。
確認テスト
Q1. GANの2つのネットワークの役割として正しい組み合わせはどれでしょう?
- 生成器=ノイズから画像をつくる、識別器=本物か偽物かを判定する
- 生成器=画像を圧縮する、識別器=画像を復元する
- 生成器=文章を書く、識別器=文章を翻訳する
答えと解説
正解は1。生成器はランダムな数値から画像をつくり、識別器は与えられた画像が本物か生成されたものかを判定します。2はVAEのエンコーダーとデコーダーに近い説明です。
Q2. GANの学習が不安定になりやすい理由として、最も適切なものはどれでしょう?
- 学習データが必要ないから
- 1つの損失を素直に下げるだけの学習だから
- 2つのネットワークが互いに相手を出し抜こうとするゲームで、力関係が崩れやすいから
答えと解説
正解は3。GANは2者の競争なので、識別器が強すぎると生成器が学べず、逆に行ったり来たりして落ち着かないこともあります。通常の坂下りのようには進みません。
Q3. CycleGANの特徴として正しいものはどれでしょう?
- テキストから動画をつくる
- 対応する画像のペアがなくても、2つの画像グループの間の変換を学べる
- 識別器を使わずに画像を生成する
答えと解説
正解は2。CycleGANは、たとえば馬の写真の集まりとシマウマの写真の集まりから、ペアの対応がなくても相互の変換を学べる手法です。
Q4. 画像生成の主役がGANから拡散モデルに移った理由として、当てはまらないものはどれでしょう?
- 拡散モデルは、1回の計算で画像ができるので、GANより圧倒的に速いから
- 拡散モデルは学習が安定しやすいから
- 拡散モデルは多様性を保ちやすく、言葉での指定と相性がよいから
答えと解説
正解は1(当てはまらないもの)。拡散モデルは何段階もの計算が必要で、生成の速さではむしろGANが有利です。主役が移ったのは、安定性・多様性・言葉での指定のしやすさなどが理由です。
次回予告
第10回では、現在の画像生成AIの主役、拡散モデルを詳しく見ていきます。ノイズから絵が少しずつ浮かび上がる仕組みと、「夕暮れの海辺を歩く犬」という言葉をどうやって画像に反映させるのか。CLIPやプロンプトの効き方まで、順番に理解しましょう。
参考資料
- Goodfellow, I. et al. “Generative Adversarial Networks.” arXiv:1406.2661, 2014.(確認日:2026年11月12日)
- Radford, A., Metz, L., Chintala, S. “Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks.”(DCGAN)arXiv:1511.06434, 2015.(確認日:2026年11月12日)
- Isola, P. et al. “Image-to-Image Translation with Conditional Adversarial Networks.”(pix2pix)arXiv:1611.07004, 2016.(確認日:2026年11月12日)
- Zhu, J.-Y. et al. “Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks.”(CycleGAN)arXiv:1703.10593, 2017.(確認日:2026年11月12日)
- Arjovsky, M., Chintala, S., Bottou, L. “Wasserstein GAN.” arXiv:1701.07875, 2017.(確認日:2026年11月12日)
- Karras, T. et al. “Progressive Growing of GANs for Improved Quality, Stability, and Variation.” arXiv:1710.10196, 2017.(確認日:2026年11月12日)
- Karras, T., Laine, S., Aila, T. “A Style-Based Generator Architecture for Generative Adversarial Networks.”(StyleGAN)arXiv:1812.04948, 2018.(確認日:2026年11月12日)
- Brock, A., Donahue, J., Simonyan, K. “Large Scale GAN Training for High Fidelity Natural Image Synthesis.”(BigGAN)arXiv:1809.11096, 2018.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較