
AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる|生成AIのしくみ 第1回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第1回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①「AI」「機械学習」「ディープラーニング」「生成AI」は入れ子の関係にあること、②昔のAIと今のAIは「ルールを人が書く」か「データから学ぶ」かで大きく違うこと、③生成AIは「見分けるAI」とは逆向きの仕事をしていること。
この講座の第1回は、言葉の整理から始めます。生成AIの仕組みを理解するうえで、いちばんのつまずきは、似た言葉がバラバラに頭に入っていることです。ニュースでは「AIが〜」「機械学習で〜」「ディープラーニングにより〜」「生成AIが〜」と、同じものを指しているようで微妙に違う言葉が飛び交います。まずは、これらの言葉の「地図」をつくりましょう。
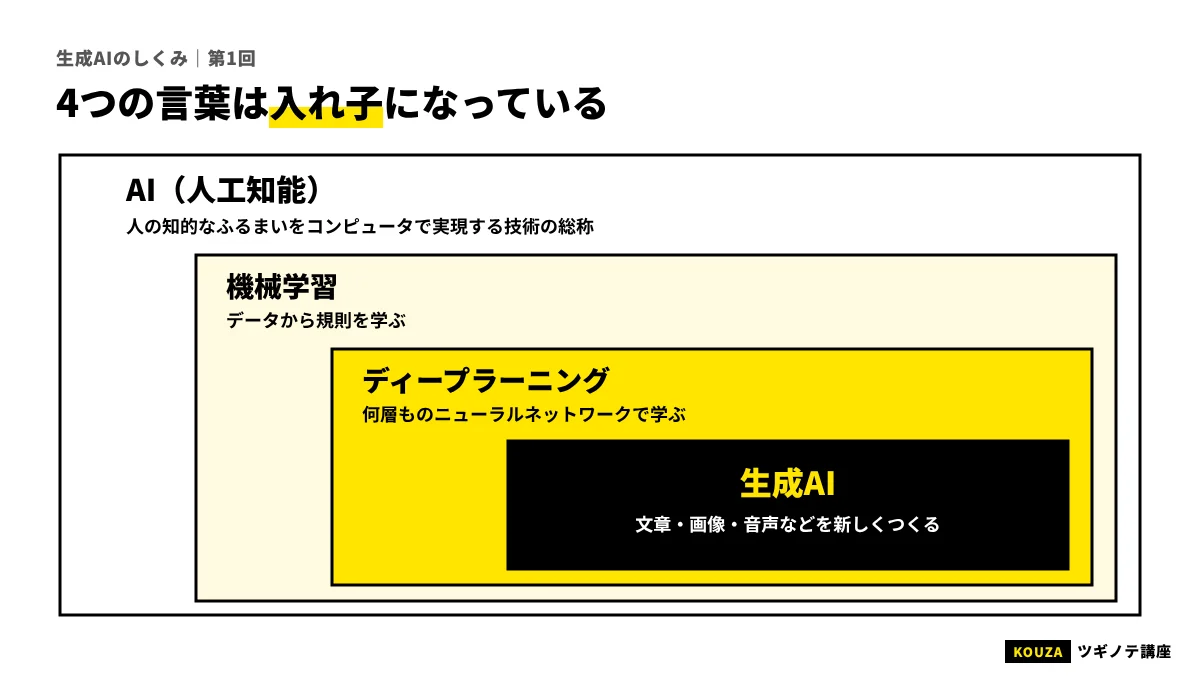
4つの言葉は「入れ子」になっている
結論から言うと、4つの言葉は次のような入れ子(マトリョーシカ)の関係にあります。
| 言葉 | ざっくり言うと | 例 |
|---|---|---|
| AI(人工知能) | 人間の知的な振る舞いを、コンピューターで実現しようとする研究や技術の総称 | チェスのプログラム、迷路を解くプログラム、翻訳、画像認識 |
| 機械学習 | AIのうち、ルールを人が書くのではなく、データから規則性を学ばせる方法 | 迷惑メールの判定、売上予測、おすすめ商品の表示 |
| ディープラーニング(深層学習) | 機械学習のうち、何層にも重ねた「ニューラルネットワーク」を使う方法 | 顔認識、音声認識、機械翻訳 |
| 生成AI | 主にディープラーニングを使って、文章・画像・音声などの新しいデータを「つくる」AI | ChatGPT、Claude、Gemini、画像生成AI |
いちばん外側の「AI」は、とても広い言葉です。1950年代から研究が続いていて、その中には今から見ると「AIと呼ぶのは大げさ」に感じるものも含まれます。その内側に「機械学習」があり、さらに内側に「ディープラーニング」があります。そして今話題の生成AIの多くは、ディープラーニングの技術の上に成り立っています。
注意したいのは、生成AIが「ディープラーニングの中の一部分」と言い切れるわけではないことです。生成AIは「何をするか(新しいものをつくる)」で分けた言葉で、ディープラーニングは「どうやって実現するか(多層のニューラルネットワーク)」で分けた言葉です。分け方の軸が違うので、厳密には重なり合う関係です。ただ、2026年11月時点で話題になる生成AIは、ほぼすべてがディープラーニングを使っているため、入れ子として理解しておけば実務では困りません。
昔のAIと今のAI:「ルールを書く」から「データから学ぶ」へ
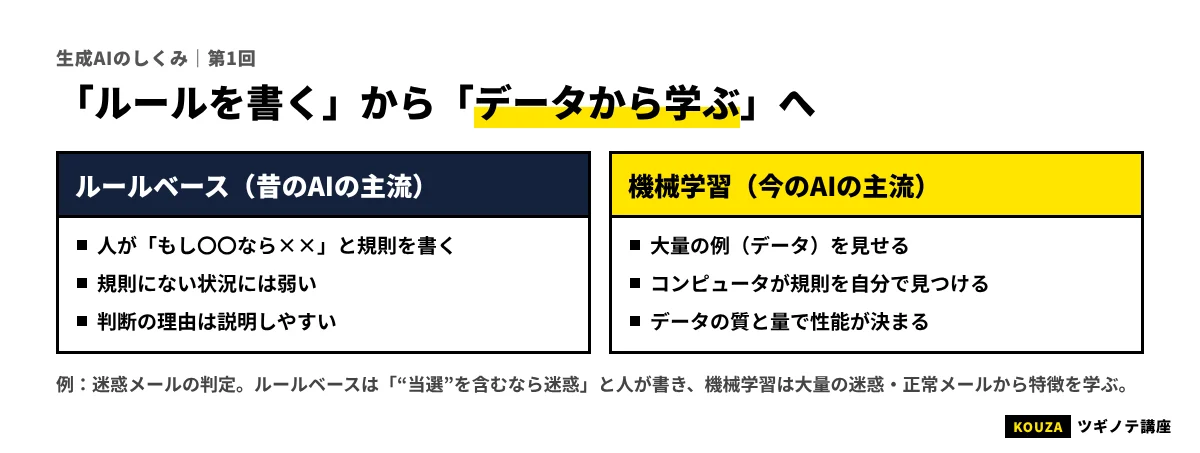
AIの歴史は、大きく見ると「人がルールを書く時代」から「データから学ぶ時代」への移り変わりです。
ルールを人が書くAI
初期のAIや、1980年代に流行した「エキスパートシステム」は、専門家の知識を「もし〜なら〜」というルールの形で書き込む方法でした。たとえば、病気の診断なら「もし熱が38度以上で、せきが出ていて、〜なら、〇〇の可能性が高い」といったルールを何千、何万と書いていきます。
この方法には、分かりやすいという長所があります。なぜその結論になったのか、ルールをたどれば説明できます。一方で、大きな弱点がありました。
- 世の中のすべての場合をルールに書き切ることはできない
- 例外が出るたびにルールを足すと、ルール同士が矛盾し始める
- 「猫の写真を見分ける」のように、人間が言葉で説明できない判断はルールにできない
最後の点は特に重要です。私たちは猫の写真を一瞬で見分けられますが、「耳がこういう形で、目がこうで……」とルールで書こうとすると、すぐに行き詰まります。
データから学ぶAI(機械学習)
そこで登場したのが機械学習です。ルールを人が書く代わりに、「猫の写真」と「猫ではない写真」を大量に見せて、見分け方をコンピューター自身に見つけさせます。
たとえるなら、ルールを書く方法は「料理のレシピを1行ずつ教える」やり方、機械学習は「おいしい料理とまずい料理を何千回も食べさせて、味の違いを舌で覚えさせる」やり方です。後者は、なぜおいしいのかを言葉で説明するのは苦手ですが、判断の精度はどんどん上がっていきます。
迷惑メールの判定を「機械学習」で行う、とはどういうことでしょう?
- 「件名に『当選』が入っていたら迷惑メール」というルールを、人が1つずつ書き込む
- 迷惑メールと普通のメールの実例を大量に与え、見分け方をコンピューターに見つけさせる
- 受け取った人が毎回手で振り分ける
答えと解説
正解は2。機械学習の特徴は、判断の規則を人が書くのではなく、データ(実例)から学ばせる点です。1は「ルールを人が書く」昔ながらのやり方で、迷惑メールの手口が変わるたびにルールを書き直す必要があります。
ディープラーニングは何が「深い」のか
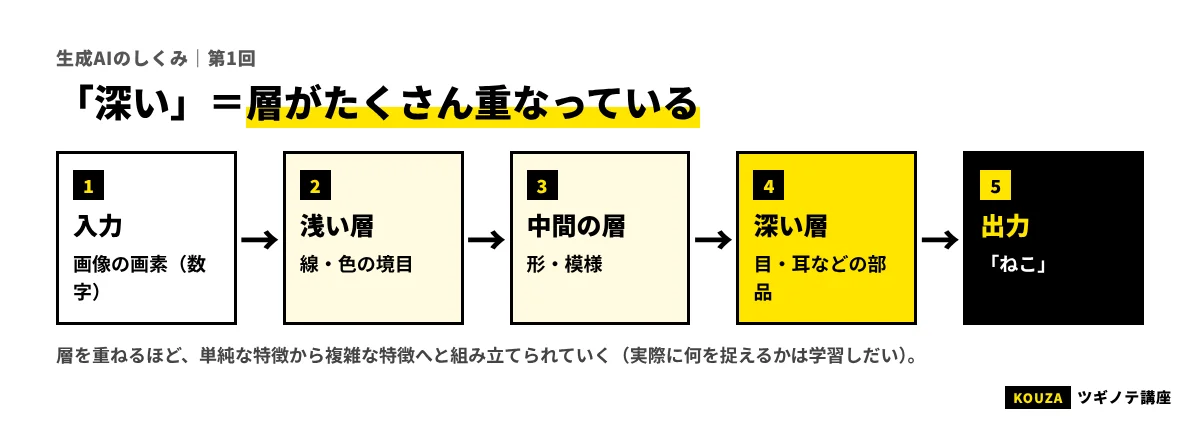
機械学習にはいろいろな方法がありますが、2010年代に急に存在感を増したのがディープラーニングです。「ディープ(深い)」とは、ニューラルネットワークという仕組みの「層」がたくさん重なっていることを指します。ニューラルネットワークの中身は第2回で詳しく扱うので、ここでは役割だけ押さえましょう。
従来の機械学習では、データのどこに注目するか(たとえば画像なら「輪郭」や「色の分布」)を、人がある程度決めて与える必要がありました。これを「特徴量の設計」と言います。ディープラーニングでは、層を重ねることで、注目すべき特徴そのものもデータから学べるようになりました。
画像認識の場合、層ごとに次のような役割分担が自然に生まれることが知られています。
- 最初のほうの層:線や角、色の変化といった単純な模様に反応する
- 真ん中あたりの層:目、耳、車輪のような「部品」の形に反応する
- 最後のほうの層:「猫の顔」「自動車」のような、まとまった物に反応する
人が「ここに注目して」と教えなくても、こうした階層的な見方を学習の中で獲得していく。これが、ディープラーニングが画像・音声・言葉の分野で大きな成果を上げた理由の1つです。
もう一歩深く
ディープラーニングが2010年代に一気に広がったのには、技術以外の理由もあります。①インターネットの普及で大量のデータが手に入るようになったこと、②GPU(もともとはゲームの画像処理用の半導体)を使って、大量の計算を並列で速く回せるようになったこと、③学習を安定させる工夫が次々に見つかったこと、の3つがそろったためです。2012年の画像認識コンテスト(ILSVRC)で、ディープラーニングを使ったチームが従来の方法を大きく上回る成績を出したことが、注目の転機としてよく挙げられます。
生成AIは「見分ける」の逆をやっている
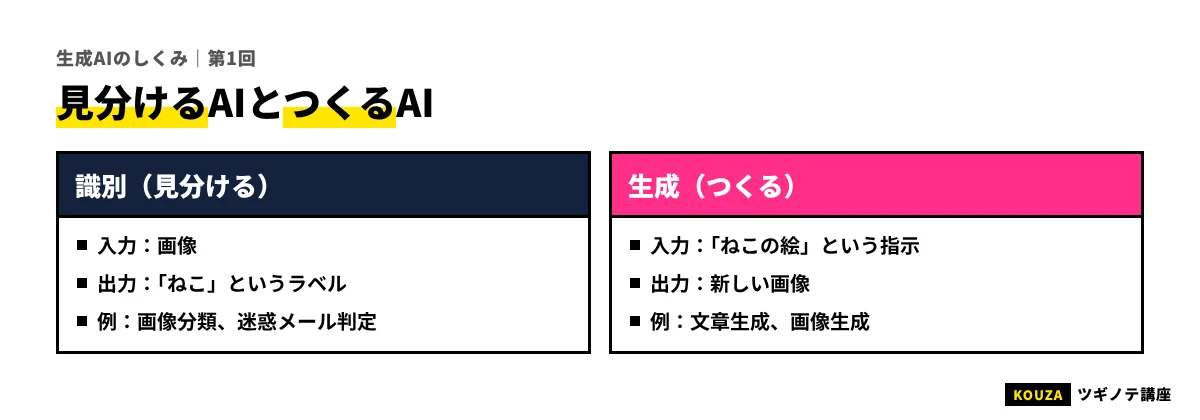
ここまでのAIの多くは、入力されたものを「見分ける」「分類する」「予測する」仕事をしていました。猫か犬か、迷惑メールかどうか、来月の売上はいくらか、といった仕事です。こうしたモデルを「識別モデル」と呼ぶことがあります。
これに対して、生成AIは逆向きの仕事をします。「猫の写真を見て『猫』と答える」のではなく、「『猫』という言葉から、猫の写真をつくる」。「メールを見て迷惑メールか判定する」のではなく、「依頼文から、メールの文面を書く」。つまり、データを受け取って答えを返すのではなく、新しいデータそのものを生み出すのが生成AIです。
| 識別するAI | 生成するAI | |
|---|---|---|
| 仕事 | 入力を見て、どれに当たるかを答える | 条件に合う新しいデータをつくる |
| 例 | 写真→「猫」、メール→「迷惑メール」 | 「猫の写真」→猫の画像、「お礼のメール」→文面 |
| 出力 | ラベル、数値、確率 | 文章、画像、音声、動画、プログラム |
| 正解 | 基本的に1つ | 「よい答え」がたくさんありうる |
最後の行は大切なポイントです。識別の仕事には、たいてい正解が1つあります。一方、「お礼のメールを書いて」に対するよい文面は無数にあります。だから生成AIは、同じ質問をしても毎回少しずつ違う答えを返すのです。これは故障ではなく、仕組み上の性質です(第6回で詳しく扱います)。
次のうち「生成AI」の仕事にいちばん当てはまるものはどれでしょう?
- 工場の製品の写真を見て、傷があるかどうかを判定する
- 過去のデータから、来月のアイスクリームの売上を予測する
- 商品の特徴を伝えると、紹介文の案を3パターン書く
答えと解説
正解は3。1は画像の「識別」、2は数値の「予測」で、どちらも入力から答えを返す仕事です。3は条件に合う新しい文章をつくる仕事なので、生成AIの典型です。なお、実際の業務では、識別と生成を組み合わせて使うこともよくあります。
生成AIの「生成」は、ゼロからの創造ではない
ここで、よくある誤解を1つ解いておきます。
よくある誤解:生成AIは、人間のように意図をもって、ゼロから新しいものを生み出している
生成AIがやっていることを一言で言えば、「学習したデータに見られるパターンをもとに、それらしい新しいデータを組み立てる」ことです。たとえば文章を生成するAI(LLM)は、大量の文章を学習して「この文脈なら、次はこういう言葉が来やすい」というパターンを身につけています。そのパターンに従って、言葉を1つずつ選んで並べていきます。
だからといって、学習データをそのままコピーして貼り合わせているわけでもありません。多くの場合、出力は学習データのどこにもない新しい組み合わせになります。人間が本を読んで身につけた語彙や言い回しで、新しい文章を書くのと、少し似ています。ただし、学習データの一部とほぼ同じ文章や画像が出てしまうこともゼロではありません。この点は、第12回の著作権の話でもう一度扱います。
つまり、生成AIは「何でも知っている天才」でも「つぎはぎのコピー機」でもありません。「膨大なデータから、パターンをとても上手に学んだ予測の仕組み」です。この見方を持っておくと、第6回で扱う「もっともらしい間違い(ハルシネーション)」がなぜ起きるのかも、自然に理解できるようになります。
生成AIが急に身近になった理由
生成AIの研究自体は以前からありました。それが2022年ごろから急に身近になったのには、いくつかの理由が重なっています。
- Transformerという仕組みの登場(2017年):文章の文脈をうまく扱える仕組みで、大きなモデルを効率よく学習できるようになりました(第4回)。
- モデルとデータの大規模化:モデルを大きくし、学習データを増やすほど性能が上がる傾向が、研究で示されました(第5回)。
- 人の好みに合わせる調整:ただ文章の続きを書くだけでなく、指示に従って、役に立つ答えを返すように調整する技術が進みました(第5回)。
- 誰でも使える形での提供:チャット画面で、専門知識なしに話しかけられるサービスとして公開されました。
- 画像生成の飛躍:拡散モデルという方法で、言葉から高品質な画像をつくれるようになりました(第10回)。
この講座では、これらを1つずつ順番に見ていきます。
実務ではこう使う:言葉の地図を、会話の共通言語にする
社内でAI活用を進めるとき、この回の「言葉の地図」はそのまま役に立ちます。
- 相談を受けたら、まず「識別か、生成か」を聞く:「AIで何かしたい」という相談の多くは、実は「分類・予測(識別)」の話か「文章や画像をつくる(生成)」の話のどちらかです。前者なら従来型の機械学習の方が向いていることもありますし、後者なら生成AIのツールを試すのが早道です。
- ベンダーの説明を「どの層の話か」で読む:「AI搭載」と書かれた製品でも、中身はルールベースのこともあれば、生成AIを使っていることもあります。どの仕組みを使っているかで、得意なことと苦手なことが変わります。
- 「毎回答えが違う」を前提に運用を設計する:生成AIの出力は毎回変わりうるので、同じ品質を求める業務では、人の確認や出力の形式の固定が必要になります。
生成AIのツールを選ぶ段階になったら、法人向け生成AIツールのおすすめ比較も参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- AI ⊃ 機械学習 ⊃ ディープラーニングという入れ子があり、今の生成AIの多くはディープラーニングの上に成り立っている。
- 昔のAIは「人がルールを書く」方法、機械学習は「データから学ぶ」方法。言葉で説明できない判断を学べるのが強み。
- ディープラーニングは層を重ねることで、注目すべき特徴そのものを学べるようになった。
- 生成AIは「見分ける」の逆で、新しいデータをつくる。よい答えが複数ありうるので、毎回出力が変わる。
- 生成AIは天才でもコピー機でもなく、「パターンを学んだ予測の仕組み」。
確認テスト
Q1. AI・機械学習・ディープラーニングの関係として正しいものはどれでしょう?
- 3つは互いに無関係な別々の技術である
- AIの中に機械学習があり、機械学習の中にディープラーニングがある
- ディープラーニングの中に機械学習があり、その中にAIがある
答えと解説
正解は2。AIがいちばん広い言葉で、その中の「データから学ぶ方法」が機械学習、さらにその中の「多層のニューラルネットワークを使う方法」がディープラーニングです。
Q2. ルールを人が書くAIが苦手だったことは何でしょう?
- 写真から猫を見分けるような、言葉で規則を書き切れない判断
- なぜその結論になったかを説明すること
- 決まった手順どおりの計算
答えと解説
正解は1。ルールベースのAIは、ルールをたどれば理由を説明しやすい反面、人が言葉で表せない判断や、例外が多い現実の問題をルールに書き切るのが苦手でした。
Q3. 生成AIに同じ質問をしても毎回答えが少し違う理由として、最も適切なものはどれでしょう?
- サーバーの不具合で、答えが壊れているから
- 毎回インターネットを検索し直しているから
- よい答えが1つに決まらない仕事をしていて、出力を確率的に選ぶ仕組みだから
答えと解説
正解は3。生成の仕事には「よい答え」が多数あり、LLMは次の言葉を確率にもとづいて選ぶため、出力が毎回変わりえます。検索機能を持つサービスもありますが、それが答えが変わる根本の理由ではありません。
Q4. 生成AIについての説明として、最も適切なものはどれでしょう?
- 学習した文章や画像を、そのまま切り貼りして出力している
- 学習データのパターンをもとに、それらしい新しいデータを組み立てている
- 人間と同じように意図や感情をもって創作している
答えと解説
正解は2。生成AIは学習したパターンにもとづいて新しい組み合わせを生み出します。単純な切り貼りではありませんが、学習データとよく似た出力が出ることもありうる点には注意が必要です。
次回予告
第2回では、ディープラーニングの土台である「ニューラルネットワーク」が、どうやってデータから学ぶのかを見ていきます。「重み」「損失」「誤差逆伝播」という3つの言葉を、坂道を下るたとえで理解しましょう。
NEXT|第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで次の回へ進む →参考資料
- Turing, A. M. “Computing Machinery and Intelligence.” Mind 59(236), 1950.(確認日:2026年11月12日)
- Krizhevsky, A., Sutskever, I., Hinton, G. E. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems 25(NIPS 2012).(確認日:2026年11月12日)
- LeCun, Y., Bengio, Y., Hinton, G. “Deep learning.” Nature 521, 2015.(確認日:2026年11月12日)
- Vaswani, A. et al. “Attention Is All You Need.” arXiv:1706.03762, 2017.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較