
ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで|生成AIのしくみ 第2回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第2回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①ニューラルネットワークは「重み付きの足し算」と「スイッチ」を何層にも重ねたものであること、②AIが「学ぶ」とは、答えのずれ(損失)が小さくなるように重みを少しずつ直すことであること、③誤差逆伝播は、そのずれの責任を出口から入口へ順に割り振る計算方法であること。
前回は、AI・機械学習・ディープラーニング・生成AIの関係を整理しました。今回は、ディープラーニングの土台である「ニューラルネットワーク」の中身に入ります。ここが分かると、この先に出てくるLLMや画像生成AIも「結局は同じ仕組みの大規模版なんだ」と見通せるようになります。
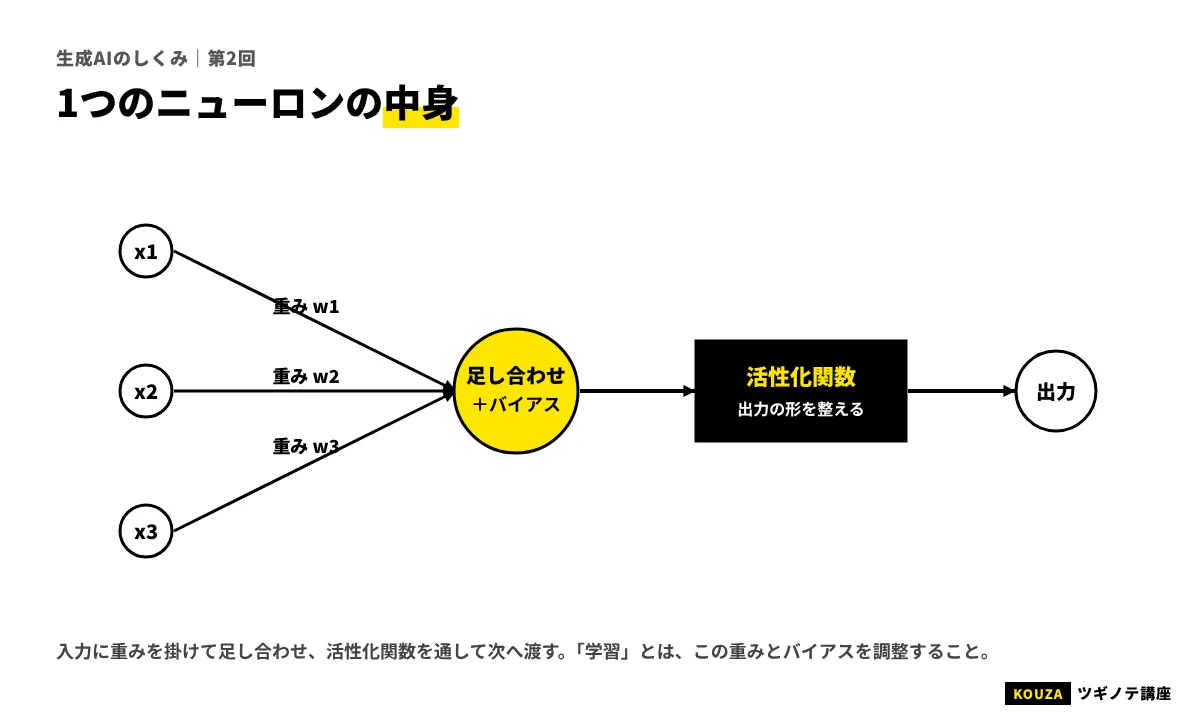
ニューラルネットワークの最小単位:1つのニューロン
ニューラルネットワークは、脳の神経細胞(ニューロン)の働きにヒントを得てつくられた計算の仕組みです。ただし、実際の脳を再現しているわけではありません。「ヒントを得た」程度に考えてください。
最小単位である人工ニューロン1個がやっていることは、とても単純です。
- いくつかの数値を受け取る
- それぞれに「重み」を掛けて足し合わせる(重みが大きい入力ほど重視される)
- 「バイアス」という調整用の数値を足す
- その合計を「活性化関数」というスイッチに通して、出力する
たとえば「今日は外でランチを食べるか」を決めるニューロンを考えてみましょう。
| 入力 | 値 | 重み | 掛け算 |
|---|---|---|---|
| 晴れている(1=はい、0=いいえ) | 1 | 3 | 3 |
| 気温が快適(1=はい、0=いいえ) | 0 | 2 | 0 |
| 仕事が忙しい(1=はい、0=いいえ) | 1 | −4 | −4 |
| 合計+バイアス(+2) | 1 |
合計が0より大きければ「外で食べる」、0以下なら「食べない」というスイッチなら、この日は「外で食べる」になります。「仕事が忙しい」の重みがマイナスなのは、忙しいほど外食しにくい、という関係を表しています。
ここで大切なのは、重みの値が、このニューロンの「考え方」そのものだということです。晴れをどれくらい重視するか、忙しさをどれくらい気にするか。それが数値で表されています。そして、この重みを人が決めるのではなく、データから自動で調整するのが「学習」です。
活性化関数(スイッチ)はなぜ必要か
足し算と掛け算だけを何層重ねても、全体としては1回の足し算と掛け算でまとめられてしまいます。いくら層を重ねても、表現できるのは「直線的な関係」だけになるのです。そこで各ニューロンの出口に、「一定以上なら通す」「マイナスは0にする」といった曲がった関数(活性化関数)を挟みます。これによって、層を重ねるほど複雑な関係を表せるようになります。現在よく使われる活性化関数には、ReLU(マイナスを0にし、プラスはそのまま通す)やその仲間があります。
ニューロンを並べて、層を重ねる
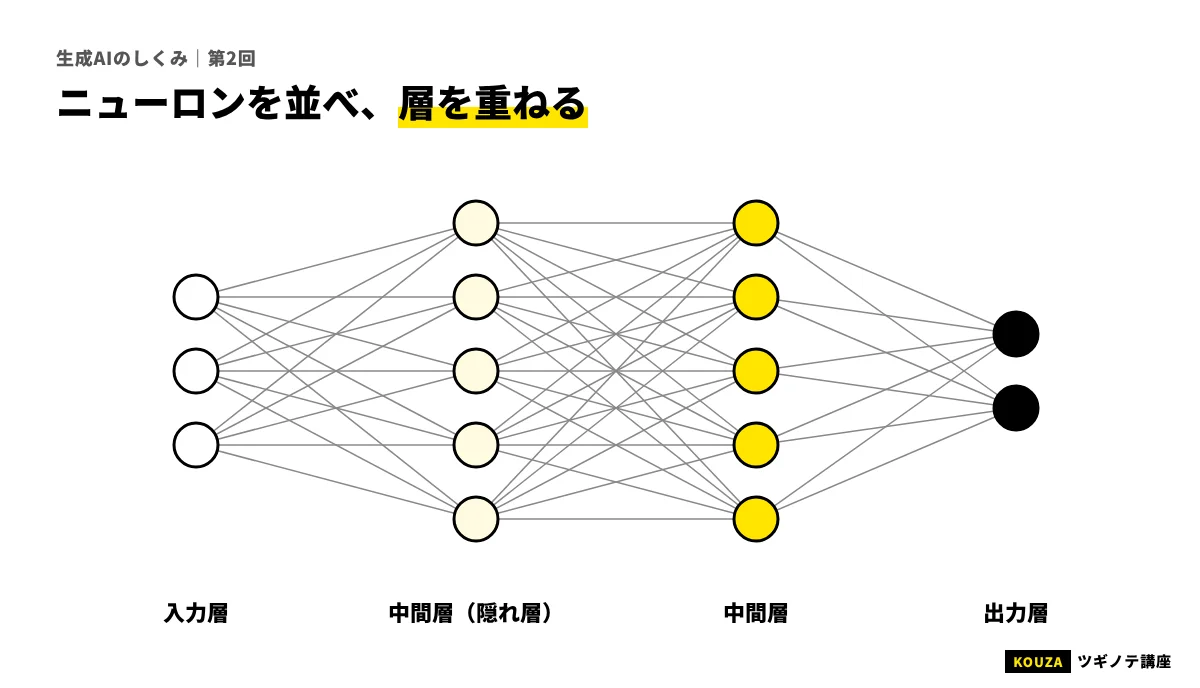
ニューロンを横にたくさん並べたものを「層」と呼び、層を縦に何段も重ねたものがニューラルネットワークです。
- 入力層:データを受け取る入口(画像なら画素の値、文章なら第3回で扱う数値の列)
- 中間層(隠れ層):入力を少しずつ加工していく部分。これが何層もあるのが「ディープ」
- 出力層:最終的な答えを出す出口(「猫の確率は90%」など)
前回、画像認識のネットワークでは、層を進むにつれて「線→部品→物」と、より大きなまとまりに反応するようになると説明しました。それぞれの層のニューロンが、前の層の出力を材料にして、少しずつ抽象的な特徴を組み立てていくイメージです。
最近の大規模なモデルでは、重み(とバイアス)の数、つまり「パラメータ数」が数十億から数千億、あるいはそれ以上に達します。ニュースで「〇〇億パラメータのモデル」と言われるのは、この調整つまみの数のことです。
「パラメータ数が700億のモデル」と言うとき、パラメータとは主に何を指しているでしょう?
- 学習によって調整される重みやバイアスなどの数値
- モデルが学習に使った文章の数
- モデルが一度に返せる文字数
答えと解説
正解は1。パラメータは、ネットワークの中にある調整可能な数値(重みやバイアス)のことです。学習データの量や、一度に扱える文章の長さとは別の指標です。
「学ぶ」とは、ずれを測って、少しずつ直すこと
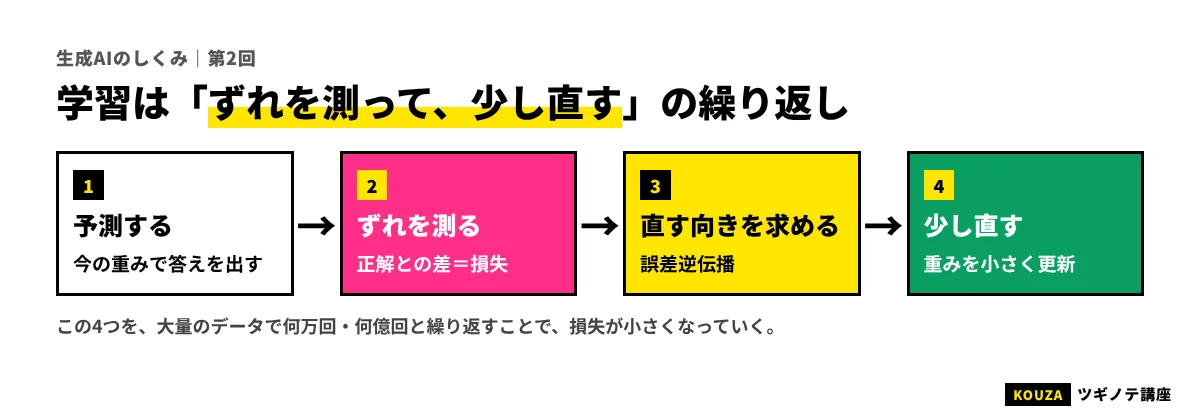
では、重みはどうやって決まるのでしょうか。手順は、ざっくり次の4ステップの繰り返しです。
- 予測する:今の重みで、学習データの入力に対する答えを出す
- ずれを測る:正解と比べて、どれくらい外れたかを1つの数値にする(これを「損失」と言います)
- 直す方向を調べる:それぞれの重みを少し増やしたら損失は増えるか減るかを調べる
- 少し直す:損失が減る方向に、各重みをほんの少しだけ動かす
これを、何百万、何千万回と繰り返します。1回の修正はごくわずかですが、積み重ねると、ネットワークは正解をよく当てられるようになっていきます。
損失:「どれくらい間違えたか」の点数
損失(ロス)は、予測がどれくらい正解から外れているかを表す数値です。損失を計算する式を「損失関数」と呼びます。たとえば猫の写真を見て「猫の確率は30%」と予測したなら、損失は大きくなります。「猫の確率は95%」なら、損失は小さくなります。学習の目標は、学習データ全体でこの損失をできるだけ小さくすることです。
勾配降下法:霧の中で坂を下る
重みをどちらに動かせば損失が減るかを調べ、少しずつ動かしていく方法を「勾配降下法」と言います。よく使われるたとえが、霧の濃い山で、いちばん低い谷を目指して歩くというものです。
- 霧で遠くは見えないので、谷がどこにあるかは分からない
- でも、足元の地面がどちらに傾いているか(勾配)は分かる
- だから、下り坂の方向に一歩ずつ進む
- 一歩の大きさ(学習率)が大きすぎると谷を飛び越えてしまい、小さすぎるといつまでも着かない
実際のニューラルネットワークでは、この「山」は数十億次元という、想像もできない広さの地形です。それでも「足元の傾きを見て下る」という考え方は同じです。
もう一歩深く
実際の学習では、学習データ全部を毎回使って傾きを計算すると時間がかかりすぎるため、データを小さな束(ミニバッチ)に分けて、束ごとに傾きを計算して重みを直します。これを確率的勾配降下法(SGD)と呼びます。束ごとに傾きが少しずつぶれるので、まっすぐではなく少しジグザグに谷へ向かいますが、そのぶれがかえって浅い谷にはまり込むのを防ぐ、とも考えられています。現在は、傾きの履歴も使って歩幅を自動調整するAdamなどの改良版がよく使われます。
勾配降下法で「学習率(一歩の大きさ)」を極端に大きくすると、どうなりやすいでしょう?
- 学習が必ず速く、正確に終わる
- 損失が必ず0になる
- 谷を飛び越えて行ったり来たりし、損失がなかなか下がらない
答えと解説
正解は3。歩幅が大きすぎると、谷底を通り越して反対側の斜面に出てしまい、損失が下がらなかったり、かえって大きくなったりします。逆に小さすぎると、なかなか谷にたどり着きません。
誤差逆伝播:ずれの責任を、出口から入口へ割り振る
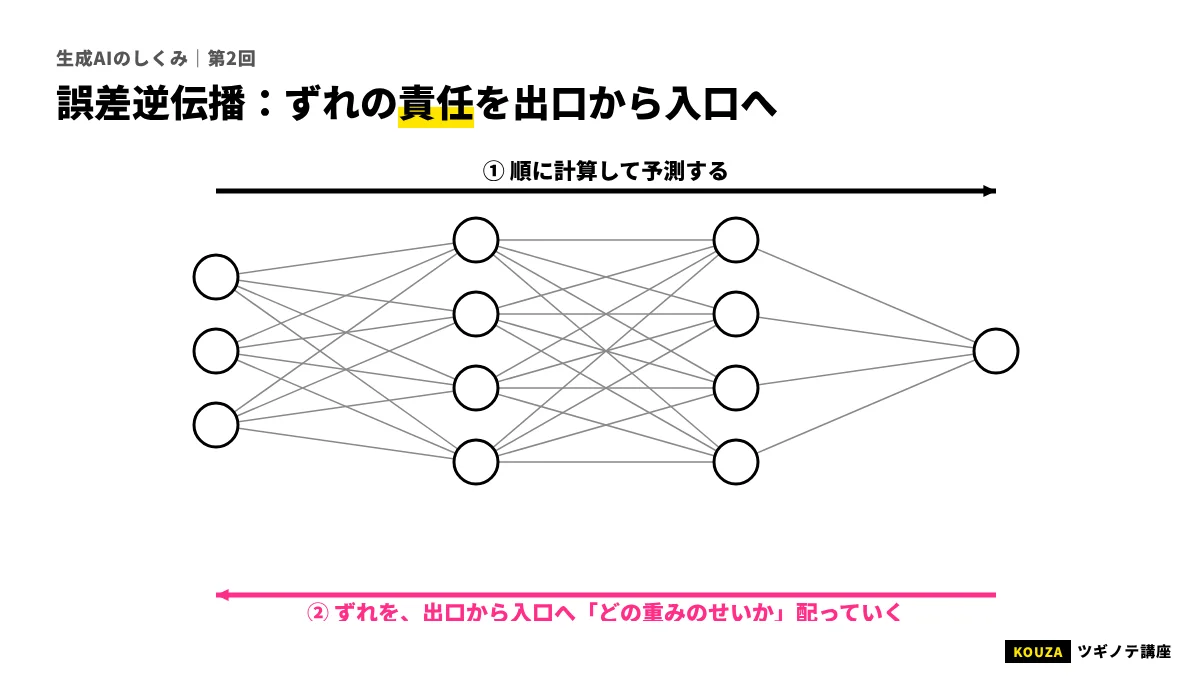
ここで問題になるのが、手順3の「それぞれの重みを少し動かしたら、損失がどう変わるか」です。重みが数十億個あるのに、1個ずつ動かして損失を測り直していたら、いつまでたっても終わりません。
この計算を効率よく行う方法が、「誤差逆伝播(バックプロパゲーション)」です。1986年にラメルハート、ヒントン、ウィリアムズらの論文で広く知られるようになりました。
たとえ:チームの失敗の「責任の割り振り」
工場の製造ラインを思い浮かべてください。原料が工程A→B→C→Dと流れて、最後に製品ができます。最後の検品で「製品が規格より2ミリ大きい」と分かりました。
- まず最後の工程Dの担当者が「自分の作業はこの誤差にどれくらい影響したか」を考える
- 次にDは、前の工程Cから受け取った部品が、どれくらい誤差に影響したかを伝える
- Cはその情報を受けて、自分の作業の影響を計算し、さらにBへ伝える
- これをAまでさかのぼる
こうすれば、全員が一斉に「自分のせいかどうか」を一から調べ直さなくても、出口から入口へ1回さかのぼるだけで、各工程の責任の度合いが分かります。誤差逆伝播も同じで、出力層から入力層へ向かって、「この重みを少し変えたら損失がどれくらい変わるか(勾配)」を、層ごとに順番に計算していきます。
順方向(入口→出口)に計算して予測を出すのを「順伝播」、逆方向(出口→入口)に責任を割り振るのを「逆伝播」と呼びます。1回の学習ステップは「順伝播で予測→損失を計算→逆伝播で勾配を計算→重みを少し直す」の流れです。
よくある誤解:誤差逆伝播は「学習の方法」そのもの
誤差逆伝播は、勾配(どの重みをどちらに直せばよいか)を効率よく計算するための方法です。その勾配を使って実際に重みを動かすのが、勾配降下法(やその改良版)です。「誤差逆伝播で傾きを測り、勾配降下法で坂を下る」と、役割を分けて覚えておくと混乱しません。
学習でつまずきやすい「過学習」
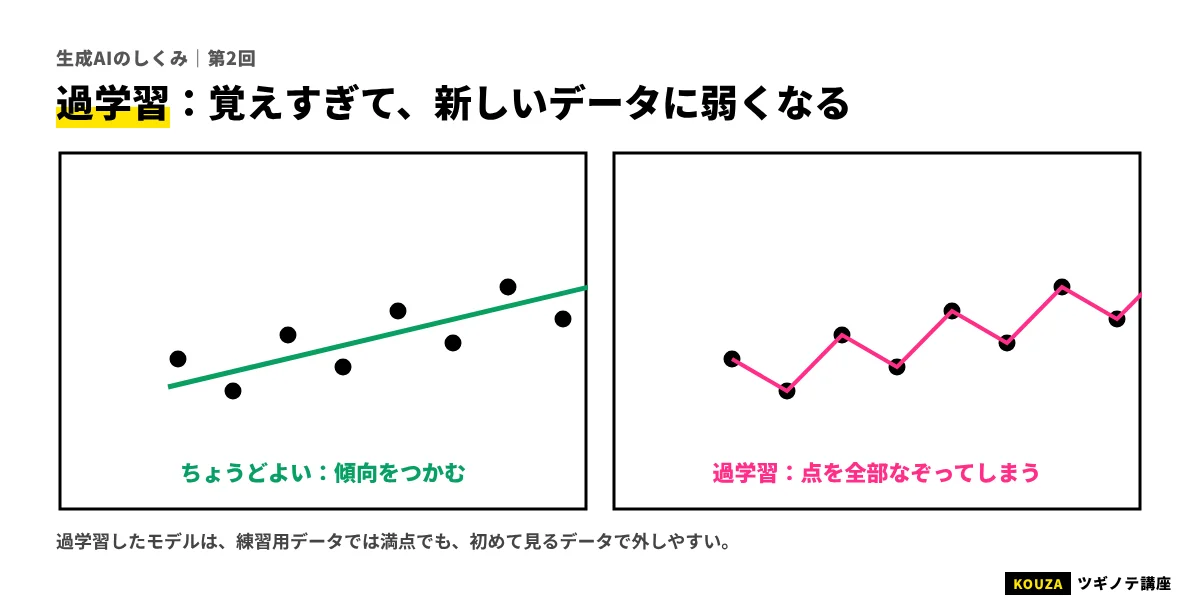
学習データをよく当てられるようになっても、それだけで成功とは言えません。大事なのは、学習で見ていない新しいデータにも正しく答えられるかどうかです。
学習データを丸暗記するようにして、新しいデータに弱くなってしまう状態を「過学習」と言います。試験の過去問の答えを丸暗記した学生が、少し問題を変えられると解けなくなるのと似ています。
過学習を防ぐために、次のような工夫が使われます。
- データを分けて確かめる:学習用とは別に、検証用のデータを取っておき、そこでの成績を見る
- データを増やす:たくさんのバリエーションを見せるほど、丸暗記しにくくなる
- わざと一部を休ませる:学習中にランダムに一部のニューロンを使わない(ドロップアウト)などして、特定の経路に頼りすぎないようにする
実務ではこう使う:「データで決まる」を前提に考える
ニューラルネットワークの仕組みを知ると、AI活用の判断に次のような軸が持てます。
- AIの判断はデータの写し鏡:重みはデータから決まるので、データに偏りがあれば判断にも偏りが出ます。たとえば過去の採用データで学習したモデルは、過去の採用の偏りを引き継ぐおそれがあります。
- 「なぜそう判断したか」は説明しにくい:判断の根拠は数十億の重みに分散しているため、ルールベースのように理由を1行で示すのは困難です。説明が必要な業務では、説明しやすい手法を選んだり、人の確認を組み合わせたりします。
- 社内で独自に学習させるかは慎重に:大きなモデルを一から学習させるには、膨大なデータと計算資源が必要です。多くの企業にとっては、すでに学習済みのモデルを使い、必要に応じて調整する方が現実的です(第7回で扱います)。
社員がこうした基本を押さえておくと、AIツールの導入がスムーズになります。社内向けの学習の場を探す場合は、AI研修のおすすめ比較も参考にしてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- ニューロン1個は「重み付きの足し算→スイッチ(活性化関数)」。それを並べて層にし、層を重ねたものがニューラルネットワーク。
- 重み(パラメータ)がネットワークの「考え方」。パラメータ数は調整つまみの数。
- 学習は「予測→損失を測る→直す方向を調べる→少し直す」の繰り返し。坂を下る勾配降下法で損失を減らす。
- 誤差逆伝播は、ずれの責任を出口から入口へ効率よく割り振る計算方法。
- 学習データの丸暗記(過学習)を避け、新しいデータでも当たることが大事。
確認テスト
Q1. ニューラルネットワークで、活性化関数(スイッチ)を挟む主な理由はどれでしょう?
- 計算を速くするため
- 層を重ねたときに、直線的でない複雑な関係を表せるようにするため
- パラメータ数を減らすため
答えと解説
正解は2。掛け算と足し算だけでは何層重ねても直線的な関係しか表せません。曲がった関数を挟むことで、複雑な関係を表せるようになります。
Q2. 「損失」の説明として正しいものはどれでしょう?
- 学習中に失われたデータの量
- モデルの計算にかかった電気代
- 予測が正解からどれくらい外れているかを表す数値
答えと解説
正解は3。損失は予測と正解のずれを表す数値で、学習はこれを小さくするように重みを調整します。
Q3. 誤差逆伝播と勾配降下法の役割分担として正しいものはどれでしょう?
- 誤差逆伝播で各重みの勾配を計算し、勾配降下法でその方向に重みを少し動かす
- 勾配降下法で予測を出し、誤差逆伝播でデータを集める
- どちらも同じものの別名である
答えと解説
正解は1。誤差逆伝播は「どの重みをどちらに直せばよいか」を効率よく計算する方法で、勾配降下法はその情報を使って実際に重みを更新する方法です。
Q4. 過学習の状態として、最も当てはまるものはどれでしょう?
- 学習データでも新しいデータでも、どちらも成績が悪い
- 学習データではよく当たるのに、新しいデータでは当たらない
- 学習が速く終わりすぎる
答えと解説
正解は2。学習データを丸暗記したような状態で、見たことのないデータに対応できなくなるのが過学習です。検証用データで成績を確かめることで気づけます。
次回予告
第3回では、ニューラルネットワークが「文章」をどうやって扱うのかを見ていきます。言葉を数字に変える「トークン」と「埋め込み(ベクトル)」の考え方が分かると、LLMの入口がはっきり見えてきます。
NEXT|第3回言葉を数字にする:トークンと埋め込み(ベクトル)次の回へ進む →参考資料
- Rumelhart, D. E., Hinton, G. E., Williams, R. J. “Learning representations by back-propagating errors.” Nature 323, 1986.(確認日:2026年11月12日)
- Goodfellow, I., Bengio, Y., Courville, A. “Deep Learning.” MIT Press, 2016.(確認日:2026年11月12日)
- Kingma, D. P., Ba, J. “Adam: A Method for Stochastic Optimization.” arXiv:1412.6980, 2014.(確認日:2026年11月12日)
- Srivastava, N. et al. “Dropout: A Simple Way to Prevent Neural Networks from Overfitting.” JMLR 15, 2014.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較