
画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか|生成AIのしくみ 第8回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第8回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①画像生成AIは「たくさんの画像に共通する特徴の分布」を学び、そこから新しい画像を取り出す仕組みであること、②その主な系譜はVAE・GAN・拡散モデルの3つで、それぞれ得意と苦手が違うこと、③現在の主流である「潜在拡散」や、言葉で画像を指定する仕組みが、どんな積み重ねの上にあるか。
第7回までは、文章を扱うLLMの仕組みを中心に見てきました。今回からは舞台を画像に移します。「夕暮れの海辺を歩く犬、水彩画風」と打ち込むと、それらしい画像が数秒で出てくる。この魔法のような技術は、10年あまりの研究の積み重ねで生まれました。第8回では、まず全体像をつかみ、第9回でGAN、第10回で拡散モデルを詳しく見ていきます。
画像は「数字の巨大な表」
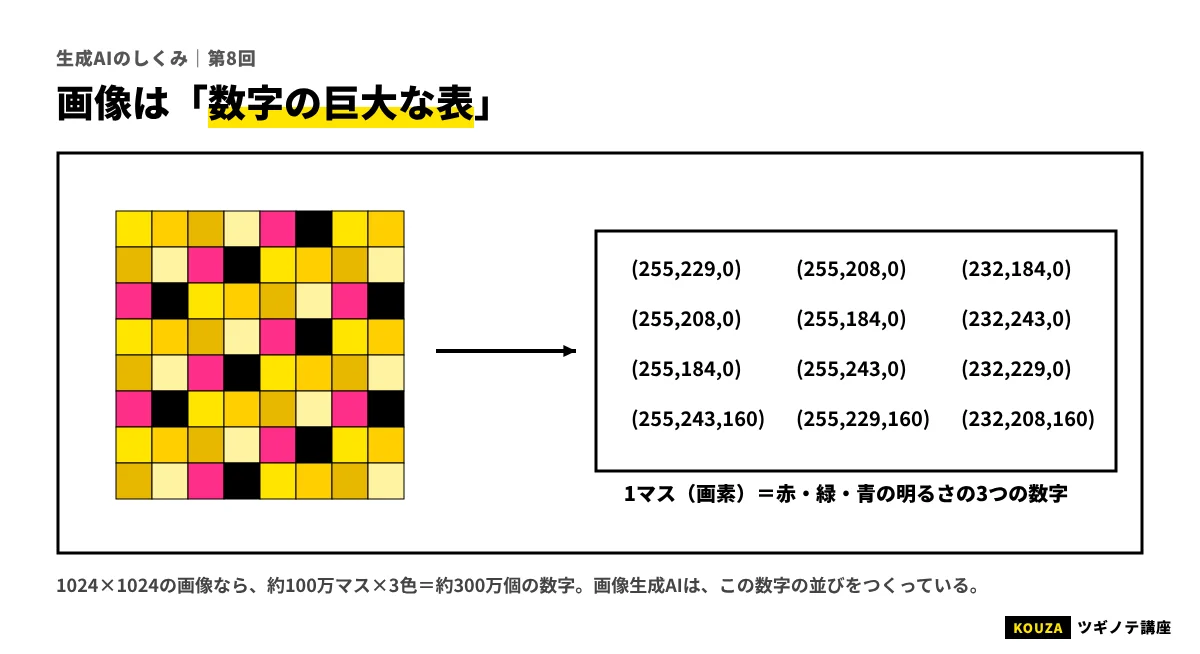
まず、コンピューターにとって画像が何なのかを確認しましょう。デジタル画像は、小さな点(画素、ピクセル)が縦横に並んだもので、各画素は「赤・緑・青」の明るさを表す3つの数値でできています。たとえば縦横512画素の画像なら、512×512×3=約79万個の数値の表です。
画像生成AIの仕事は、この約79万個の数値を、「人が見て意味のある画像」になるように決めることです。ここで問題になるのが、組み合わせの膨大さです。
- 79万個の数値をでたらめに決めると、ほぼ確実に、テレビの砂嵐のようなノイズになる
- 「猫に見える」「風景に見える」数値の組み合わせは、あり得る組み合わせ全体の中では、ごくごく一部にしかない
つまり、画像生成AIは、意味のある画像が集まっている、ごく狭い領域を見つけ出し、そこから新しい1枚を取り出す必要があります。
生成モデルの基本の考え方:「分布」を学ぶ
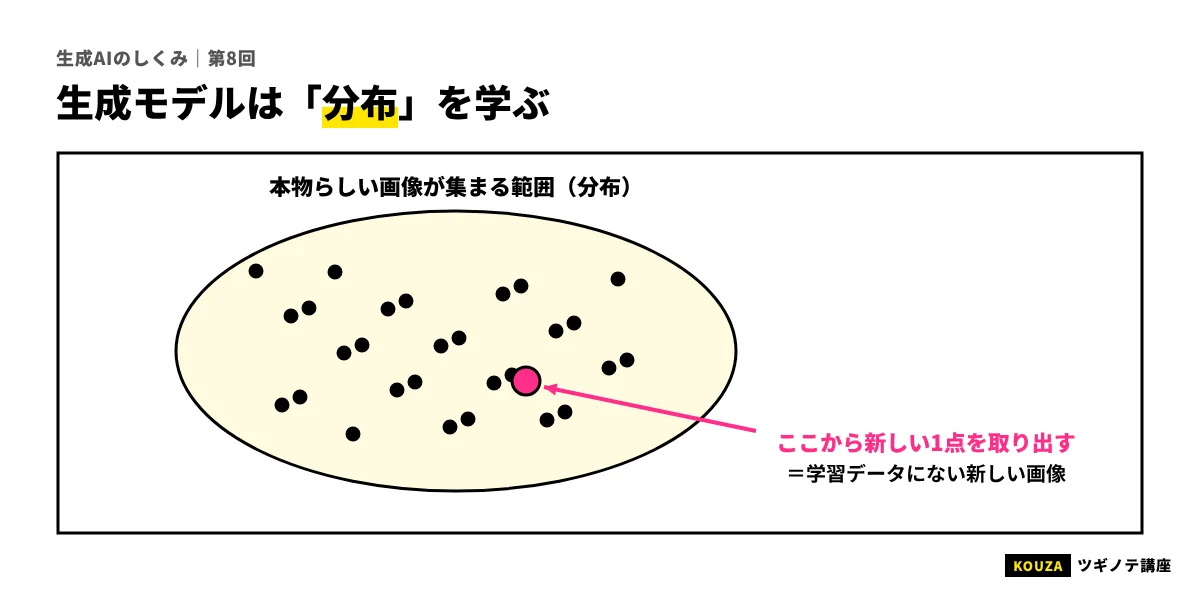
第1回で、生成AIは「見分ける」の逆をやっていると説明しました。画像の場合、生成モデルが学ぶのは、学習した大量の画像が、どんなふうに散らばっているか(分布)です。
たとえるなら、日本中の人の身長と体重を記録して、「この範囲によくいる」という地図をつくるようなものです。地図ができれば、「よくいそうな、でも実在しない架空の人」の身長と体重を、地図に従って1組取り出せます。画像生成AIも同じで、「猫の写真によくある画素の並び方」の地図を学び、そこから実在しない新しい猫の写真を取り出します。ただし、画像の地図は79万次元という、想像を超える広さです。この地図をどう学び、どう取り出すか。その方法の違いが、VAE・GAN・拡散モデルの違いです。
画像生成AIが学んでいるものとして、最も適切な説明はどれでしょう?
- 学習した画像そのものを、1枚ずつそのまま保存している
- 学習した画像がどんな特徴の範囲に散らばっているか(分布)を学び、そこから新しい画像を取り出す
- 画像の数値をでたらめに決めて、たまたま良いものを選んでいる
答えと解説
正解は2。生成モデルは、学習データの分布を学び、その分布に沿った新しい画像を生み出します。でたらめな数値の組み合わせは、ほぼすべてがノイズになってしまいます。
画像生成AIの3つの系譜
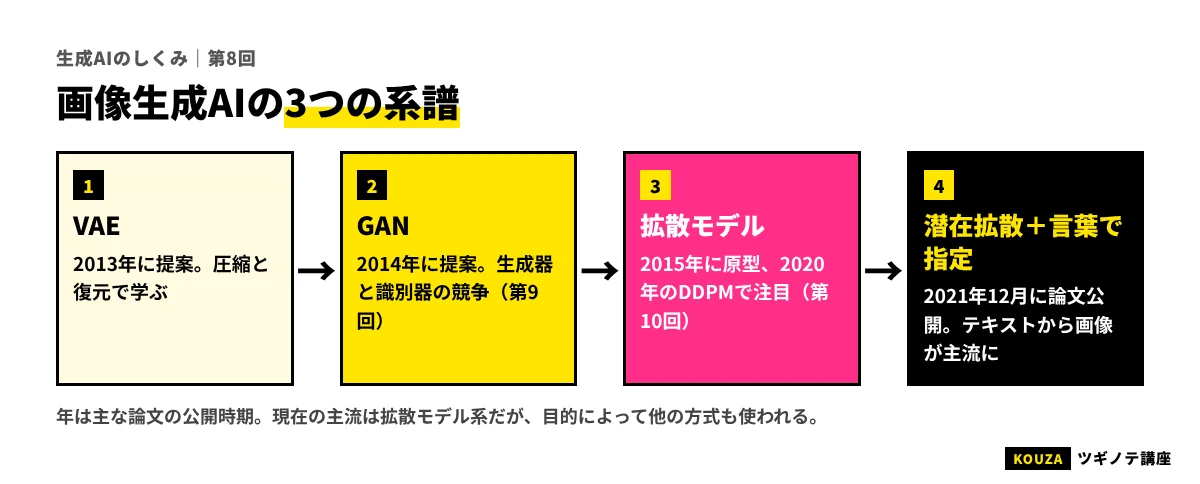
主な手法を、登場した順に並べると次のようになります。
| 手法 | 登場 | ひとことで | 得意 | 苦手 |
|---|---|---|---|---|
| VAE(変分オートエンコーダー) | 2013年 | 画像を小さな「要約」に圧縮し、要約から画像を復元する仕組みを学ぶ | 学習が安定、要約の空間をなめらかに扱える | 画像がぼやけやすい |
| GAN(敵対的生成ネットワーク) | 2014年 | 画像をつくる役と、本物か偽物かを見破る役を競わせる | くっきりした高画質、生成が速い | 学習が不安定、多様性が失われやすい |
| 拡散モデル | 2015年に原型、2020年ごろに実用化 | 画像にノイズを加える過程を逆にたどり、ノイズから画像を少しずつ復元する | 高品質かつ多様、言葉での指定と相性がよい | 生成に何段階もの計算が必要で時間がかかる(改良が進んでいる) |
VAE:圧縮と復元で「要約の空間」を学ぶ
VAEは、2つのネットワークを組み合わせた仕組みです。
- エンコーダー(圧縮役):画像を、数百個程度の数値の「要約」に圧縮する
- デコーダー(復元役):要約から、元の画像を復元する
学習では、「圧縮して復元したら、元の画像に近くなる」ように両方を鍛えます。同時に、要約の空間がなめらかで、すき間のない地図になるような工夫を入れます。こうすると、学習後は、要約の空間から適当な点を選んでデコーダーに渡すだけで、新しい画像をつくれるようになります。
VAEの弱点は、出てくる画像がぼやけやすいことでした。ただし、VAEの「画像を小さな要約の空間に圧縮する」という考え方は、後で見る現在の画像生成AIの中で、重要な部品として生き続けています。
GAN:偽造者と鑑定士の競争
2014年にイアン・グッドフェローらが発表したGANは、画像生成の質を一気に引き上げました。偽札をつくる「偽造者」と、偽札を見破る「鑑定士」を競わせる、という発想です。偽造者は鑑定士をだませるように腕を上げ、鑑定士は見破れるように目を肥やす。このいたちごっこの末に、偽造者は本物そっくりの画像をつくれるようになります。
GANは、2010年代後半に、実在しない人物の顔写真をつくれるほどの品質に到達し、大きな話題になりました。一方で、学習が不安定になりやすく、似た画像ばかり出るようになる問題もありました。詳しくは第9回で扱います。
拡散モデル:ノイズから絵を浮かび上がらせる
拡散モデルは、「きれいな画像に少しずつノイズを加えていくと、最後は完全なノイズになる。その逆の手順を学べば、ノイズから画像をつくれる」という発想の手法です。2020年に発表されたDDPMという研究で高品質な画像が得られることが示され、その後、画像生成の主流になりました。詳しくは第10回で扱います。
GANの基本的なアイデアとして正しいものはどれでしょう?
- 画像をつくる役と、本物か偽物かを見破る役を競わせて、互いに腕を上げさせる
- 画像に少しずつノイズを加え、その逆をたどって画像をつくる
- 画像を小さな要約に圧縮し、要約から復元する
答えと解説
正解は1。GANは生成器(偽造者)と識別器(鑑定士)を競わせる手法です。2はおおまかに拡散モデル、3はVAEの説明です。
現在の主流:潜在空間での拡散と、言葉による指定
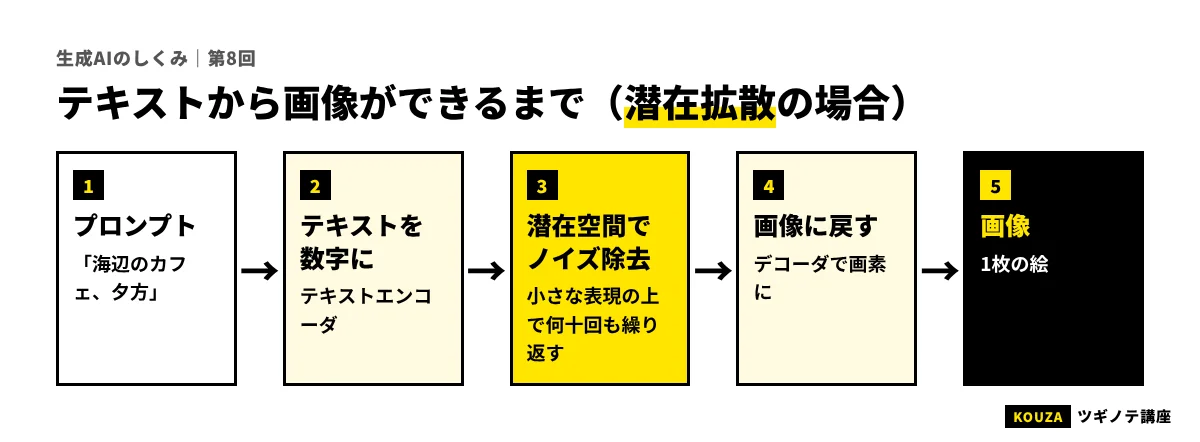
2026年11月時点で広く使われている画像生成AIの多くは、ここまでの系譜を組み合わせた構成をとっています。代表的なのが、2021年12月に論文が公開された「潜在拡散モデル(Latent Diffusion Model)」の考え方で、Stable Diffusionはこの研究をもとに公開されたモデルです。
潜在拡散モデルの構成は、ざっくり次の3つの部品でできています。
- 画像の圧縮・復元役(VAEの仲間):大きな画像を、小さな「潜在空間(要約の空間)」の表現に圧縮し、最後に元の大きさに戻す
- 拡散モデル:画像そのものではなく、小さな潜在空間の中で、ノイズから要約を少しずつ復元する
- 言葉の理解役(テキストエンコーダー):「夕暮れの海辺を歩く犬」という指示を埋め込み(ベクトル)に変換し、拡散モデルに「どんな画像をつくるか」の手がかりとして渡す
大きな画像そのものではなく、小さな要約の空間で拡散の計算を行うことで、必要な計算量を大きく減らせたのがポイントです。これにより、一般的なGPUでも高品質な画像を生成できるようになり、画像生成AIが一気に広がりました。
言葉の理解役には、第3回で見た埋め込みの考え方が使われています。特に、画像と文章を同じ地図の上に並べる「CLIP」という技術が、言葉と画像を結びつけるうえで大きな役割を果たしました(第10回で扱います)。
もう一歩深く
最近は、拡散モデルの中の部品として、第4回で見たTransformerを使う構成(Diffusion Transformerなど)も広く使われています。画像を小さなパッチ(区画)に分け、それをトークンのように扱って注意機構で処理する考え方です。文章のLLMで大規模化の効果が確認されたTransformerを画像生成にも使うことで、モデルを大きくしたときの性能の伸びが期待されています。また、拡散モデル以外に、画像をトークンの列として扱い、LLMのように1トークンずつ予測して画像を生成する方式も研究・実用化されています。
画像生成AIで何ができるか
画像生成AIの使い方は、「言葉から画像をつくる」以外にも広がっています。
| 使い方 | 内容 | 業務の例 |
|---|---|---|
| テキストから画像 | 言葉の指示から画像をつくる | 広告のラフ案、ブログのイメージ画像 |
| 画像から画像 | 元画像の構図を保ちつつ、画風や質感を変える | 手描きラフを清書風に、昼の写真を夜の雰囲気に |
| 部分の描き直し | 指定した範囲だけを描き直す(インペインティング) | 不要な物を消す、服の色だけ変える |
| 画像の拡張 | 画像の外側を描き足す(アウトペインティング) | 横長バナーへの変換 |
| 高解像度化 | 粗い画像をきめ細かくする | 古い素材の画質向上 |
よくある誤解:画像生成AIは、ネット上の画像を検索して切り貼りしている
画像生成AIは、学習した分布から新しい画像を生成しているので、基本的には検索して切り貼りしているわけではありません。ただし、学習データに何度も出てくる有名な画像やキャラクターに非常に近い画像が出力されてしまうことはありえます。この点が、第12回で扱う著作権の議論につながります。
実務ではこう使う:画像生成AIを選ぶ・使うときの観点
- 商用利用の条件を確認する:サービスごとに、生成画像を商用で使ってよいか、どの範囲で使えるかの規約が異なります。必ず最新の利用規約を確認します。
- 既存の作品やブランドに似せない:特定の作品・キャラクター・ロゴに似せる指示は、権利侵害のリスクを高めます(文化庁の整理では、作風などアイデアが似ているだけでは著作権侵害の「類似性」は認められないとされていますが、具体的な表現が似れば問題になりえます)。
- 人の目で最終確認する:手の指の本数、文字のゆがみ、不自然な影など、画像生成AI特有の崩れがないかを確認します(近年のモデルでは大きく改善していますが、ゼロではありません)。
- 用途に合ったツールを選ぶ:イラスト、写真風、デザイン素材、動画など、ツールごとに得意分野が異なります。
動画まで含めた生成ツールの選び方は、AI動画生成ツールのおすすめ比較も参考にしてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 画像は数十万〜数百万個の数値の表。意味のある画像は、あり得る組み合わせのごく一部にしかない。
- 画像生成AIは、学習した画像の分布を学び、そこから新しい画像を取り出す。
- 主な系譜はVAE(圧縮と復元)、GAN(偽造者と鑑定士の競争)、拡散モデル(ノイズから復元)の3つ。
- 現在の主流は、要約の空間(潜在空間)で拡散を行い、言葉の理解役で指示を反映する構成。Transformerを部品に使う構成も広がっている。
- 生成画像の商用利用条件や権利、崩れのチェックは、使う側の責任で確認する。
確認テスト
Q1. VAE・GAN・拡散モデルのうち、「生成した画像がぼやけやすい」とされてきたのはどれでしょう?
- GAN
- 拡散モデル
- VAE
答えと解説
正解は3。VAEは学習が安定している一方、生成画像がぼやけやすいことが弱点とされてきました。ただし、画像を潜在空間に圧縮する部品として、現在の画像生成AIでも使われています。
Q2. 潜在拡散モデルが、画像そのものではなく「潜在空間」で拡散の計算を行う主な理由はどれでしょう?
- 画像の色を白黒にするため
- 小さな要約の空間で計算することで、必要な計算量を大きく減らすため
- 言葉の指示を無視するため
答えと解説
正解は2。大きな画像そのもので拡散を行うと計算量が膨大になります。圧縮した潜在空間で計算することで、一般的なGPUでも高品質な画像を生成できるようになりました。
Q3. テキストから画像をつくる仕組みで、「言葉の理解役(テキストエンコーダー)」の役割はどれでしょう?
- 指示の文章を埋め込みに変換し、どんな画像をつくるかの手がかりとして拡散モデルに渡す
- 完成した画像に文字を書き込む
- 画像を高解像度にする
答えと解説
正解は1。テキストエンコーダーは、指示の文章をベクトルに変換して、生成の方向づけに使えるようにします。言葉と画像を結びつけるCLIPのような技術が、ここで重要な役割を果たしてきました。
Q4. 画像生成AIを業務で使うときの注意点として、最も適切なものはどれでしょう?
- 生成画像はAIがつくったので、どんな用途にも自由に使える
- 有名キャラクターに似せるほど、権利のリスクは下がる
- サービスごとの商用利用の条件を確認し、既存の作品やブランドに似せる指示は避ける
答えと解説
正解は3。生成画像の利用条件はサービスによって異なり、既存の作品やキャラクターに似た画像は権利侵害のリスクがあります。利用規約の確認と、人による最終チェックが欠かせません。
次回予告
第9回では、画像生成の質を一気に引き上げたGANを詳しく見ていきます。偽造者と鑑定士の「いたちごっこ」はどう進むのか。なぜ学習が不安定になるのか。実在しない顔写真をつくったStyleGANまで、仕組みと歴史を追いましょう。
参考資料
- Kingma, D. P., Welling, M. “Auto-Encoding Variational Bayes.” arXiv:1312.6114, 2013.(確認日:2026年11月12日)
- Goodfellow, I. et al. “Generative Adversarial Networks.” arXiv:1406.2661, 2014.(確認日:2026年11月12日)
- Sohl-Dickstein, J. et al. “Deep Unsupervised Learning using Nonequilibrium Thermodynamics.” arXiv:1503.03585, 2015.(確認日:2026年11月12日)
- Ho, J., Jain, A., Abbeel, P. “Denoising Diffusion Probabilistic Models.” arXiv:2006.11239, 2020.(確認日:2026年11月12日)
- Rombach, R. et al. “High-Resolution Image Synthesis with Latent Diffusion Models.” arXiv:2112.10752, 2021.(確認日:2026年11月12日)
- Peebles, W., Xie, S. “Scalable Diffusion Models with Transformers.” arXiv:2212.09748, 2022.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較