
音声・動画・マルチモーダル:文字以外を扱う生成AI|生成AIのしくみ 第11回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第11回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①音声認識・音声合成・動画生成も、これまで見てきた「トークン化」「Transformer」「拡散モデル」の考え方の応用であること、②文章・画像・音声などを1つのモデルでまとめて扱うのが「マルチモーダル」なAIであること、③それぞれの技術の、業務での使いどころと注意点。
第3回から第10回まで、文章を扱うLLMと、画像を扱う拡散モデルを中心に見てきました。今回は、それ以外の情報、つまり音声と動画を扱う生成AI、そして複数の種類の情報をまとめて扱う「マルチモーダル」なAIを取り上げます。新しい仕組みが次々に出てくるように見えますが、実はここまでの講座で学んだ部品の組み合わせで、かなりの部分が説明できます。この回は、これまでの総復習のつもりで読んでみてください。
音声は「波」の数字
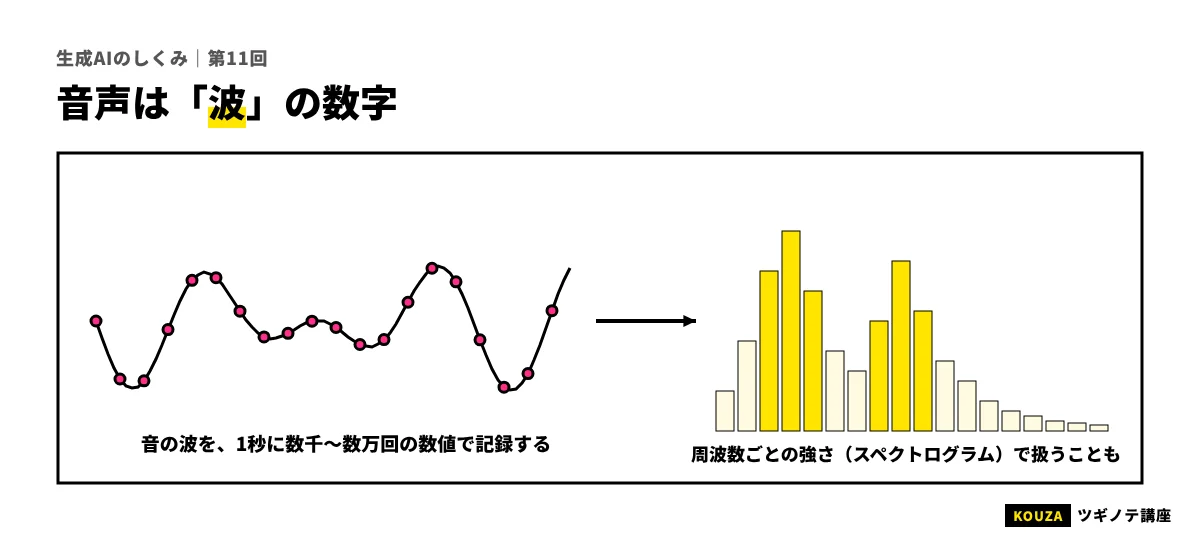
まず、音声がコンピューターの中でどう表されているかを確認しましょう。音は空気の振動、つまり波です。マイクで録音すると、この波の高さを、1秒間に何千〜何万回も測った数値の列として記録します。たとえば1秒間に1万6千回測るなら、1秒の音声は1万6千個の数値です。
画像が「縦横に並んだ数値の表」だったのに対して、音声は「時間に沿って並んだ長い数値の列」です。そのままでは長すぎて扱いにくいため、多くの音声AIでは、音を短い区間に区切り、それぞれの区間にどの高さの音がどれくらい含まれているかを表した図(スペクトログラム)に変換してから扱います。スペクトログラムは、横軸が時間、縦軸が音の高さ、色の濃さが音の強さを表す「音の楽譜」のようなもので、画像に近い形になります。
音声認識:声を文字にする
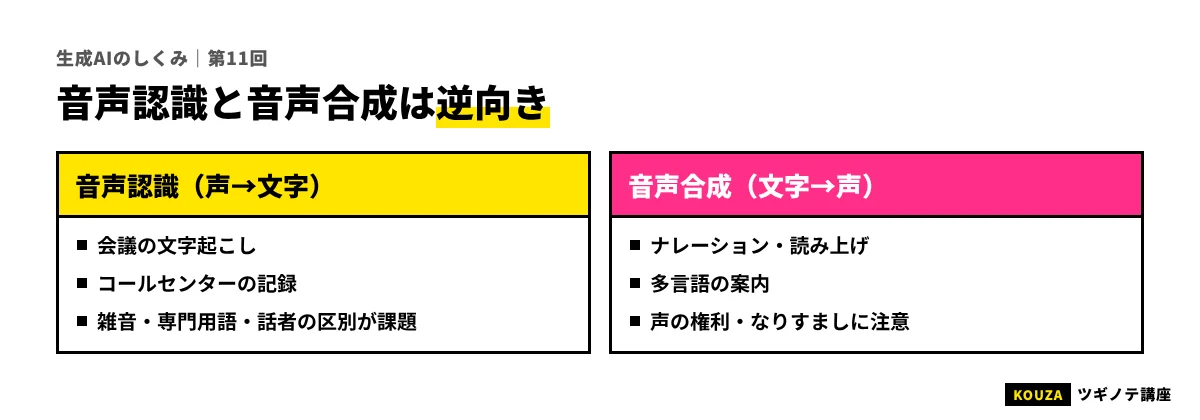
音声認識(Speech-to-Text)は、話し言葉を文字に変換する技術です。会議の議事録、コールセンターの通話の記録、動画の字幕など、業務での使い道が広い分野です。
仕組みのおおまかな流れ
現在の音声認識の多くは、第4回で見たTransformerを使った構成をとっています。たとえば2022年にOpenAIが発表したWhisperは、次のような流れで文字起こしを行います。
- 音声をスペクトログラムに変換する
- エンコーダー(理解役)が、スペクトログラムを読み込み、音の特徴を表すベクトルの列に変換する
- デコーダー(書き手役)が、その特徴を参照しながら、文字のトークンを1つずつ予測して書き出していく
3の部分は、LLMが次のトークンを予測するのとよく似ています。違いは、デコーダーが「それまでに書いた文字」だけでなく、「音の特徴」にも注意を向けながら次のトークンを選ぶ点です。Whisperの論文では、インターネット上から集めた約68万時間の音声と書き起こしのペアで学習したことが報告されています。
業務での注意点
- 固有名詞や専門用語に弱いことがある:社名、商品名、業界用語は、学習データに少ないため誤変換されやすい。多くのサービスには、単語を登録して認識させる機能がある
- 録音環境の影響が大きい:雑音、複数人の同時発話、マイクからの距離で精度が大きく変わる
- 「誰が話したか」は別の技術:話者を区別する機能(話者分離)は、文字起こしとは別の処理で、精度にばらつきがある
- 聞き取れない部分を補ってしまうことがある:第6回のハルシネーションと同様、音が不明瞭な部分に、もっともらしい文章を書き足してしまう現象が報告されている
Transformerを使った音声認識の仕組みとして、最も適切なものはどれでしょう?
- 録音した音声と同じ音の単語を辞書から順番に探して並べる
- 音の特徴をベクトルの列に変換し、それを参照しながら文字のトークンを1つずつ予測して書き出す
- 人が聞き取った内容を、AIが清書している
答えと解説
正解は2。エンコーダーが音の特徴をベクトルに変換し、デコーダーがそれに注意を向けながら、LLMと同じように次のトークンを予測していきます。
音声合成:文字を声にする
音声合成(Text-to-Speech)は、文章を読み上げる音声をつくる技術です。カーナビやスマートスピーカーの声のほか、動画のナレーション、電話の自動応答(ボイスボット)などで使われています。
かつての音声合成は、録音した音声の断片をつなぎ合わせる方式が中心で、つなぎ目が不自然になりがちでした。ディープラーニングの登場で、文章から、声の特徴(スペクトログラムなど)を予測し、それを波形に変換する方式が主流になり、人の声と聞き分けにくいほど自然になりました。
最近の音声合成では、音声を「音声トークン」という単位に変換し、LLMと同じように次の音声トークンを予測して声を組み立てる方式や、拡散モデルを使う方式なども使われています。文章をトークンにしたのと同じ発想で、音声もトークンにしてしまえば、LLMの仕組みがそのまま使える、というわけです。
声のクローンと、その危うさ
数秒〜数分の録音から、特定の人の声色をまねて話させる技術(ボイスクローン)も実用化されています。ナレーションの作成や、声を失った人の支援など、よい使い道がある一方で、次のような悪用も問題になっています。
- 家族や上司の声をまねた電話で、送金をさせる詐欺
- 著名人の声で、本人が言っていない発言をつくる
業務で使う場合は、本人の同意を得た声だけを使うこと、そして電話や音声メッセージだけで本人確認や送金の判断をしない運用が大切です。
動画生成:時間方向に一貫した画像の連なり
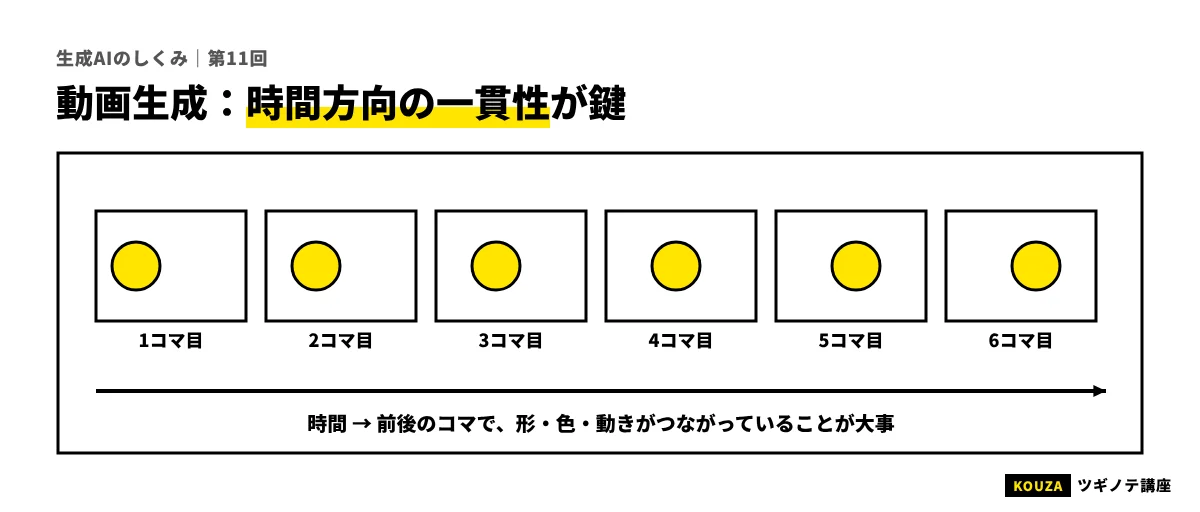
動画は、静止画(フレーム)を1秒間に数十枚並べたものです。動画生成AIは、ただ画像を何枚もつくるのではなく、フレームとフレームの間で、物の形や動きが自然につながるようにつくる必要があります。人物が歩いている途中で顔が変わったり、物が消えたりしてはいけません。
現在の動画生成AIの多くは、第8回・第10回で見た拡散モデルの考え方を、時間方向に拡張しています。
- 動画を、空間(縦横)と時間の3方向に区切った小さなかたまり(パッチ)に分け、それをトークンのように扱う
- 画像のときと同じく、ノイズから少しずつノイズを取り除いて動画を浮かび上がらせる
- ノイズを予測するネットワークにTransformerを使い、空間方向だけでなく時間方向の関係にも注意を向けることで、フレーム間のつながりを保つ
テキストからの動画生成のほか、1枚の画像を動かす、動画のスタイルを変える、といった使い方も広がっています。
もう一歩深く
動画は画像に比べて、扱うデータの量が桁違いに多くなります。数秒の動画でも、数十〜数百枚分の画像に相当します。そのため、第8回で見た「潜在空間に圧縮してから拡散する」工夫が、動画ではさらに重要になります。それでも計算量は膨大で、長い動画を一貫性を保って生成すること、物理的に正しい動き(物が落ちる、液体が流れる)を再現することは、2026年11月時点でも研究と改良が続いている課題です。
動画生成AIで、画像生成にはない難しさとして最も適切なものはどれでしょう?
- フレーム間で、物の形や動きを自然につなげる(時間方向の一貫性を保つ)必要がある
- 色を表現する必要がある
- 指示文を読み取る必要がある
答えと解説
正解は1。動画では、たくさんのフレームの間で、人物や物の形・動きが自然につながっている必要があります。そのため、時間方向の関係にも注意を向ける仕組みが使われています。
マルチモーダル:1つのモデルで、いくつもの感覚を
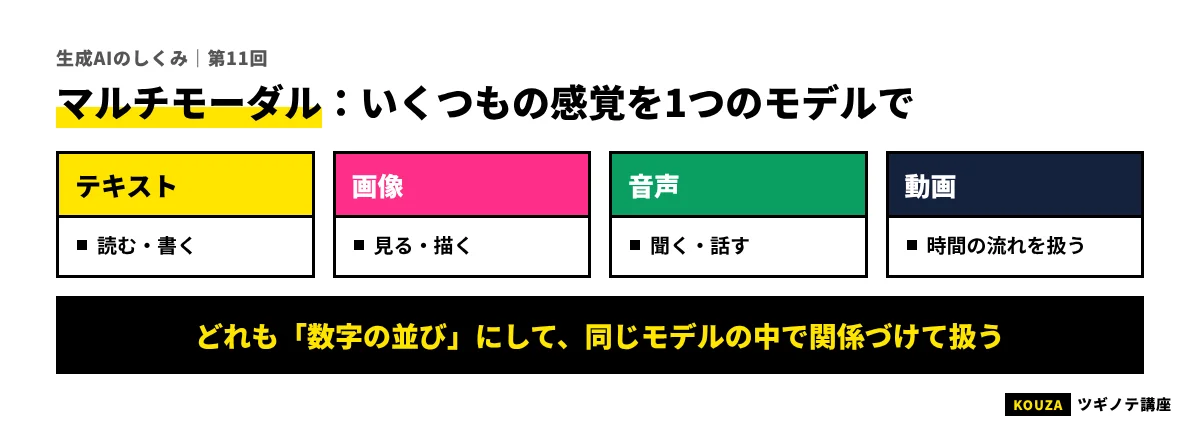
ここまで、文章・画像・音声・動画を別々に見てきました。最近の大きな流れは、これらを1つのモデルでまとめて扱うことです。複数の種類(モード)の情報を扱えることを「マルチモーダル」と呼びます。
2026年11月時点の主要なチャット型AIの多くは、画像を見せて質問したり、音声で会話したり、資料のPDFを読ませたりできるようになっています。
仕組みの基本:何でも「トークン」にして、同じ地図に並べる
マルチモーダルなAIの基本的な考え方は、これまでの講座の総まとめのようなものです。
| 情報の種類 | トークンへの変換 | 参考になった回 |
|---|---|---|
| 文章 | トークナイザーで区切り、埋め込みに変換 | 第3回 |
| 画像 | 小さな区画(パッチ)に分け、それぞれを埋め込みに変換 | 第8回 |
| 音声 | 短い区間に区切り、音の特徴をトークンや埋め込みに変換 | この回 |
| 動画 | 空間と時間で区切ったパッチを埋め込みに変換 | この回 |
すべての情報を「埋め込みの列」に変換してしまえば、第4回で見たTransformerは、それが元は文章だったのか画像だったのかを区別せず、まとめて注意の計算ができます。「この写真の左側に写っている看板には何と書いてある?」という質問なら、質問文のトークンが、画像のパッチのうち左側の看板の部分に注意を向ける、というわけです。第10回で見たCLIPのように、異なる種類の情報を同じ地図の上に並べる研究の積み重ねが、これを可能にしました。
構成はモデルによってさまざまで、画像用の部品で変換した情報をLLMに渡す方式もあれば、最初から複数の種類の情報をまとめて学習する方式もあります。
マルチモーダルAIでできること
- 手書きのメモやホワイトボードの写真を読み取って、議事録やタスク一覧にする
- グラフや表の画像を読み取って、数値を要約する
- 商品の写真から、説明文やタグの案をつくる
- 画面の写真を見せて、操作方法やエラーの原因を聞く
- 音声で話しかけ、音声で答えてもらう
よくある誤解:画像を「見て」答えているのだから、写っている内容は正確に読み取れている
マルチモーダルAIは画像の内容を理解して答えますが、細かい文字、数値の読み取り、物の数え上げ、位置関係などで誤ることがあります。また、画像に写っていないことを、文脈から推測して答えてしまうこともあります(第6回のハルシネーションの画像版)。帳票の数値など、正確さが必要な読み取りは、人の確認を前提にしましょう。
実務ではこう使う:音声・動画・マルチモーダルの使いどころ
| 技術 | 向いている業務 | 確認したいこと |
|---|---|---|
| 音声認識 | 会議の議事録、通話の記録、字幕 | 専門用語の登録機能、話者分離の精度、データの保存場所 |
| 音声合成 | 動画のナレーション、電話の自動応答 | 声の権利と同意、商用利用の条件 |
| 動画生成 | 広告・SNS用の短い動画、イメージ映像 | 生成物の商用利用条件、人物や商標の扱い |
| マルチモーダル | 写真・資料の読み取り、画面を見せての質問 | 数値や細かい文字の読み取り精度、機密情報の扱い |
それぞれのツール選びには、AI動画生成ツールのおすすめ比較、法人向け生成AIツールのおすすめ比較も参考にしてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 音声は時間に沿った数値の列。スペクトログラムという「音の楽譜」に変換して扱うことが多い。
- 音声認識は、音の特徴に注意を向けながら文字のトークンを予測するTransformerの応用。固有名詞や雑音に弱く、聞き取れない部分を補ってしまうこともある。
- 音声合成は人の声と聞き分けにくい品質になった。声のクローンには、同意と悪用への備えが必要。
- 動画生成は、拡散モデルを時間方向に拡張し、フレーム間の一貫性を保つ。長さや物理的な正しさは今も課題。
- マルチモーダルAIは、あらゆる情報をトークン(埋め込み)に変換し、Transformerでまとめて扱う。細かい読み取りは人の確認を前提に。
確認テスト
Q1. スペクトログラムの説明として正しいものはどれでしょう?
- 音声を文字に書き起こしたもの
- 話している人の顔写真
- 音を短い区間に区切り、どの高さの音がどれくらい含まれるかを表した「音の楽譜」のような図
答えと解説
正解は3。スペクトログラムは横軸が時間、縦軸が音の高さ、濃さが音の強さを表す図で、画像に近い形で音声を扱えるようにします。
Q2. ボイスクローン(声のまね)技術を業務で使うときの注意として、最も適切なものはどれでしょう?
- 本人の同意を得た声だけを使い、電話や音声だけで本人確認や送金の判断をしない
- 著名人の声なら、断りなく自由に使ってよい
- 声は個人を特定できないので、特に注意はいらない
答えと解説
正解は1。声をまねた詐欺やなりすましが問題になっています。本人の同意の確認と、音声だけで重要な判断をしない運用が大切です。
Q3. マルチモーダルAIが、文章と画像をまとめて扱える基本的な理由はどれでしょう?
- 画像をすべて文字に書き換えてから読んでいるから
- 文章も画像も埋め込み(トークン)の列に変換し、Transformerでまとめて注意を計算できるから
- 文章用と画像用のAIが、人を介して会話しているから
答えと解説
正解は2。どんな情報でも埋め込みの列に変換してしまえば、Transformerは区別なく注意の計算ができます。これがマルチモーダルAIの基本的な考え方です。
Q4. マルチモーダルAIに請求書の画像を読み取らせて金額を集計したい。最も適切な運用はどれでしょう?
- AIが画像を見ているので、読み取った金額はそのまま使ってよい
- 画像の解像度を下げてから読み取らせる
- 細かい数値は誤読の可能性があるため、元の帳票と照らし合わせる確認の手順を入れる
答えと解説
正解は3。マルチモーダルAIは、細かい文字や数値の読み取りで誤ることがあります。金額など正確さが必要な情報は、人の確認を前提に運用しましょう。
次回予告
いよいよ最終回です。第12回では、生成AIを使う側が知っておくべき、著作権・個人情報・安全性の論点と、国内外のルールづくりの動き、そしてこれからの生成AIの展望をまとめます。
参考資料
- Radford, A. et al. “Robust Speech Recognition via Large-Scale Weak Supervision.”(Whisper)arXiv:2212.04356, 2022.(確認日:2026年11月12日)
- van den Oord, A. et al. “WaveNet: A Generative Model for Raw Audio.” arXiv:1609.03499, 2016.(確認日:2026年11月12日)
- Shen, J. et al. “Natural TTS Synthesis by Conditioning WaveNet on Mel Spectrogram Predictions.”(Tacotron 2)arXiv:1712.05884, 2017.(確認日:2026年11月12日)
- Dosovitskiy, A. et al. “An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale.”(ViT)arXiv:2010.11929, 2020.(確認日:2026年11月12日)
- Ho, J. et al. “Video Diffusion Models.” arXiv:2204.03458, 2022.(確認日:2026年11月12日)
- Alayrac, J.-B. et al. “Flamingo: a Visual Language Model for Few-Shot Learning.” arXiv:2204.14198, 2022.(確認日:2026年11月12日)
- Liu, H. et al. “Visual Instruction Tuning.”(LLaVA)arXiv:2304.08485, 2023.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較