
LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック|生成AIのしくみ 第5回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第5回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①LLMは「事前学習」で大量の文章から言葉と知識のパターンを学ぶこと、②そのままでは「文章の続きを書く機械」なので、指示に従うよう「指示チューニング」で調整されること、③さらに人の評価を使った調整(RLHFなど)で、役に立ち、害の少ない答えを返すよう仕上げられること。
前回は、LLMの器であるTransformerの仕組みを見ました。しかし、器があるだけでは何もできません。生まれたばかりのTransformerの重みはランダムな数値で、でたらめなトークンを出すだけです。今回は、この器に知識と会話の能力を身につけさせ、ChatGPTやClaudeのような「話の通じるアシスタント」に育てる流れを見ていきます。
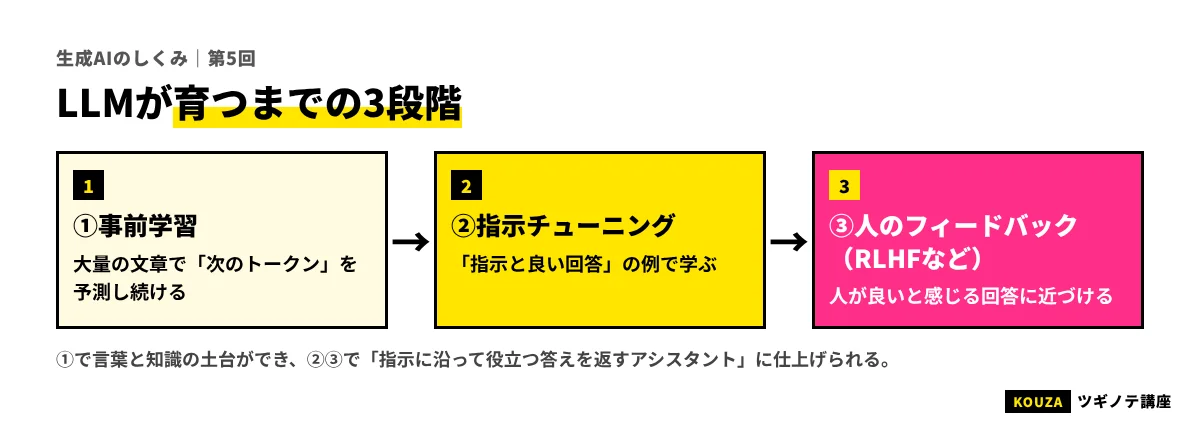
LLMが育つまでの3つの段階
現在のチャット型LLMの多くは、ざっくり次の3段階を経て育てられます(細かい手順や名前は開発元によって異なります)。
| 段階 | 何をするか | たとえ | 結果 |
|---|---|---|---|
| ①事前学習 | 膨大な文章で「次のトークン予測」を学ぶ | 図書館の本を片っ端から読み込む | 言葉と知識の幅広いパターンを身につけた「物知りな予測マシン」 |
| ②指示チューニング | 「指示と模範解答」の例で追加学習する | 先輩の模範解答を見て、仕事の受け答えを覚える | 質問や指示に答える形で話せるようになる |
| ③人のフィードバックによる調整 | どちらの答えがよいかの評価をもとに調整する | 上司の評価を受けて、より好ましい対応に磨く | 役に立ち、誠実で、害の少ない答えに近づく |
1つずつ見ていきましょう。
①事前学習:「次のトークン予測」だけで、なぜ賢くなるのか
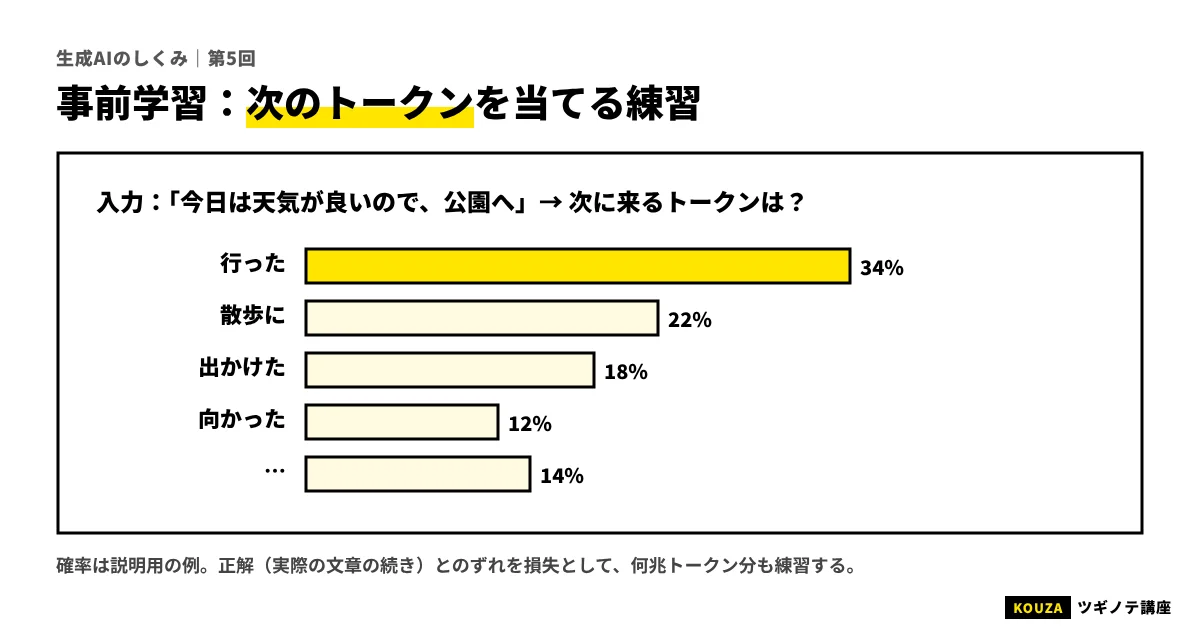
事前学習でやることは、驚くほど単純です。インターネット上の文章、書籍、論文、プログラムのコードなど、膨大なテキストを用意し、次のような穴埋め問題を延々と解かせます。
- 「日本の首都は」→ 次は?(正解:「東京」)
- 「水は100度で」→ 次は?(正解:「沸騰」)
- 「def add(a, b):」→ 次は?(正解:「return a + b」に続くトークン)
正解は、元の文章の次のトークンそのものなので、人がいちいち正解のラベルを付ける必要がありません。文章さえあれば、いくらでも問題をつくれます。このように、データ自身から問題と正解をつくって学ぶ方法を「自己教師あり学習」と呼びます。
予測が外れたら、第2回で見た誤差逆伝播と勾配降下法で、重みを少しずつ直します。これを、数兆トークン規模とも言われる大量のテキストで繰り返します。
予測がうまくなるには、世界を「理解」する必要がある
「次の言葉を当てるだけで、なぜ質問に答えたり、要約したりできるようになるのか」は、多くの人が抱く疑問です。
ヒントは、次の言葉をうまく当てるには、文章の裏にある文法・事実・論理・常識まで、ある程度とらえる必要があることです。推理小説の最後の一文「犯人は」の次を当てるには、物語全体の筋を追う必要があります。「12×12=」の次を当てるには、かけ算のパターンを身につける必要があります。予測という単純な課題を、膨大な量の多様な文章で解かせ続けることで、モデルの中に言葉や知識のさまざまなパターンが形づくられていくと考えられています。
ただし、それが人間と同じ意味での「理解」なのかどうかは、研究者の間でも議論が続いています。この講座では、「人間の理解と同じとは言い切れないが、多くの課題で役に立つほど豊かなパターンを身につけている」という見方をとります。
事前学習で、人が1つずつ正解ラベルを付ける必要がないのはなぜでしょう?
- AIが正解を自分で考え出すから
- 元の文章の「次のトークン」そのものが正解になるから
- 事前学習では正解を使わないから
答えと解説
正解は2。文章の一部を見せて次のトークンを当てさせれば、元の文章がそのまま答え合わせになります。このようにデータ自身から問題と正解をつくる学び方を「自己教師あり学習」と言います。
大きくすると、性能が予測どおりに伸びる:スケーリング則
2020年ごろ、モデルの大きさ(パラメータ数)、学習データの量、計算量を増やすと、予測の誤り(損失)がなめらかに、かなり予測可能な形で下がっていくことが、研究で報告されました。これを「スケーリング則」と呼びます。この発見が、より大きなモデルに巨額の計算資源を投じる流れを後押ししました。
また、モデルを大きくするにつれて、小さなモデルではほとんどできなかった課題(複数の手順が必要な計算など)が急にできるようになるように見える現象も報告され、「創発的能力」として話題になりました。ただし、これは性能の測り方によって見え方が変わる、という指摘もあり、評価は分かれています。
もう一歩深く
2022年には、同じ計算予算なら、パラメータ数だけを大きくするより、学習データのトークン数もそれに見合うだけ増やした方が効率がよい、という研究(いわゆるChinchillaの研究)が発表され、モデル開発の方針に影響を与えました。現在は、使うときの計算コストを抑えるため、あえて小さめのモデルに大量のデータを学習させる方針もよく見られます。
②指示チューニング:「続きを書く機械」を「アシスタント」にする
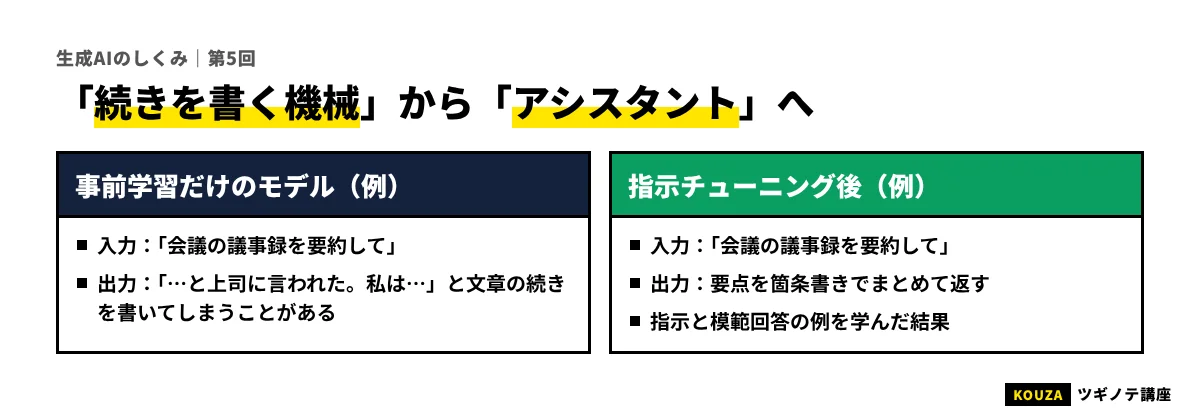
事前学習を終えたモデルは、物知りではありますが、そのままでは使いにくい存在です。たとえば「日本の首都はどこですか?」と入力すると、答えを返す代わりに「日本の首都はどこですか? 次の問題:アメリカの首都は……」と、クイズ集の続きを書き始めてしまうかもしれません。事前学習のモデルは「質問に答える」のではなく、「ありそうな続きを書く」ように学んでいるからです。
そこで、「指示」と「よい応答」の組み合わせを数多く用意し、それを使って追加で学習させます。これを「指示チューニング(教師ありファインチューニング)」と呼びます。
| 指示 | よい応答の例 |
|---|---|
| 次の文章を3行で要約してください。(本文) | 要点を3行にまとめた文章 |
| 新商品のキャッチコピーを5案ください。 | 5つの案を箇条書きで |
| この文の誤字を直してください。(本文) | 修正後の文と、直した箇所の説明 |
こうした例を学ぶことで、モデルは「入力は指示であり、それに応える形で書く」という振る舞いを身につけます。例の数は、事前学習の文章量に比べればずっと少なくて済むとされています。土台となる知識は事前学習ですでに身についているため、「受け答えの型」を覚えさせるだけで大きく変わるのです。
③人のフィードバックによる調整:RLHF
指示に答えられるようになっても、まだ課題が残ります。同じ質問への答え方には、「分かりやすい/分かりにくい」「正確/不正確」「丁寧/失礼」「安全/危険」など、よしあしの幅があります。こうした微妙な好ましさは、模範解答を1つ見せるだけでは伝えきれません。
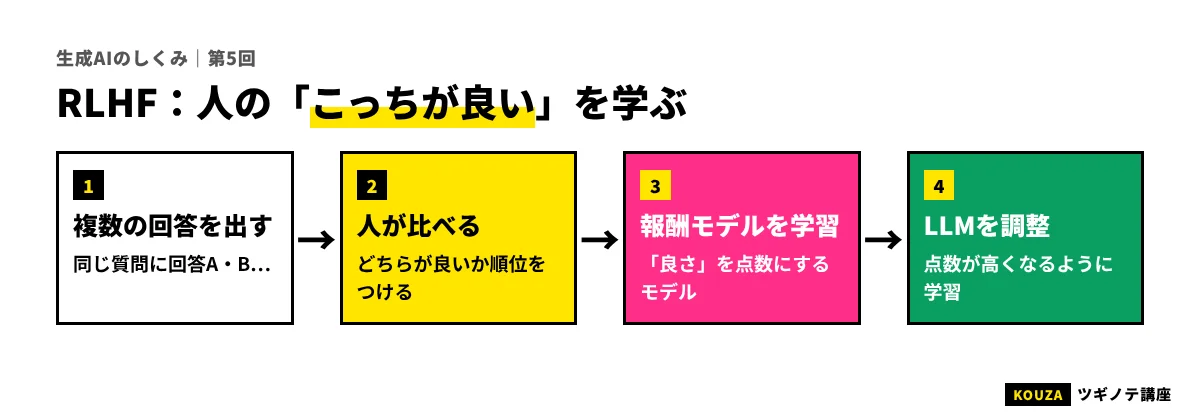
そこで使われるのが「人間のフィードバックによる強化学習(RLHF)」と呼ばれる方法です。2022年に発表された、指示に従うよう調整したGPT-3(InstructGPT)の研究などで広く知られるようになりました。流れは次のとおりです。
- 比べる:同じ指示に対してモデルに複数の答えを出させ、人がどれがよいか順位を付ける
- 評価役を育てる:その順位データから、「答えのよさを点数で予測するモデル(報酬モデル)」を学習させる
- 点数が上がるよう調整する:LLMに答えを出させ、報酬モデルの点数が高くなる方向に、強化学習という方法で重みを調整する
たとえるなら、新人(LLM)の対応を、ベテラン(人)が何百件も見比べて評価し、その評価のクセを覚えた指導係(報酬モデル)が、新人の練習に毎回点数を付けて指導する、という仕組みです。人が毎回すべての練習に付き添わなくても、指導係が代わりに評価できるのがポイントです。
RLHFで「報酬モデル」が果たす役割はどれでしょう?
- LLMの代わりに、ユーザーへの答えを書く
- 学習データの文章を集めてくる
- 人の評価のクセを学び、答えのよさを点数で評価する指導係になる
答えと解説
正解は3。報酬モデルは、人が付けた順位のデータから「どんな答えが好まれるか」を学び、LLMの答えに点数を付けます。LLMはその点数が高くなるように調整されます。
RLHFの仲間と、その限界
RLHFのほかにも、人の好みのデータから報酬モデルをつくらずに直接調整する方法(DPOなど)や、AI自身が原則(憲法のような行動指針)に照らして答えを評価・修正する方法(Anthropicが発表した「Constitutional AI」など)が提案されています。開発元によって、どの方法をどう組み合わせているかは異なり、詳細が公開されていない部分も多くあります。
また、人の評価にもとづく調整には限界もあります。
- 評価する人の好みに寄る:自信満々で長い答えが、正しさに関係なく高く評価されてしまう、といった偏りが入りうる
- 相手に合わせすぎる:ユーザーの意見に同調しすぎる傾向(迎合)が生まれることがある、と指摘されている
- 正しさそのものは保証されない:調整で答え方は磨かれても、事前学習で身についた知識の誤りがすべて直るわけではない
よくある誤解:チャット型AIは、人が書いた答えを検索して返している
ここまで見てきたように、LLMの答えは、事前学習で身につけたパターンと、調整で身につけた答え方にもとづいて、その場で1トークンずつ生成されたものです。検索機能を組み合わせたサービスもありますが(第7回で扱います)、LLM自体は「どこかにある正解を取り出している」わけではありません。
実務ではこう使う:育ち方を知ると、使い方が変わる
- 「知っていること」には期限がある:事前学習のデータには、収集した時点(知識のカットオフ)があります。それ以降の出来事は、検索などの仕組みがない限り知りません。最新情報が必要なときは、検索機能のあるサービスを使うか、資料を一緒に渡します。
- 答えのうまさと正しさは別物:人の評価で磨かれた答えは、読みやすく自信にあふれて見えます。だからこそ、数字や固有名詞、法令などは必ず一次情報で確かめる運用が必要です。
- 自社向けの調整は「受け答えの型」から考える:社内の言葉づかいや回答形式に合わせたい場合、一から学習させるのではなく、指示の工夫や、第7回で扱う追加学習・RAGを検討します。
自社に合うツールや、導入を支援してくれる会社を探す場合は、AI導入支援のおすすめ比較も参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- LLMは、①事前学習、②指示チューニング、③人のフィードバックによる調整、の段階を経て育てられる。
- 事前学習は「次のトークン予測」を膨大な文章で繰り返す自己教師あり学習。予測がうまくなる過程で、言葉や知識の豊かなパターンが身につく。
- モデル・データ・計算を大きくすると性能が予測どおりに伸びる「スケーリング則」が、大規模化を後押しした。
- 指示チューニングで「続きを書く機械」を「指示に応えるアシスタント」にし、RLHFなどで役に立ち害の少ない答えに近づける。
- 調整で答え方は磨かれるが、正しさは保証されない。知識には期限もある。
確認テスト
Q1. 事前学習を終えたばかりのモデルについて、最も当てはまるものはどれでしょう?
- 知識は豊富だが、質問に答えるより「ありそうな続き」を書こうとする
- まだ何の知識も持っていない
- すでに人の好みに合わせて完全に調整されている
答えと解説
正解は1。事前学習のモデルは、文章の続きを予測するように学んでいるため、そのままでは指示に応える形で答えるとは限りません。指示チューニングなどで受け答えの型を身につけさせます。
Q2. 「スケーリング則」の説明として最も適切なものはどれでしょう?
- モデルを小さくするほど性能が上がるという法則
- モデル・データ・計算量を増やすと、誤りが予測可能な形で減っていく傾向
- 学習データは多ければ多いほど、必ずすべての誤りがなくなるという法則
答えと解説
正解は2。規模を大きくすると性能がなめらかに伸びる傾向が研究で示されました。ただし、誤りがなくなることを保証するものではありません。
Q3. RLHFの手順として正しい順番はどれでしょう?
- 報酬モデルで答えを書く → 人が順位を付ける → 文章を集める
- LLMを一から作り直す → 人が答えを書き直す → 終了
- 人が答えに順位を付ける → 報酬モデルを学習させる → 報酬が高くなるようLLMを調整する
答えと解説
正解は3。人の比較評価から報酬モデルをつくり、その報酬モデルの点数が上がるようにLLMを強化学習で調整する、という流れです。
Q4. 人のフィードバックによる調整の限界として、正しいものはどれでしょう?
- 答え方は磨かれても、内容の正しさまでは保証されない
- 調整すると、すべての誤りがなくなる
- 調整すると、知識のカットオフ以降の出来事も分かるようになる
答えと解説
正解は1。人の評価にもとづく調整は、答えの分かりやすさや安全性を高めますが、事前学習で身についた知識の誤りがすべて直るわけではなく、新しい出来事を知るようになるわけでもありません。
次回予告
第6回では、LLMの「得意」と「苦手」を整理します。なぜもっともらしい間違い(ハルシネーション)が起きるのか、一度にどれだけの文章を覚えていられるのか。仕組みから理解すると、業務での付き合い方が見えてきます。
参考資料
- Radford, A. et al. “Improving Language Understanding by Generative Pre-Training.”(GPTの技術報告)OpenAI, 2018.(確認日:2026年11月12日)
- Brown, T. et al. “Language Models are Few-Shot Learners.” arXiv:2005.14165, 2020.(確認日:2026年11月12日)
- Kaplan, J. et al. “Scaling Laws for Neural Language Models.” arXiv:2001.08361, 2020.(確認日:2026年11月12日)
- Hoffmann, J. et al. “Training Compute-Optimal Large Language Models.” arXiv:2203.15556, 2022.(確認日:2026年11月12日)
- Ouyang, L. et al. “Training language models to follow instructions with human feedback.” arXiv:2203.02155, 2022.(確認日:2026年11月12日)
- Rafailov, R. et al. “Direct Preference Optimization.” arXiv:2305.18290, 2023.(確認日:2026年11月12日)
- Bai, Y. et al. “Constitutional AI: Harmlessness from AI Feedback.” arXiv:2212.08073, 2022.(確認日:2026年11月12日)
- Wei, J. et al. “Emergent Abilities of Large Language Models.” arXiv:2206.07682, 2022.(確認日:2026年11月12日)
- Schaeffer, R. et al. “Are Emergent Abilities of Large Language Models a Mirage?” arXiv:2304.15004, 2023.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較