
Transformerと注意機構:LLMの心臓部を図で理解する|生成AIのしくみ 第4回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第4回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①Transformerは、文章中のすべての言葉同士の関係を一度に見渡せる仕組みであること、②その中心にある「注意(アテンション)」は、各言葉が「どの言葉の情報をどれだけ取り込むか」を計算する仕組みであること、③LLMは、この仕組みを何十層も重ねて、次に来るトークンを予測していること。
前回は、文章をトークンに切り、埋め込み(意味の座標)に変換するところまで見ました。そして最後に、「同じ言葉でも文脈で意味が変わる」ため、周りの言葉の情報を取り込んでベクトルを書き換える必要がある、という話をしました。今回は、その書き換えを担う仕組み、Transformer(トランスフォーマー)と注意機構を見ていきます。2026年11月時点で広く使われているLLMの多くは、この仕組みを土台にしています。
Transformer以前:文章を「順番に」読む苦労
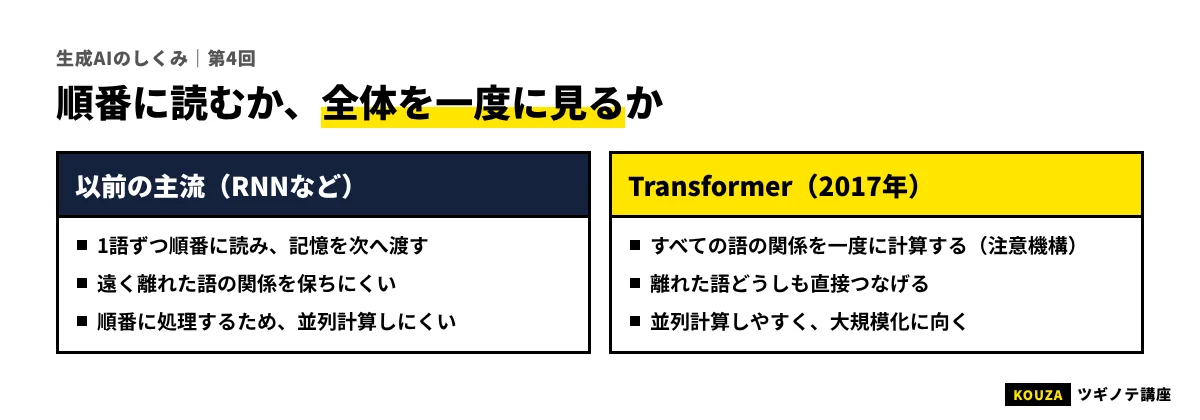
Transformerが登場する前、文章を扱うニューラルネットワークの主流は「RNN(再帰型ニューラルネットワーク)」と、その改良版の「LSTM」でした。これらは、文章を先頭から1トークンずつ順番に読み、読んだ内容を「記憶」として次へ受け渡していく方式です。
人が長い文章を、指でなぞりながら1語ずつ読み、頭の中のメモを書き換えていくイメージです。この方式には、2つの大きな弱点がありました。
- 遠くの言葉を忘れやすい:文の最初に出てきた主語が、何十語も後の動詞とつながっているとき、途中で記憶が薄れてしまいがちです。
- 並列に計算できない:前のトークンを読み終えないと次に進めないため、GPUで大量の計算を同時に回す、という強みを生かしにくい構造でした。
2017年、Googleの研究者らが発表した論文「Attention Is All You Need(必要なのは注意だけ)」で提案されたTransformerは、この2つの弱点を同時に解決しました。順番に読むのをやめ、文章中のすべての言葉同士の関係を、一度に計算する方式に切り替えたのです。
注意(アテンション)とは:「誰の話を、どれだけ聞くか」
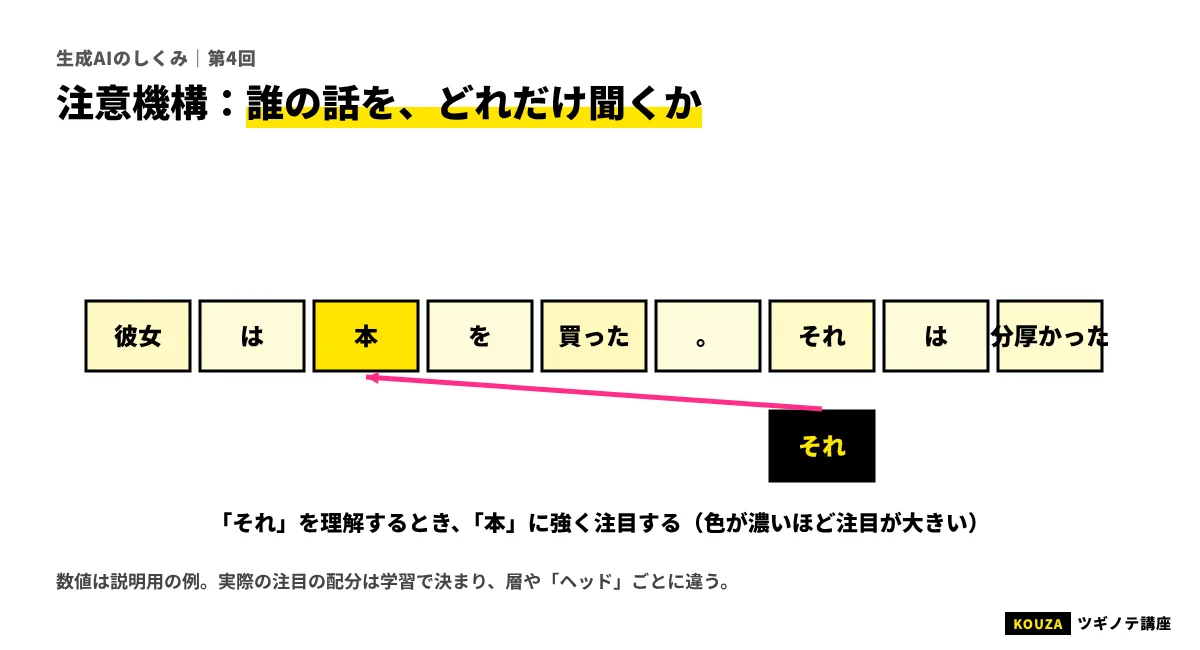
注意機構をたとえるなら、会議の参加者が、自分の発言を整えるために、ほかの参加者の発言のうち関係の深いものに耳を傾けるようなものです。
次の文を考えてみましょう。
「店長は、新人が棚に並べた商品を見て、彼をほめた。」
ここで「彼」は誰でしょうか。人間なら、文脈から「新人」だと分かります。注意機構では、「彼」というトークンが、文中のほかのトークン全員に対して「あなたは私にどれくらい関係がありますか?」と問いかけ、関係の深いトークン(ここでは「新人」)の情報を多めに取り込みます。その結果、「彼」のベクトルは「新人を指す彼」という意味を含むように書き換えられます。
これを、文中のすべてのトークンが同時に行います。「ほめた」は「店長」と「彼」に、「並べた」は「新人」と「商品」と「棚」に、それぞれ注目して自分の意味を更新します。文章の中の言葉同士が、互いに参照し合う仕組みです。同じ文章の中で注意し合うので、「自己注意(セルフアテンション)」と呼ばれます。
Transformerが、それ以前の主流だったRNNより有利だった点はどれでしょう?
- 文章中のすべての言葉同士の関係を一度に計算でき、並列計算もしやすい
- 文章を1語ずつ順番に読むので、計算が単純になる
- 学習データがまったく要らない
答えと解説
正解は1。Transformerは順番に読む方式をやめ、言葉同士の関係を一度に計算します。遠く離れた言葉の関係もとらえやすく、GPUでの並列計算にも向いています。
Query・Key・Value:注意の計算を3つの役割で理解する
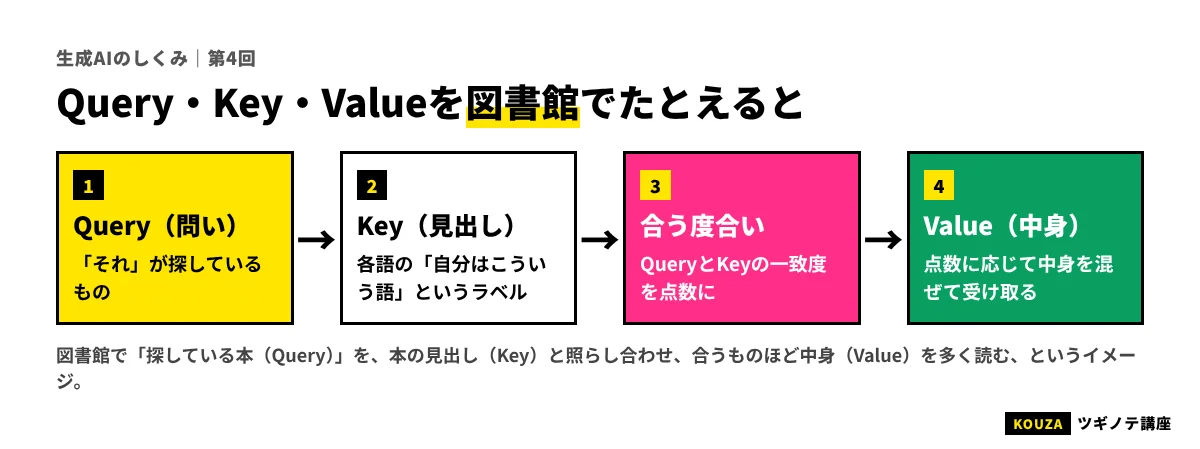
注意機構の中身は、Query(クエリ)、Key(キー)、Value(バリュー)という3つの役割で説明されます。図書館の本探しにたとえると分かりやすくなります。
| 役割 | 図書館のたとえ | 注意機構での意味 |
|---|---|---|
| Query(問い) | 「〇〇について知りたい」という自分の探し物 | このトークンが、今どんな情報を求めているか |
| Key(見出し) | 本の背表紙やタイトル | 各トークンが「自分はこういう情報を持っています」と示すラベル |
| Value(中身) | 本の中身 | 実際に受け渡される情報 |
計算の流れは次のとおりです。
- 各トークンの埋め込みから、Query・Key・Valueの3つのベクトルをつくる(それぞれ専用の重みを掛けて変換する)
- あるトークンのQueryと、全トークンのKeyを比べて、「どれくらい合っているか」の点数を出す(前回のコサイン類似度に近い、ベクトル同士の掛け算で測る)
- 点数を、合計が100%になる割合に変換する(これが「注意の重み」)
- その割合に応じて、各トークンのValueを混ぜ合わせる
- 混ぜ合わせた結果で、そのトークンのベクトルを更新する
図書館で言えば、「自分の探し物(Query)」と「背表紙(Key)」がよく合う本ほど多めに読み、それらの中身(Value)を自分のメモにまとめる、という作業です。「彼」のQueryは「誰のことか」を探していて、「新人」のKeyがそれによく合うので、「新人」のValueが多めに取り込まれる、というわけです。
もう一歩深く
手順2の点数は、QueryとKeyの内積(各要素を掛けて足したもの)を、ベクトルの次元数の平方根で割って求めます。次元が大きいと内積の値が大きくなりすぎ、手順3の割合への変換(ソフトマックス関数)が極端になって学習が不安定になるため、それを抑える工夫です。論文ではこれを「スケールド・ドット積注意」と呼んでいます。
マルチヘッド:いくつもの観点で同時に注目する
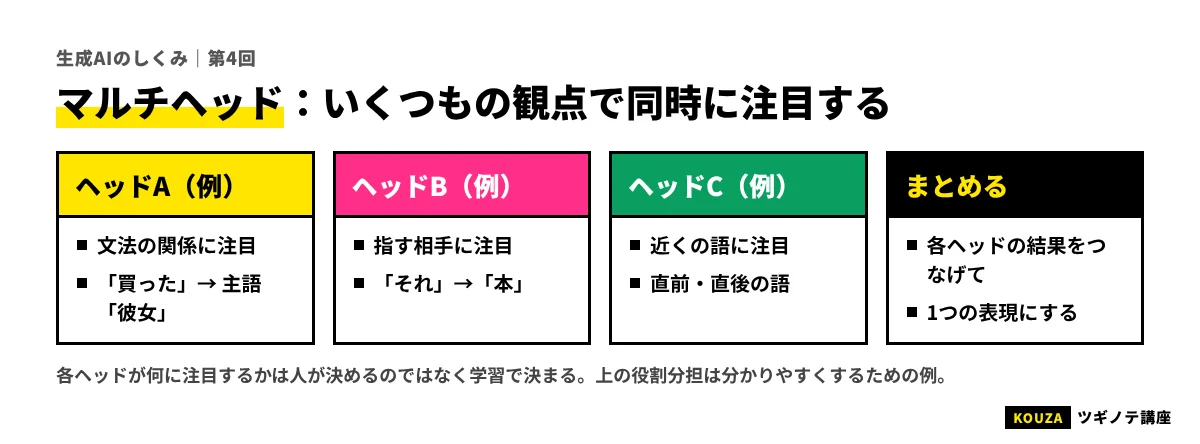
文章の中の関係は1種類ではありません。「誰が誰に何をしたか」という文法上の関係、「同じものを指している」という指示の関係、「話題が近い」という意味の関係など、いろいろあります。
そこでTransformerでは、注意の計算を、異なる重みで何組も並行して行います。それぞれの組を「ヘッド(頭)」と呼び、これを「マルチヘッド注意」と言います。会議で言えば、「論理の担当」「数字の担当」「関係者の担当」が、それぞれの観点で発言を聞き分け、最後に結果を持ち寄るようなものです。どのヘッドが何に注目するかは、人が決めるのではなく学習で決まります。
順番の情報をどう入れるか:位置の手がかり
注意機構は全トークンを一度に見渡すので、そのままでは語順が分かりません。「犬が人をかんだ」と「人が犬をかんだ」は、同じトークンの集まりなので区別がつかなくなってしまいます。
そこで、各トークンの埋め込みに「何番目の位置にあるか」を表す情報を加えます。これを「位置エンコーディング(位置埋め込み)」と呼びます。元の論文では、波(正弦波)を組み合わせた数値を足す方法が使われました。現在のLLMでは、位置の情報を注意の計算の中に組み込む方式など、さまざまな改良版が使われています。
注意機構で「位置の情報」を加える必要があるのはなぜでしょう?
- トークンの数を減らすため
- 文章を翻訳するため
- 全トークンを一度に見渡す仕組みのままだと、語順が区別できないため
答えと解説
正解は3。注意機構はトークン同士の関係を一度に計算するため、そのままでは「何番目にあるか」が分かりません。位置の情報を加えることで、語順の違いを区別できるようになります。
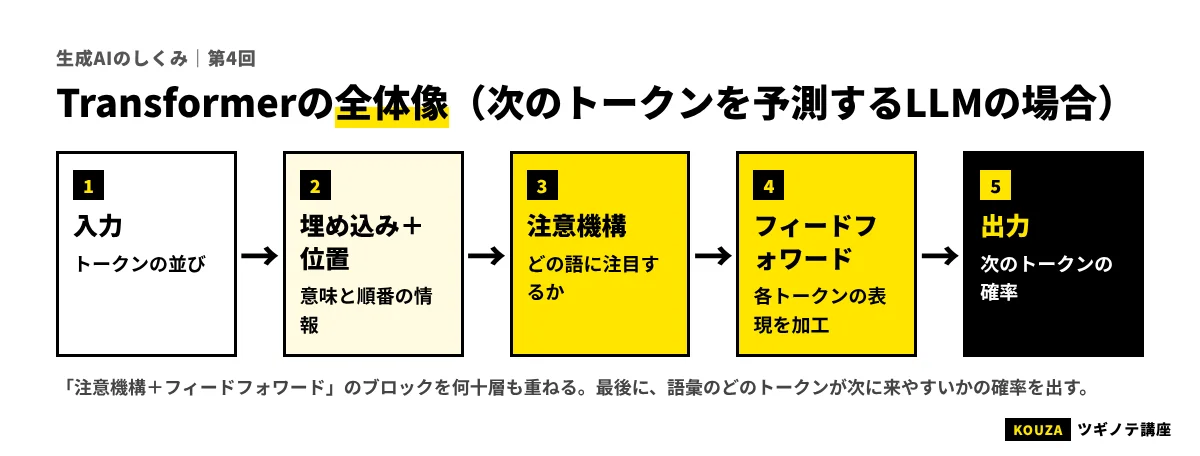
Transformerの1層と、それを重ねた全体像
Transformerの1つの層(ブロック)は、主に次の2つの部品でできています。
- 注意の部品:ほかのトークンから情報を集めて、自分のベクトルを更新する(言葉同士の「相談」)
- 個別処理の部品(フィードフォワード層):各トークンが、集めた情報をもとに自分の中で考えを整理する(第2回で見た、普通のニューラルネットワーク)
これに、学習を安定させるための工夫(元のベクトルを足し戻す「残差接続」や、数値の大きさをそろえる「正規化」)が加わります。
LLMは、このブロックを何十層も重ねた構造をしています。下の層では文法的なつながりのような比較的単純な関係が、上の層ではより抽象的な意味のつながりが扱われる、と分析されることがありますが、各層の役割はきれいに分かれているわけではなく、研究が続いている分野です。
LLMの最後の仕事:「次のトークン」の確率を出す
何十層ものブロックを通ってベクトルが十分に書き換えられたら、最後のトークンの位置のベクトルを使って、「次に来るトークンは何か」の確率を、辞書のすべてのトークンについて計算します。
たとえば「日本の首都は」の次なら、「東京」が非常に高い確率、「大阪」が少し、ほかはほぼゼロ、といった分布になります。LLMはこの分布から1つのトークンを選び、文章の末尾に付け足します。そして、付け足した文章全体を入力として、また次のトークンを予測します。これを繰り返して、文章を1トークンずつ書いていくのです。
なお、ChatGPTなどのLLMは、Transformerの中でも「デコーダー」と呼ばれる部分を使った構成が主流です。デコーダーでは、各トークンは自分より前のトークンだけに注意を向けます(未来の言葉はカンニングしない)。文章を前から順に生成する用途に合った形です。一方、前回触れたBERTのように、前後両方を見て文章を理解する「エンコーダー」型のモデルもあり、検索や分類などに使われています。
よくある誤解:LLMは、答えの文章を最初に丸ごと考えてから書いている
LLMは、基本的に1トークンずつ「次」を予測して書き足していきます。もちろん内部では、それまでの文脈から先の展開を見込んだような計算が行われていることを示唆する研究もあります。ただ、出力の仕組みとしては、一度出したトークンを後から書き換えることはなく、前から順に積み上げていく方式です。そのため、最初に間違った前提を書いてしまうと、それに引っ張られて誤りが続くことがあります(第6回で扱います)。
実務ではこう使う:注意機構を知っていると、プロンプトが変わる
- 大事な情報は、はっきり書く:注意機構は関係の深い言葉を見つけ出す仕組みですが、あいまいな指示では「どれに注目すべきか」が定まりません。「誰に」「何を」「どんな形式で」を明記すると、意図が伝わりやすくなります。
- 長い資料では、指示を最後にもう一度書く:一度に扱える量が増えた今でも、長い入力の途中にある情報は見落とされやすいことが研究で報告されています(第6回で扱います)。重要な指示は、冒頭と末尾の両方に置くと安定しやすくなります。
- 前提の誤りは、早めに直す:LLMは自分が書いた前の文章に引っ張られるので、出力の最初のほうが間違っていたら、続きを待たずに指示し直す方が効率的です。
社内で生成AIの使い方を広めたい場合は、AI研修のおすすめ比較も参考にしてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 以前の主流だったRNNは、文章を順番に読むため、遠くの言葉を忘れやすく、並列計算も苦手だった。
- Transformer(2017年)は、文章中のすべての言葉同士の関係を一度に計算する「注意機構」でこれを解決した。
- 注意機構は、Query(探し物)・Key(見出し)・Value(中身)で、各トークンが関係の深い言葉の情報を取り込む仕組み。複数の観点(マルチヘッド)で同時に行う。
- 語順は位置の情報で補う。注意とフィードフォワードのブロックを何十層も重ね、最後に次のトークンの確率を出す。
- LLMは1トークンずつ前から順に書き足す。最初の誤りに引っ張られることがある。
確認テスト
Q1. 自己注意(セルフアテンション)の説明として正しいものはどれでしょう?
- AIが人間の表情に注目して感情を読み取る仕組み
- 文章中の各トークンが、ほかのトークンのうち関係の深いものの情報を取り込んで、自分の意味を更新する仕組み
- 重要な単語だけを残し、それ以外を削除する仕組み
答えと解説
正解は2。自己注意では、同じ文章の中のトークン同士が互いの関係の深さを計算し、関係の深い言葉の情報を多めに取り込みます。言葉を削除するわけではありません。
Q2. Query・Key・Valueの役割の組み合わせとして正しいものはどれでしょう?
- Query=求めている情報、Key=自分が持つ情報のラベル、Value=受け渡される中身
- Query=文章の長さ、Key=暗号のかぎ、Value=価格
- Query=正解、Key=損失、Value=重み
答えと解説
正解は1。図書館のたとえで言えば、Queryは探し物、Keyは背表紙、Valueは本の中身です。QueryとKeyの合い具合で、どのValueをどれだけ取り込むかが決まります。
Q3. マルチヘッド注意の目的として最も適切なものはどれでしょう?
- 同じ計算を何度も繰り返して、誤りを打ち消すため
- 複数の文章を同時に翻訳するため
- 文法・指示・話題など、異なる観点の関係を並行してとらえるため
答えと解説
正解は3。言葉同士の関係には多くの種類があるため、異なる重みを持つ複数のヘッドで並行して注意を計算し、さまざまな観点の関係をとらえます。
Q4. LLMが文章を生成するときの基本的な動き方はどれでしょう?
- 答えの文章を丸ごと決めてから、一度に出力する
- 次に来るトークンの確率を計算して1つ選び、書き足すことを繰り返す
- 学習データの中から最も近い文章を探して、そのまま出力する
答えと解説
正解は2。LLMは、それまでの文章をもとに次のトークンの確率分布を計算し、1つ選んで書き足す作業を繰り返して文章を組み立てます。
次回予告
第5回では、Transformerという「器」に、どうやって知識と会話の能力を身につけさせるのかを見ていきます。大量の文章で学ぶ「事前学習」から、人の好みに合わせて調整する「RLHF」まで、LLMが育てられる流れを追いましょう。
参考資料
- Vaswani, A. et al. “Attention Is All You Need.” arXiv:1706.03762, 2017.(確認日:2026年11月12日)
- Hochreiter, S., Schmidhuber, J. “Long Short-Term Memory.” Neural Computation 9(8), 1997.(確認日:2026年11月12日)
- Bahdanau, D., Cho, K., Bengio, Y. “Neural Machine Translation by Jointly Learning to Align and Translate.” arXiv:1409.0473, 2014.(確認日:2026年11月12日)
- Radford, A. et al. “Language Models are Unsupervised Multitask Learners.”(GPT-2の技術報告)OpenAI, 2019.(確認日:2026年11月12日)
- Liu, N. F. et al. “Lost in the Middle: How Language Models Use Long Contexts.” arXiv:2307.03172, 2023.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較