
言葉を数字にする:トークンと埋め込み(ベクトル)|生成AIのしくみ 第3回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第3回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①LLMは文章を「トークン」という小さな単位に切って扱うこと、②トークンは「埋め込み」によって、意味の近さを表す数値の列(ベクトル)に変換されること、③この変換のおかげで、AIが言葉の意味や関係を計算で扱えるようになったこと。
前回は、ニューラルネットワークが数値を受け取り、重み付きの足し算を重ねて答えを出す仕組みを見ました。ここで1つ疑問が浮かびます。ニューラルネットワークが扱えるのは数値だけです。では、「明日の会議の資料を要約して」という文章を、どうやって数値にしているのでしょうか。今回は、LLMの入口にあたる「トークン」と「埋め込み」を見ていきます。
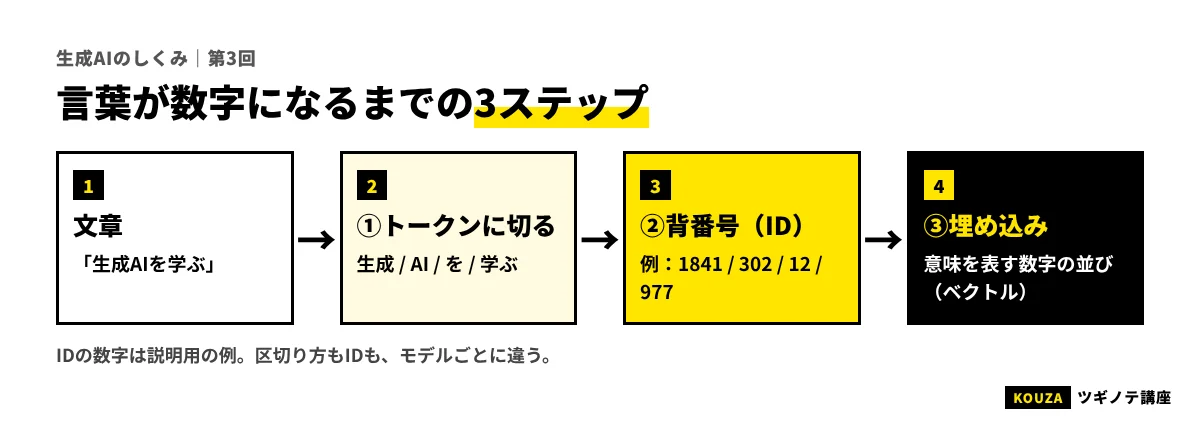
ステップ1:文章を「トークン」に切る
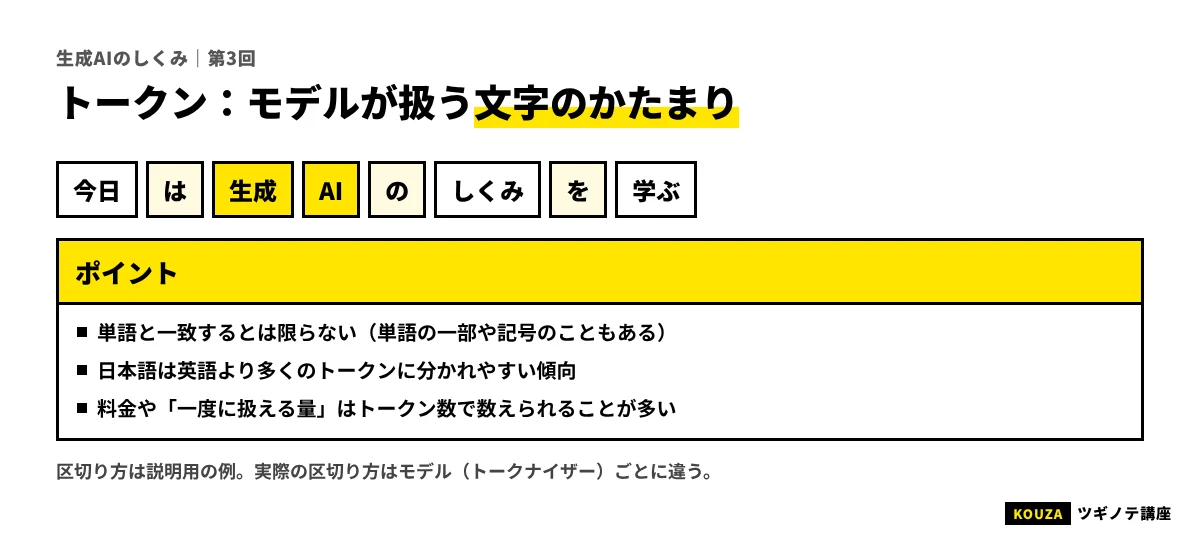
LLMは、文章を1文字ずつでも、1単語ずつでもなく、「トークン」という単位に区切って扱います。トークンは、よく出てくる文字の並びをひとまとまりにした単位です。
たとえば英語の場合、「unbelievable」という単語は、モデルによって「un」「believ」「able」のように分けられることがあります。よく使われる単語(the や is など)は1トークンになり、珍しい単語はいくつかのかけらに分かれます。日本語では、漢字1文字や、ひらがな数文字、よく出る単語のまとまりなどがトークンになります。どこで区切るかはモデルごとに違います。
文章をトークンに区切る道具を「トークナイザー」と呼びます。トークナイザーは、モデルの学習を始める前に、大量の文章をもとに「どの文字の並びをひとまとまりにすると効率がよいか」を統計的に決めてつくられます。代表的な方法に、よく一緒に出てくる文字のペアを繰り返しくっつけていく「BPE(バイトペア符号化)」があります。
なぜ単語でも文字でもなく「トークン」なのか
| 区切り方 | 長所 | 短所 |
|---|---|---|
| 1文字ずつ | 辞書が小さくて済み、未知の言葉がない | 文章がとても長い列になり、意味のまとまりをつかみにくい |
| 1単語ずつ | 意味のまとまりが分かりやすい | 辞書が巨大になり、新語・固有名詞・活用形に弱い。日本語は単語の区切りがあいまい |
| トークン(その中間) | よく出る並びは1つ、珍しい言葉はかけらの組み合わせで表せる | 区切り方が人間の感覚とずれることがある |
トークンは、この2つのいいとこ取りをした方法です。どんな新しい言葉でも、かけらを組み合わせれば表せるので、「辞書にない言葉」がほぼなくなります。
トークンは料金と上限の単位でもある
トークンは、仕組みの話だけでなく、実務でもよく目にする単位です。
- 料金:生成AIのAPI(プログラムから使う窓口)の多くは、入力と出力のトークン数で料金が決まります。
- 上限:一度に扱える文章の長さ(コンテキストウィンドウ。第6回で扱います)も、トークン数で表されます。
一般に、同じ内容でも日本語は英語より多くのトークンを使う傾向があるとされてきました。ただし、トークナイザーの改良によって差は変わっており、何文字が何トークンになるかはモデルによって異なります。正確な数は、各サービスが提供しているトークン数の計算ツールなどで確かめるのが確実です。
LLMが文章を「トークン」に区切って扱う理由として、最も適切なものはどれでしょう?
- トークンに区切ると、文章の意味が必ず人間と同じように理解できるから
- よく出る並びはまとめて、珍しい言葉はかけらの組み合わせで表せ、辞書の大きさと表現力のバランスがよいから
- 文字や単語では、コンピューターが文章を保存できないから
答えと解説
正解は2。トークンは、文字単位と単語単位の中間です。辞書を大きくしすぎずに、新しい言葉にも対応できます。区切り方が人間の感覚と一致するとは限りません。
ステップ2:トークンに「背番号」をつける
区切ったトークンには、それぞれ辞書の中での背番号(ID)がつきます。たとえば「会議」が1532番、「資料」が8817番、という具合です(番号は説明のための例です)。
ここで注意したいのは、背番号そのものには意味がないことです。1532番と1533番が意味の上で近いわけではありません。電話帳の並び順のようなもので、番号の近さと意味の近さは無関係です。そのため、背番号をそのままニューラルネットワークに入れても、言葉の意味はうまく扱えません。そこで次のステップが必要になります。
ステップ3:埋め込み(ベクトル)で「意味の座標」を与える
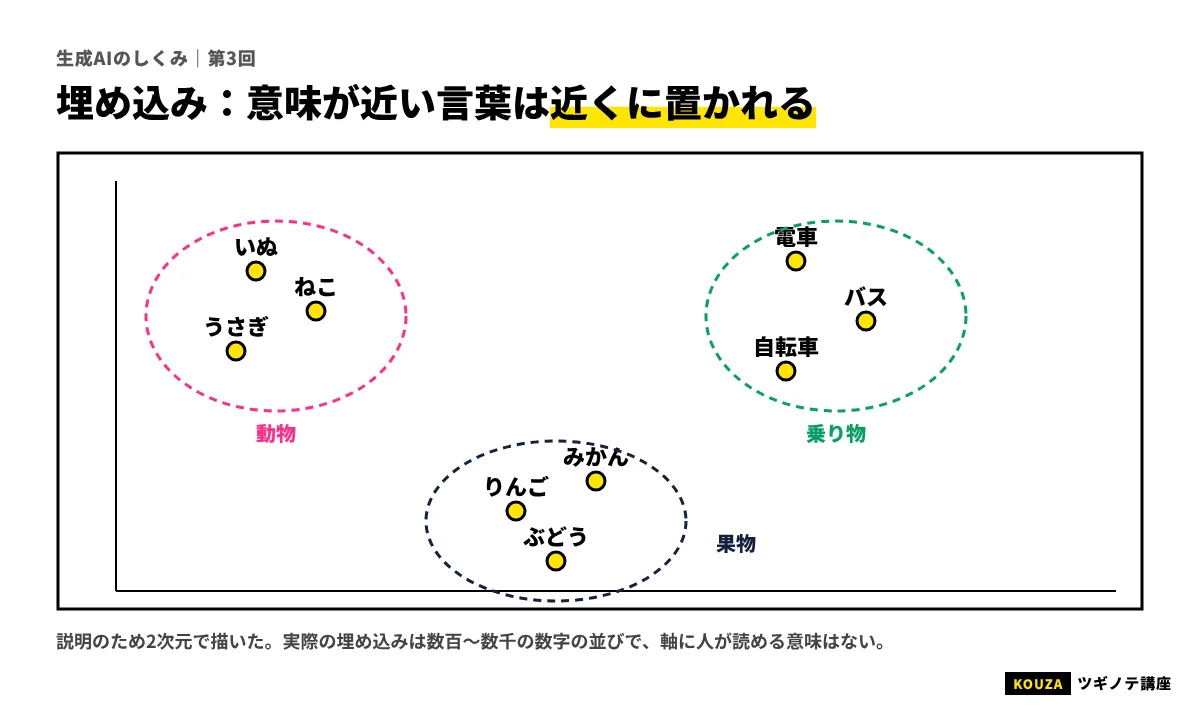
背番号を、意味を反映した数値の列に変換するのが「埋め込み(エンベディング)」です。数値の列のことを「ベクトル」と呼びます。各トークンは、たとえば数百〜数千個の数値の並びで表されます。
たとえ:言葉の「地図」上の住所
埋め込みは、言葉の意味の地図の上に、それぞれのトークンの「住所(座標)」を決めるようなものです。
- 意味が近い言葉は、地図の上でも近くに住む(「犬」と「猫」は近く、「犬」と「株価」は遠い)
- 地図の方角が、意味の違いを表すことがある
ふつうの地図は縦と横の2次元ですが、埋め込みの地図は数百〜数千次元あります。人間には想像できませんが、次元が多いほど、「動物かどうか」「かたいか柔らかいか」「ビジネスの話か」といった、たくさんの観点を同時に表せます。ただし、各次元が人間に分かる1つの意味に対応しているとは限りません。多くの観点が混ざり合って表現されています。
有名な例:「王様 − 男性 + 女性 ≒ 女王」
2013年に発表された「word2vec」の研究(Mikolovら)では、単語の埋め込みに、意味の関係が足し算・引き算として現れることが示され、話題になりました。
- 「王様」のベクトルから「男性」のベクトルを引き、「女性」のベクトルを足す
- すると、計算結果は「女王」のベクトルの近くに来る
「男性→女性」という意味の違いが、地図の上で一定の方向として表れている、ということです。論文では同じように「パリ−フランス+イタリア≒ローマ」という、首都と国の関係の例も挙げられています。もちろん、いつもきれいに成り立つわけではありませんが、「意味を座標で表せる」という考え方を印象づけた例です。
もう一歩深く
埋め込みの数値は、人が決めるのではなく学習で決まります。word2vecは「同じような文脈に出てくる単語は、意味も近い」という考え方(分布仮説)にもとづき、周りの単語から真ん中の単語を当てる、といった課題で埋め込みを学習しました。現在のLLMでは、埋め込みの表もモデル全体の一部として、第2回で見た誤差逆伝播と勾配降下法で、ほかの重みと一緒に学習されます。
埋め込み(ベクトル)について正しい説明はどれでしょう?
- 意味の近い言葉ほど、数値の列(座標)も近くなるように学習される
- 辞書の背番号をそのまま使ったもので、番号が近いほど意味も近い
- 人が1語ずつ手作業で数値を決めている
答えと解説
正解は1。埋め込みは学習によって決まり、意味の近い言葉が近い位置に来るようになります。背番号の近さには意味がなく、数値も人が手で決めるわけではありません。
「意味が近い」は、どうやって測るのか
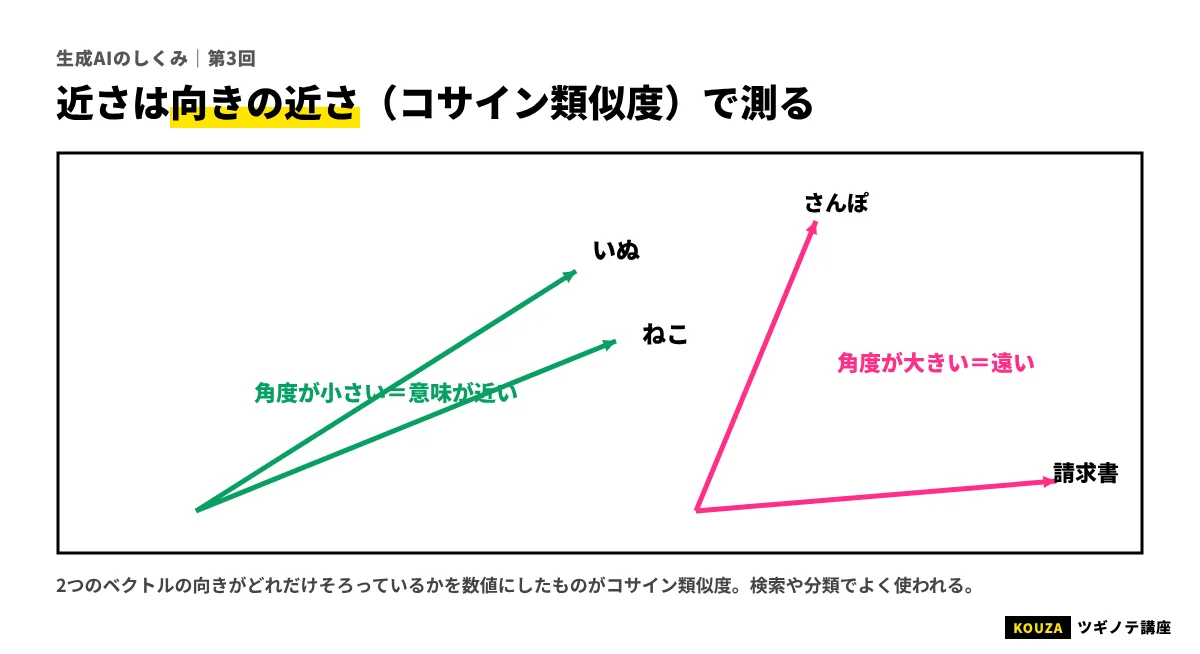
埋め込みで言葉を座標にできたとして、「近い」「遠い」はどう判断するのでしょうか。よく使われるのが、2つのベクトルの「向き」がどれくらいそろっているかを測る方法です。これを「コサイン類似度」と呼びます。
たとえるなら、地図の中心から2つの住所に矢印を引き、その矢印の角度を比べるようなものです。
- 矢印がほぼ同じ方向を向いている → 意味がとても近い(類似度は1に近い)
- 矢印が直角くらいに開いている → あまり関係がない(類似度は0に近い)
- 矢印が反対を向いている → 逆向きの性質を持つ(類似度はマイナス)
「距離」ではなく「向き」で比べることが多いのは、ベクトルの長さ(大きさ)には、言葉の出てくる頻度など意味以外の要素が混ざりやすいためです。向きだけを比べれば、意味の方向がそろっているかどうかに注目できます。
この「向きの近さ」を計算する操作は、実はLLMの内部でも何度も登場します。次回扱う注意機構は、まさに「この言葉とあの言葉は、どれくらい関係が深いか」をベクトル同士の計算で測る仕組みです。今回の「意味を座標で表し、近さを計算する」という考え方は、この先の回でずっと使い続ける土台になります。
同じ言葉でも、文脈で意味が変わる
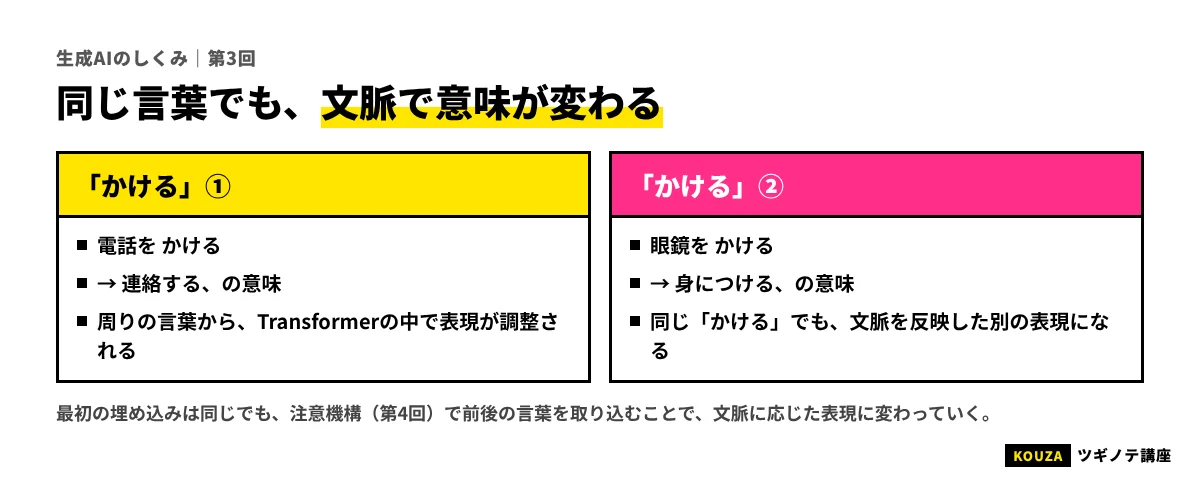
ここで1つ問題があります。「はし」という言葉は、「橋」「箸」「端」のどれかによって意味がまったく違います。英語でも「bank」は「銀行」と「土手」の両方の意味があります。
word2vecのような初期の埋め込みでは、1つの単語に1つのベクトルしかありませんでした。つまり「bank」は、銀行と土手の意味が混ざった、中途半端な位置に置かれてしまいます。
現在のLLMでは、トークンを埋め込みに変換したあと、第4回で扱う「注意機構」によって、周りの言葉の情報を取り込みながらベクトルを何度も書き換えていきます。「川の bank に座った」なら土手寄りに、「bank で口座を開いた」なら銀行寄りに、文脈に合わせて意味が調整されるのです。これを「文脈に応じた埋め込み」と呼ぶことがあります。
この仕組みが、LLMが文脈を読んで自然な返答ができる理由の1つです。詳しくは次回、じっくり見ていきます。
埋め込みは、検索や分類でも大活躍
埋め込みは、LLMの内部だけで使われるものではありません。「文章を、意味を表すベクトルに変える」機能は、それ単体でもさまざまな業務に使われています。
| 使い方 | 何をするか | 例 |
|---|---|---|
| 意味で検索する | 質問文と文書をベクトルにし、近いものを探す | 「休暇の申請方法」で、「有給の取り方」と書かれた規程も見つける |
| 似たものをまとめる | ベクトルが近い文章をグループにする | 問い合わせを内容ごとに自動で分類する |
| おすすめする | 好みのベクトルに近い商品や記事を出す | 読んだ記事に近い記事を表示する |
| 重複を見つける | ほぼ同じ意味の文章を見つける | FAQの重複や、似た質問の統合 |
特に1つ目の「意味で検索する」は、第7回で扱うRAG(社内文書を参照して答えるAI)の土台になる重要な技術です。キーワードが一致しなくても、意味が近ければ見つけられるのが強みです。
よくある誤解:埋め込みで探せば、必ず正しい文書が見つかる
埋め込みによる検索は、言い換えに強い一方で、型番や固有名詞、数字のような「完全に一致してほしい」情報は苦手なことがあります。実務では、従来のキーワード検索と組み合わせる方法(ハイブリッド検索)がよく使われます。
実務ではこう使う:トークンと埋め込みを意識した使い方
- 長い資料は「トークンの上限」を意識して渡す:上限を超える長さは一度に読めません。章ごとに分ける、要点だけ渡す、といった工夫が必要です。
- API利用ではトークン数でコストを見積もる:入力と出力のトークン数が料金に直結します。毎回同じ長い前置きを送る使い方は、コストがかさみます。
- 社内検索の改善は「埋め込み+キーワード」で考える:問い合わせ対応や社内FAQでは、意味の検索と、型番などの完全一致の検索を組み合わせると精度が上がりやすくなります。
社内向けにこうしたAIツールを選ぶときは、法人向け生成AIツールのおすすめ比較も参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- LLMは文章を「トークン」という単位に切って扱う。トークンは文字と単語の中間で、どんな言葉もかけらの組み合わせで表せる。
- トークンは料金や、一度に扱える長さの単位でもある。何文字が何トークンになるかはモデルによって違う。
- トークンの背番号そのものに意味はない。埋め込みで「意味の座標(ベクトル)」に変換する。
- 埋め込みでは意味の近い言葉が近くに置かれ、意味の関係が方向として表れることもある。
- 現在のLLMは、注意機構で文脈を取り込み、同じ言葉でも文脈に合わせた意味のベクトルに書き換えていく。
確認テスト
Q1. トークナイザーの役割として正しいものはどれでしょう?
- 文章の内容が正しいかどうかを判定する
- 文章を別の言語に翻訳する
- 文章を、モデルが扱う単位(トークン)に区切る
答えと解説
正解は3。トークナイザーは、文章をトークンという単位に区切り、それぞれに背番号をつける道具です。
Q2. トークンの背番号をそのまま使わず、埋め込みに変換する理由はどれでしょう?
- 背番号は大きすぎて保存できないから
- 背番号の近さには意味がなく、意味の近さを計算で扱えないから
- 背番号は毎回ランダムに変わるから
答えと解説
正解は2。背番号は電話帳の並び順のようなもので、番号の近さと意味の近さは関係ありません。埋め込みに変換することで、意味の近さを距離として扱えるようになります。
Q3. 「王様 − 男性 + 女性 ≒ 女王」の例が示していることは何でしょう?
- 埋め込みの空間では、意味の関係が一定の方向として表れることがある
- AIが王室の歴史を正しく理解している
- どんな単語でも、必ず足し算と引き算で別の単語が作れる
答えと解説
正解は1。「男性→女性」という意味の違いが、埋め込みの空間で方向として表れていることを示す有名な例です。ただし、いつもきれいに成り立つわけではありません。
Q4. 埋め込みを使った「意味の検索」について、注意すべき点はどれでしょう?
- 言い換えた表現はまったく見つけられない
- 文章をベクトルにすることはできない
- 型番や固有名詞など、完全に一致してほしい情報は苦手なことがある
答えと解説
正解は3。意味の検索は言い換えに強い一方、型番や数字のような完全一致が必要な情報では外れることがあります。そのため、キーワード検索と組み合わせるのが一般的です。
次回予告
第4回では、いよいよLLMの心臓部「Transformer」と「注意機構」に入ります。文章の中で、どの言葉がどの言葉に「注目」しているのか。文脈を読む仕組みを、図とたとえで理解しましょう。
NEXT|第4回Transformerと注意機構:LLMの心臓部を図で理解する次の回へ進む →参考資料
- Mikolov, T. et al. “Efficient Estimation of Word Representations in Vector Space.” arXiv:1301.3781, 2013.(確認日:2026年11月12日)
- Sennrich, R., Haddow, B., Birch, A. “Neural Machine Translation of Rare Words with Subword Units.” arXiv:1508.07909, 2015.(確認日:2026年11月12日)
- Devlin, J. et al. “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding.” arXiv:1810.04805, 2018.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較