
拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く|生成AIのしくみ 第10回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZA生成AIのしくみ
第10回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員
この回で分かること:①拡散モデルは、画像にノイズを少しずつ加える過程を学び、その逆(ノイズを少しずつ取り除く)をたどって画像をつくること、②ネットワークが学ぶのは「この画像に混ざっているノイズはどれか」を当てる単純な課題であること、③CLIPなどで言葉と画像を結びつけ、各段階で言葉の指示を反映させることで、テキストから画像がつくれること。
前回は、偽造者と鑑定士の競争で画像をつくるGANを見ました。今回は、2026年11月時点で画像生成AIの主流となっている「拡散モデル」を取り上げます。仕組みの核心は、驚くほどシンプルです。「ノイズだらけの画像から、少しだけノイズを取り除く」。これを何十回も繰り返すと、砂嵐から絵が浮かび上がってくるのです。
発想の出発点:インクが水に広がる様子を逆再生する
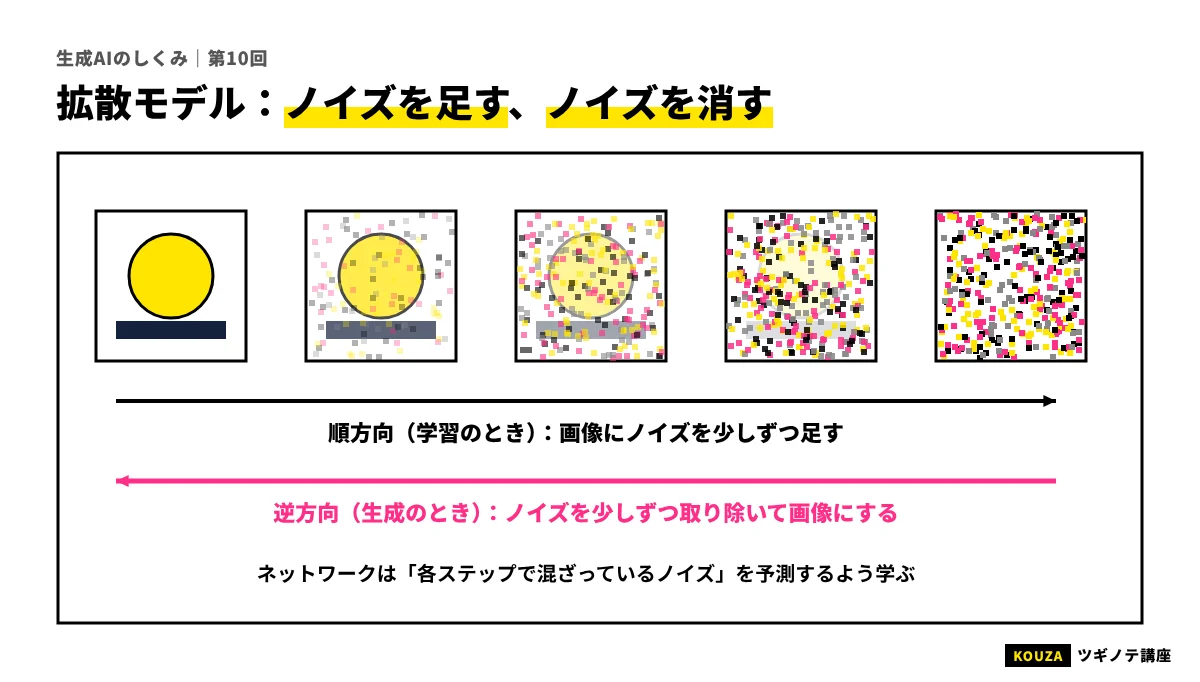
「拡散」という名前は、物理の拡散現象から来ています。コップの水に1滴のインクを落とすと、時間とともに広がり、最後は水全体が均一に薄く色づきます。きれいな形をしていたインクの模様が、すっかり崩れてしまうわけです。
もし、この映像を逆再生できたら、均一に色づいた水から、インクの模様が浮かび上がってくるはずです。拡散モデルは、画像でこの「逆再生」を学ぶ仕組みです。
- 順方向(拡散過程):きれいな画像に、少しずつランダムなノイズを加えていく。何百回も繰り返すと、元の画像の面影はなくなり、完全なノイズ(砂嵐)になる
- 逆方向(逆拡散過程):完全なノイズから出発し、少しずつノイズを取り除いていく。うまくできれば、最後にはきれいな画像が現れる
順方向は、単にノイズを足すだけなので、学習の必要はありません。学習が必要なのは逆方向、つまり「ノイズを少しだけ取り除く方法」です。
ネットワークが学ぶこと:「混ざっているノイズを当てる」
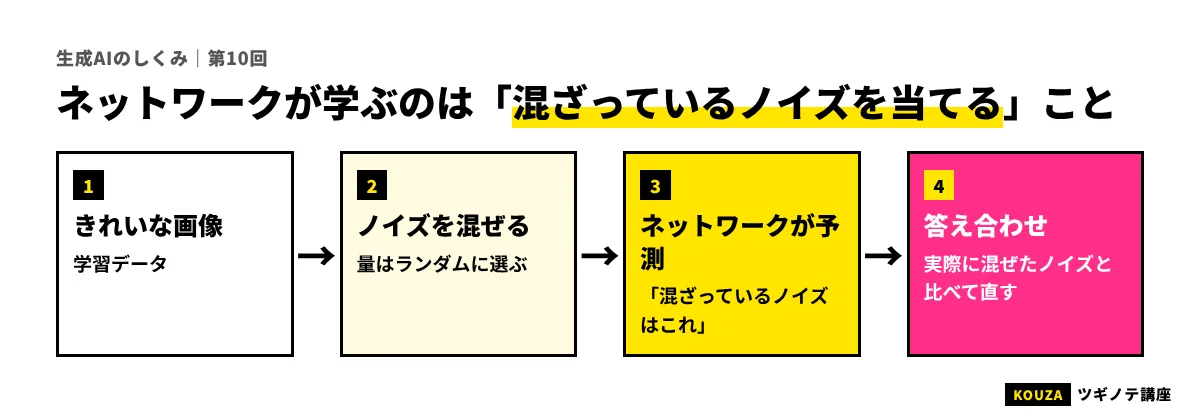
拡散モデルの学習で、ニューラルネットワークが解く問題は、次のようなものです。
- 学習データからきれいな画像を1枚選ぶ
- ランダムに選んだ段階(たとえば「100段階中の37段階目」)に相当する量のノイズを、画像に加える
- ノイズの混ざった画像と、何段階目かの情報をネットワークに渡す
- ネットワークに「この画像に加えられたノイズはどれか」を予測させる
- 実際に加えたノイズと比べて、ずれ(損失)が小さくなるように重みを直す
ポイントは、正解(実際に加えたノイズ)が自分で分かっていることです。第5回のLLMの事前学習と同じく、データさえあれば問題と答えをいくらでもつくれます。そして、「ノイズを当てる」という1つの課題を解くだけなので、前回のGANのような2者の競争がなく、学習が安定しやすいのです。
生成するときの手順
学習が終わったら、画像を生成するときは次のようにします。
- 完全なランダムノイズの画像を用意する
- ネットワークに「この中のノイズはどれか」を予測させる
- 予測したノイズを少しだけ差し引く
- 2〜3を何十回(手法によっては数回〜数百回)繰り返す
- 最後に残ったものが、生成された画像
彫刻家が大理石の塊から、少しずつ余分な部分を削って像を彫り出すのに似ています。最初はぼんやりした形(構図や大きな色のかたまり)が現れ、段階が進むにつれて細部(輪郭や質感)が整っていきます。
拡散モデルの学習で、ネットワークが解いている課題はどれでしょう?
- 本物の画像か偽物の画像かを判定する
- 画像を小さな要約に圧縮する
- ノイズを加えた画像から、加えられたノイズを予測する
答えと解説
正解は3。拡散モデルは「どのノイズが混ざっているか」を当てる課題で学習します。生成時は、予測したノイズを少しずつ差し引くことで、ノイズから画像を浮かび上がらせます。1はGANの識別器、2はVAEのエンコーダーの仕事です。
もう一歩深く
拡散モデルの原型は2015年に提案されましたが、注目を集めたのは2020年のDDPM(Denoising Diffusion Probabilistic Models)で、高品質な画像生成が示されました。生成に何百段階も必要なのが弱点でしたが、その後、少ない段階で済ませる工夫(DDIMなどの高速なサンプリング手法)や、少ない段階で生成できるよう別のモデルに学び直させる「蒸留」の研究が進み、生成時間は大きく短縮されています。また、ノイズの取り除き方を「ノイズの分布から画像の分布への流れ」として捉え直す、フローマッチングと呼ばれる考え方も広く使われるようになっています。
言葉で画像を指定する:CLIPと「条件付け」
ここまでの説明だけでは、「何か意味のある画像」はできても、「夕暮れの海辺を歩く犬」のように、言葉で指定した画像はつくれません。言葉の指示を反映させるには、2つの技術が鍵になります。
CLIP:画像と文章を同じ地図に並べる
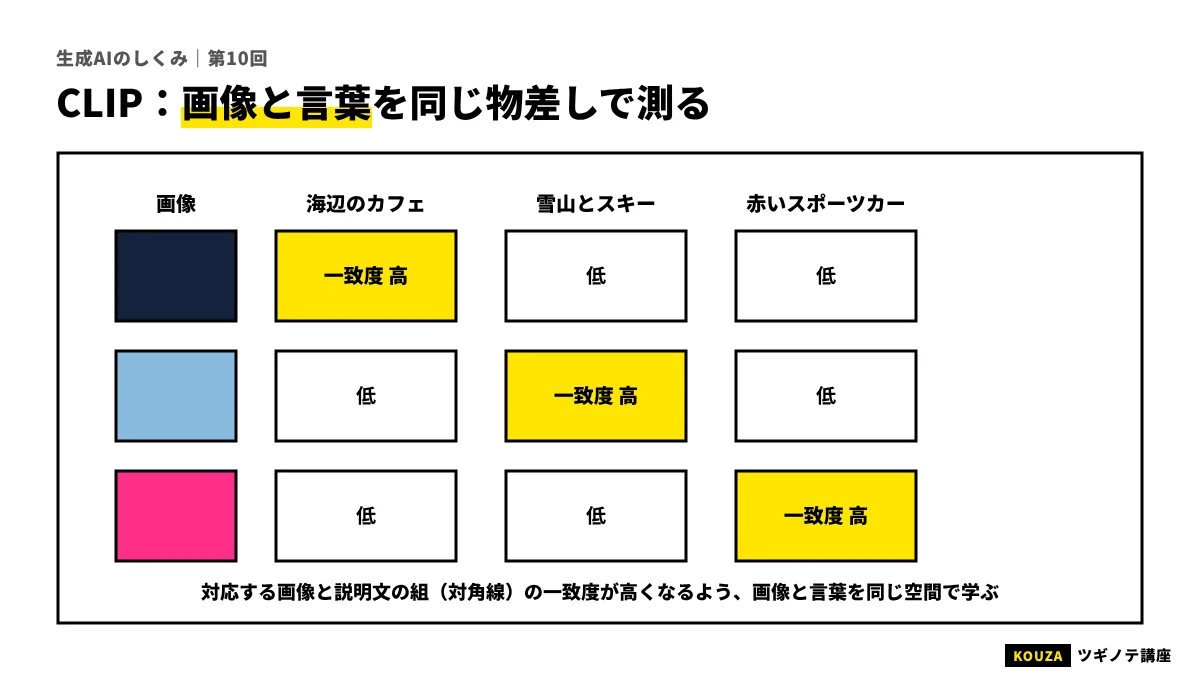
2021年にOpenAIが発表したCLIP(Contrastive Language-Image Pre-training)は、インターネット上の大量の「画像とその説明文のペア」を使って、画像と文章を同じ埋め込みの空間(地図)に並べるように学習したモデルです。
学習の考え方は、次のようなものです。
- 画像用のネットワークと、文章用のネットワークを用意する
- 正しいペア(犬の写真と「芝生の上の犬」)は、地図の上で近くに置かれるようにする
- 間違ったペア(犬の写真と「夜の高層ビル」)は、遠くに置かれるようにする
こうして学習すると、「犬」という言葉の埋め込みと、犬の写真の埋め込みが、同じ地図の近い場所に来るようになります。第3回で見た「言葉の地図」に、画像も一緒に載るようになったイメージです。これにより、言葉と画像の意味の近さを計算できるようになりました。
条件付け:各段階で言葉の指示を参照させる
テキストから画像をつくる拡散モデルでは、ノイズを予測するネットワークに、ノイズの混ざった画像と段階の情報に加えて、指示文の埋め込みも渡します。ネットワークは、第4回で見た注意機構の仕組み(文章と画像の間で注意を計算する「クロスアテンション」)を使って、画像の各部分を描くときに、指示文のどの言葉を参照すべきかを判断します。
「夕暮れの海辺を歩く犬」なら、画面の下の方を描くときは「海辺」に、中央の物体を描くときは「犬」に、全体の色合いを決めるときは「夕暮れ」に、強く注意を向ける、といった具合です。こうして、各段階のノイズ除去が、指示文の内容に沿った方向へ導かれていきます。この仕組みを「条件付け」と呼びます。
CLIPが果たした役割として、最も適切なものはどれでしょう?
- 画像と文章を同じ埋め込みの空間に並べ、言葉と画像の意味の近さを計算できるようにした
- 画像にノイズを加える速度を速くした
- 画像の著作権を自動で判定できるようにした
答えと解説
正解は1。CLIPは画像と説明文のペアから学習し、意味の近い画像と文章が近くに来る共通の地図をつくりました。これが、言葉で画像を指定する技術の土台の1つになりました。
指示をどれだけ強く効かせるか:ガイダンス
画像生成ツールの設定に、「指示への忠実度」や「CFGスケール」といった項目を見かけることがあります。これは、指示文をどれくらい強く反映させるかを調整するものです。
仕組みとしては、生成の各段階で「指示文ありの場合のノイズの予測」と「指示文なしの場合のノイズの予測」の両方を計算し、その差を強調する方向に進めます(Classifier-Free Guidanceと呼ばれる方法)。
- 強くする:指示に忠実になるが、色が濃すぎたり、不自然になったりしやすい
- 弱くする:自然で多様になるが、指示から外れやすい
プロンプトの効き方を、仕組みから理解する
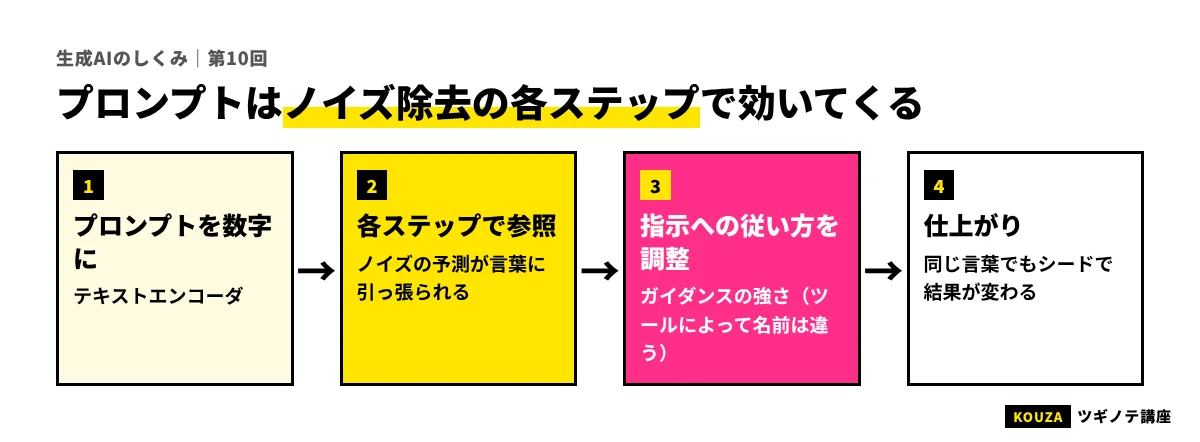
仕組みが分かると、画像生成のプロンプト(指示文)について、いくつかのことが見えてきます。
| よくある現象 | 仕組みからの説明 | 対策の例 |
|---|---|---|
| 指示した要素の一部が無視される | 1枚の画像の中で、注意が特定の言葉に偏ることがある | 重要な要素を前に書く、要素を減らす |
| 「〇〇がない画像」がうまくできない | 「ない」という否定は埋め込みでうまく表しにくく、「〇〇」という言葉自体に引っ張られることがある | 否定ではなく、あってほしいものを書く。ツールに「ネガティブプロンプト」の欄があれば使う |
| 数を指定してもその数にならない | 「3匹」のような正確な数は、学習で身につきにくいとされてきた | 構図を指定する、生成後に描き直し機能で調整する |
| 画像の中の文字が崩れる | 画像の中の文字は、細かく正確な形が必要で、苦手とされてきた | 文字は後からデザインツールで入れる(近年のモデルでは大きく改善) |
| 同じ指示でも毎回違う画像になる | 出発点のランダムなノイズが毎回違うため | 同じ結果を再現したいときは、ツールの「シード値」を固定する |
よくある誤解:プロンプトに呪文のような単語を大量に並べるほど、良い画像になる
画像生成AIの初期には、品質を上げるとされる単語を大量に並べる書き方が流行しました。モデルによっては効果がある場合もありますが、言葉の理解が進んだ最近のモデルでは、作りたい画像の内容を、自然な文章で具体的に説明する方が意図が伝わりやすいことが多くなっています。どの書き方が効くかはモデルごとに違うため、各ツールの公式ガイドを確認するのが確実です。
実務ではこう使う:拡散モデルの性質を生かす
- ラフ案を量産して選ぶ:出発点のノイズを変えるだけで、同じ指示から多様な案が出せます。広告やバナーのラフ案を多めに出し、人が方向性を選ぶ使い方に向いています。
- 気に入った案は「シード値」と指示を記録する:後から似た画像を再現・微調整しやすくなります。
- 部分の描き直しで仕上げる:全体を作り直すより、気になる部分だけを描き直す機能を使う方が効率的です。
- 文字や正確な数は人が仕上げる:ロゴや文字入れ、正確な個数が必要な素材は、生成後にデザインツールで仕上げる前提で使います。
動画も含めた生成ツールの選び方はAI動画生成ツールのおすすめ比較、社内展開の進め方は生成AIの成功事例も参考になります。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 拡散モデルは、画像にノイズを加える過程の「逆再生」を学び、ノイズから少しずつ画像を浮かび上がらせる。
- ネットワークの課題は「混ざっているノイズを当てる」こと。1つの課題を解くだけなので、学習が安定しやすい。
- CLIPは画像と文章を同じ地図に並べ、言葉と画像の意味の近さを計算できるようにした。
- テキストから画像をつくるときは、各段階でクロスアテンションによって指示文を参照させる(条件付け)。ガイダンスで指示の効き具合を調整する。
- 否定、正確な数、文字などは苦手になりやすい。仕組みを知ると、プロンプトの工夫や仕上げ方が見えてくる。
確認テスト
Q1. 拡散モデルで、学習が必要なのはどちらの過程でしょう?
- 画像に少しずつノイズを加えていく順方向の過程
- ノイズから少しずつノイズを取り除いていく逆方向の過程
- どちらも学習は必要ない
答えと解説
正解は2。順方向はノイズを足すだけなので学習は不要です。学習が必要なのは、ノイズを予測して取り除く逆方向の過程です。
Q2. 画像生成ツールで、同じ指示文でも毎回違う画像ができる主な理由はどれでしょう?
- AIが毎回指示文を読み間違えるから
- 毎回インターネットから別の画像を検索しているから
- 出発点となるランダムなノイズが毎回違うから
答えと解説
正解は3。拡散モデルはランダムなノイズから生成を始めるため、出発点が変わると結果も変わります。シード値を固定すると、同じ結果を再現しやすくなります。
Q3. テキストから画像をつくる拡散モデルで、指示文の内容を画像に反映させる仕組みとして正しいものはどれでしょう?
- ノイズを予測するネットワークに指示文の埋め込みも渡し、注意の仕組みで各部分を描くときに参照させる
- 指示文と同じ言葉が付いた画像を検索して表示する
- 完成した画像の上に、指示文を文字として重ねる
答えと解説
正解は1。指示文の埋め込みを生成の各段階で参照させる(条件付け)ことで、ノイズの取り除き方が指示に沿った方向へ導かれます。
Q4. 「ガイダンス(指示への忠実度)」を強くしすぎたときに起こりやすいことはどれでしょう?
- 指示からどんどん外れていく
- 指示には忠実になるが、色が濃すぎるなど不自然になりやすい
- 画像がまったく生成されなくなる
答えと解説
正解は2。ガイダンスを強めると指示に忠実になりますが、強すぎると不自然な画像になりやすくなります。弱めると自然で多様になる一方、指示から外れやすくなります。
次回予告
第11回では、文字と画像以外の生成AIに目を向けます。人の声を文字にする音声認識、文章を声にする音声合成、そして動画の生成。さらに、文章・画像・音声をまとめて扱う「マルチモーダル」なAIの仕組みを見ていきましょう。
参考資料
- Sohl-Dickstein, J. et al. “Deep Unsupervised Learning using Nonequilibrium Thermodynamics.” arXiv:1503.03585, 2015.(確認日:2026年11月12日)
- Ho, J., Jain, A., Abbeel, P. “Denoising Diffusion Probabilistic Models.” arXiv:2006.11239, 2020.(確認日:2026年11月12日)
- Song, J., Meng, C., Ermon, S. “Denoising Diffusion Implicit Models.” arXiv:2010.02502, 2020.(確認日:2026年11月12日)
- Radford, A. et al. “Learning Transferable Visual Models From Natural Language Supervision.”(CLIP)arXiv:2103.00020, 2021.(確認日:2026年11月12日)
- Ho, J., Salimans, T. “Classifier-Free Diffusion Guidance.” arXiv:2207.12598, 2022.(確認日:2026年11月12日)
- Rombach, R. et al. “High-Resolution Image Synthesis with Latent Diffusion Models.” arXiv:2112.10752, 2021.(確認日:2026年11月12日)
- Lipman, Y. et al. “Flow Matching for Generative Modeling.” arXiv:2210.02747, 2022.(確認日:2026年11月12日)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較