
インデックスとクロール:ページが検索結果に載るまで|SEOの教科書 第6回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZASEOの教科書
第6回/全12回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回SEOとは何か:検索の仕組みと、SEOで取れる成果・取れない成果
- 第2回キーワード選定と検索意図:何を狙い、どの順番で書くか
- 第3回サイト設計と内部リンク:迷わせない構造のつくり方
- 第4回構成案のつくり方:検索結果から「答えるべき問い」を読み解く会員
- 第5回本文の書き方とE-E-A-T:信頼される記事の条件会員
- 第6回インデックスとクロール:ページが検索結果に載るまで会員
- 第7回表示速度・スマホ対応・構造化データ:技術面の基本会員
- 第8回被リンクとサイテーション:やってよいこと・いけないこと会員
- 第9回効果測定:Search ConsoleとGA4で見る数字会員
- 第10回リライト:伸びない記事の見つけ方と直し方会員
- 第11回AI検索時代のSEO:AIによる概要・LLMOとの付き合い方会員
- 第12回体制づくりと外注:内製と外注の分け方、外注先の選び方会員
この回で分かること:①ページが検索結果に載るまでの流れと、それぞれの段階で使う道具、②robots.txt・noindex・canonicalの違いと使い分け、③Search Consoleで「載らない原因」を切り分ける手順。前回までで、良い記事を書く方法を学びました。今回からは技術面です。どれほど良い記事も、検索エンジンに読み取ってもらえなければ存在しないのと同じ。その土台を確かめる回です。
ページが検索結果に載るまで:4つの関門
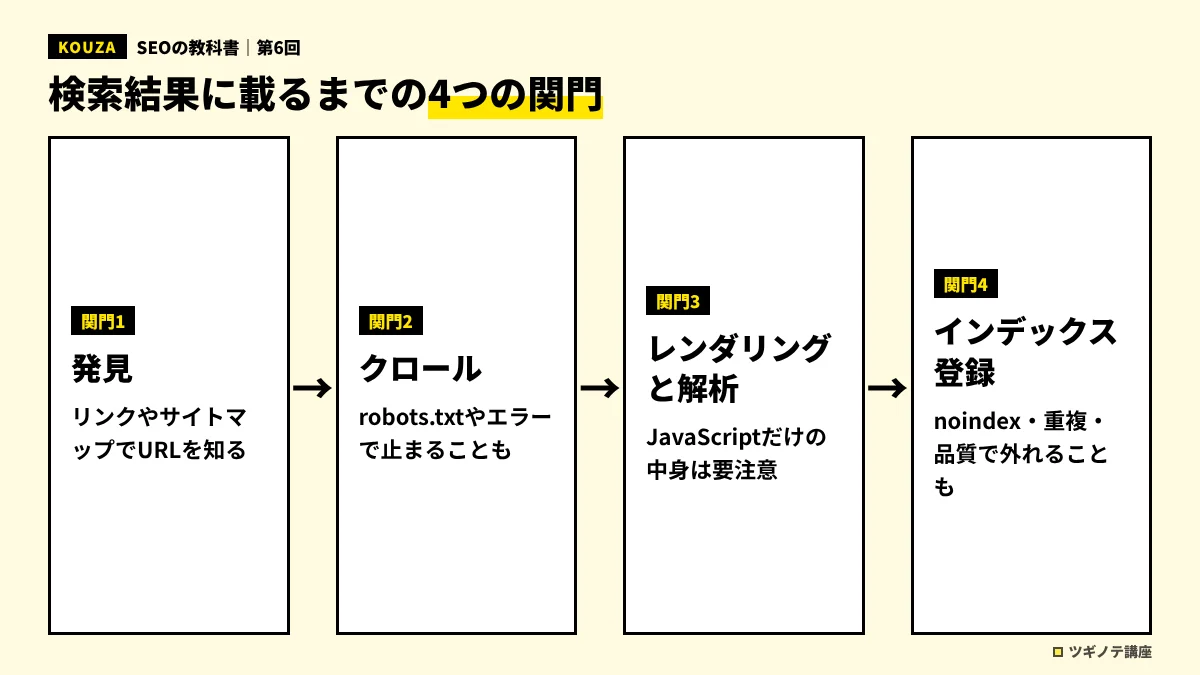
第1回で学んだ「クロール→インデックス登録→検索結果の表示」の流れを、実務の目線でもう少し細かく分けると、ページが検索結果に載るまでには次の4つの関門があります。
| 関門 | 起きていること | つまずく主な原因 |
|---|---|---|
| 1. 発見 | GoogleがそのURLの存在を知る | どこからもリンクされていない、サイトマップにも載っていない |
| 2. クロール | Googlebotがページを取得する | robots.txtでブロックしている、サーバーがエラーを返す、ログインが必要 |
| 3. レンダリングと解析 | ページを表示した状態にして、内容を読み取る | JavaScriptでしか中身が表示されず、うまく読み取れない |
| 4. インデックス登録 | 内容を理解し、インデックスに保存する | noindexの指定、重複していて別のページが代表に選ばれた、品質が十分でないと判断された |
記事が検索結果に出てこないとき、多くの人は「順位が低いのでは」と考えがちです。しかし実際には、そもそも4つの関門のどこかで止まっていて、インデックスに入っていないことが少なくありません。順位の話をする前に、まず「インデックスに入っているか」を確かめるのが、技術面のSEOの第一歩です。
関門1・2:発見とクロールを助ける
Googleは、主にリンクをたどってURLを発見し、XMLサイトマップからもURLを知ることができます。第3回で学んだとおり、内部リンクで孤立したページをなくすことが、発見されるための基本です。そのうえで、次の点を確認しましょう。
- XMLサイトマップを用意し、Search Consoleから送信する:新しいページや更新したページを知らせる手段になります。WordPressなど多くのCMSでは、自動で作成する機能があります。
- サーバーが安定して応答しているか:ページを取得しようとしたときにサーバーがエラーを返すと、そのページはクロールできません。エラーが続いていないかを確認しておきましょう。
- ログインが必要なページは検索結果に載らない:会員限定のページなど、ログインしないと見られないページは、Googlebotも中身を見られません。
よくある誤解:「クロールバジェットを気にしないといけない」
Googlebotが1つのサイトをどれだけクロールするかには上限があり、これをクロールバジェットと呼びます。SEOの情報でよく取り上げられる言葉ですが、Googleは、クロールバジェットの管理が必要になるのは主に非常に大規模なサイト(目安として、重複のないページが100万以上あって週1回程度更新される大規模サイトや、1万以上あって毎日更新される中規模以上のサイト)だと説明しています。Googleは、そうでないサイトは、サイトマップを最新に保ち、ページのインデックス登録レポートを定期的に確認すれば通常は十分だとしています。数百〜数千ページ程度の一般的な企業サイトやメディアでは、クロールバジェットを心配するより、リンク構造や内容の質を整える方がずっと効果的です。
3つの道具の違い:robots.txt・noindex・canonical
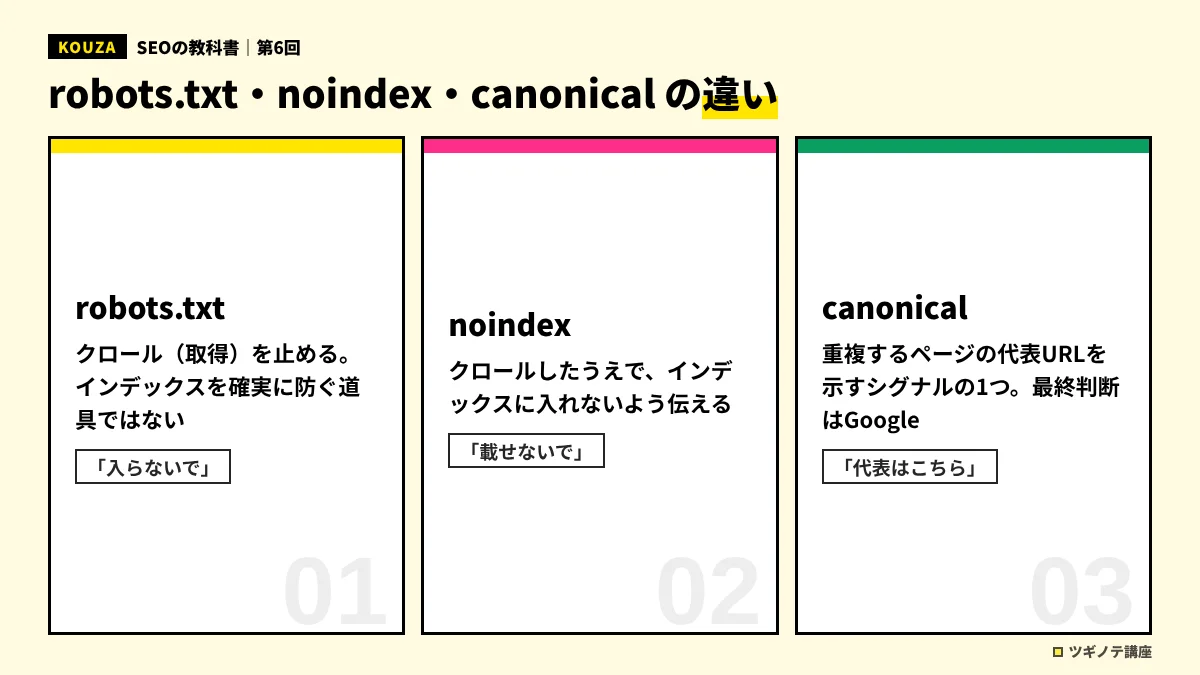
技術面のSEOで特に混同されやすいのが、次の3つです。それぞれ「何をコントロールするのか」が違います。
| 道具 | 何をコントロールするか | 使う場面の例 | 注意点 |
|---|---|---|---|
| robots.txt | クロール(ページを取得してよいか) | サイト内検索の結果ページなど、無限に生まれるURLのクロールを避ける | インデックスを防ぐ道具ではない。ブロックしたURLも、ほかからリンクされていれば、内容なしで検索結果に出ることがある |
| noindex(meta robotsタグなど) | インデックス登録(検索結果に載せてよいか) | サンクスページ、テスト用ページ、中身の薄いタグ一覧ページなど | Googlebotがページを取得できないと、noindexの指示も読めない。robots.txtでブロックしたページにnoindexを書いても効かない |
| canonical(rel=”canonical”) | 重複・類似ページのうち、どれを代表にしてほしいか | 並び替えのパラメータが付いたURL、印刷用ページ、同じ内容の別URL | Googleが正規URLを選ぶときのシグナルの1つ。最終的な代表はGoogleが判断する |
最もよくある失敗は、「検索結果に出したくないページを、robots.txtでブロックする」ことです。robots.txtはクロールを止めるだけなので、Googlebotはページの中身を見られません。その結果、noindexの指示も読めず、ほかのページからリンクされていればURLだけが検索結果に出てしまうことがあります。検索結果に出したくないページには、クロールは許可したうえでnoindexを使う、と覚えておきましょう。
問い合わせ完了後の「サンクスページ」を検索結果に出したくありません。最も適切な方法はどれでしょう?
- robots.txtでそのページのクロールをブロックする
- 何もしない
- クロールは許可したまま、ページにnoindexを指定する
答えと解説
正解は3です。robots.txtはクロールを止める道具で、インデックス登録を防ぐものではありません。ブロックするとnoindexの指示も読めなくなります。検索結果に出したくないページは、クロールを許可したうえでnoindexを使います。
関門3:JavaScriptと「見えている中身」
最近のWebサイトは、JavaScriptを使って画面の中身を表示するものが増えています。Googleは、Googlebotがページを取得したあと、JavaScriptを実行して表示された状態(レンダリング後)のページも読み取ると説明しています。ただし、作り方によっては中身がうまく読み取れない場合もあります。
確認の方法はシンプルです。Search ConsoleのURL検査ツールで、ページを指定して、Googlebotから見えたページの状態を確かめます。本文や見出し、リンクが表示されていれば、まずは問題ありません。大事な本文やリンクがJavaScriptの実行後にしか現れない作りの場合は、制作会社と相談して、最初に返すHTMLに中身を含める方法(サーバー側での表示など)を検討するのが安心です。
関門4:インデックス登録と「代表ページ」
Googleは、内容がほとんど同じページが複数あると、それらを1つのグループにまとめ、その中から代表となるページ(正規ページ)を選んで検索結果に表示します。たとえば次のようなURLは、人から見ると同じページでも、検索エンジンからは別のURLとして扱われます。
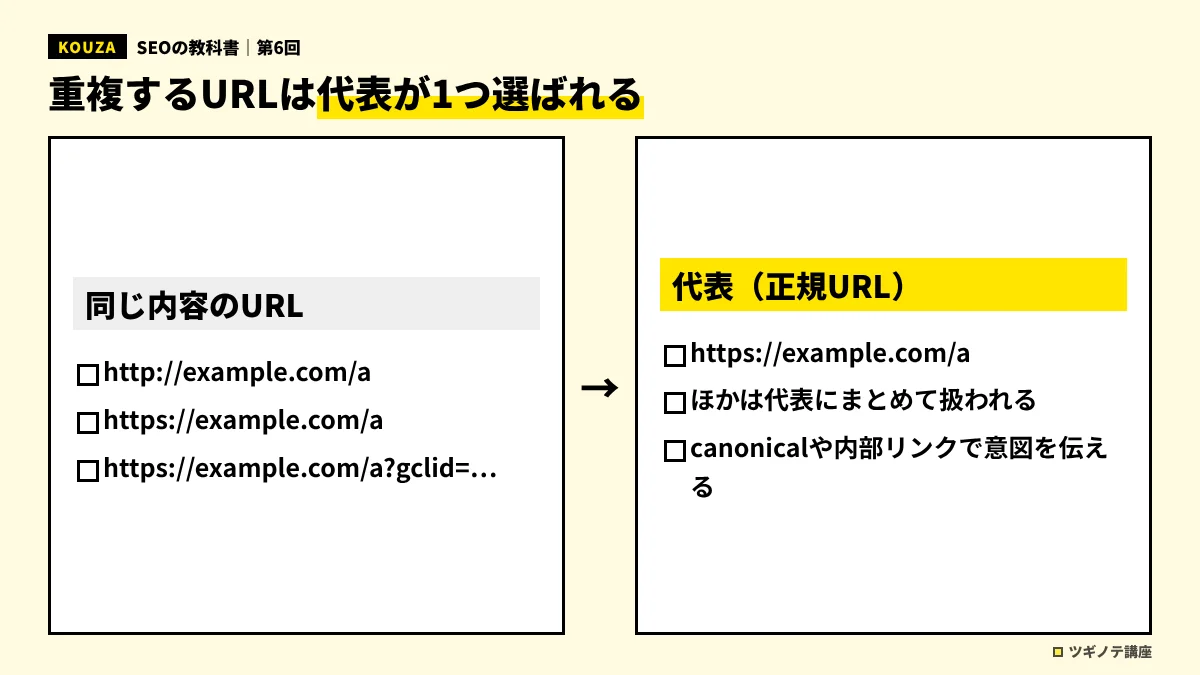
http://example.com/とhttps://example.com/(httpとhttpsの違い)https://example.com/とhttps://www.example.com/(wwwの有無)https://example.com/dresses/とhttps://example.com/dresses/?gclid=ABCD(広告の計測用などのパラメータ)
こうした重複は、どのURLを代表にするかを統一しておくと整理できます。サイト全体の表記の統一(http→https、wwwの有無)は301リダイレクト(恒久的な転送)で行い、並び替えなどの重複はcanonicalで代表を示すのが一般的です。代表をはっきりさせることで、評価が分散せず、意図したURLが検索結果に表示されやすくなります。
「インデックスされない」のは技術の問題とは限らない
技術的には何も問題がないのに、インデックスされないページもあります。Googleは、すべてのページをインデックスするわけではなく、品質や重複の状況などを見て判断しています。ほかのページとほとんど同じ内容のページや、中身の薄いページは、技術的に正しくても登録されないことがあります。この場合に必要なのは、技術の修正ではなく、第4回・第5回で学んだ内容の改善です。
canonical(rel=”canonical”)の説明として正しいものはどれでしょう?
- 重複・類似ページのうち、どれを代表にしてほしいかをGoogleに伝えるシグナル
- ページのクロールを完全に禁止する命令
- 指定すれば必ずそのとおりに検索結果が表示される命令
答えと解説
正解は1です。Googleはrel=”canonical”を正規URLを示す強いシグナルとして扱いますが、リダイレクトやサイトマップなどほかのシグナルとあわせて、最終的な代表はGoogleが判断します。クロールを止める道具でもありません。
実務ではこう使う:Search Consoleで原因を切り分ける
「記事が検索に出てこない」と感じたら、Search Consoleで次の順番に確かめると、原因を効率よく切り分けられます。
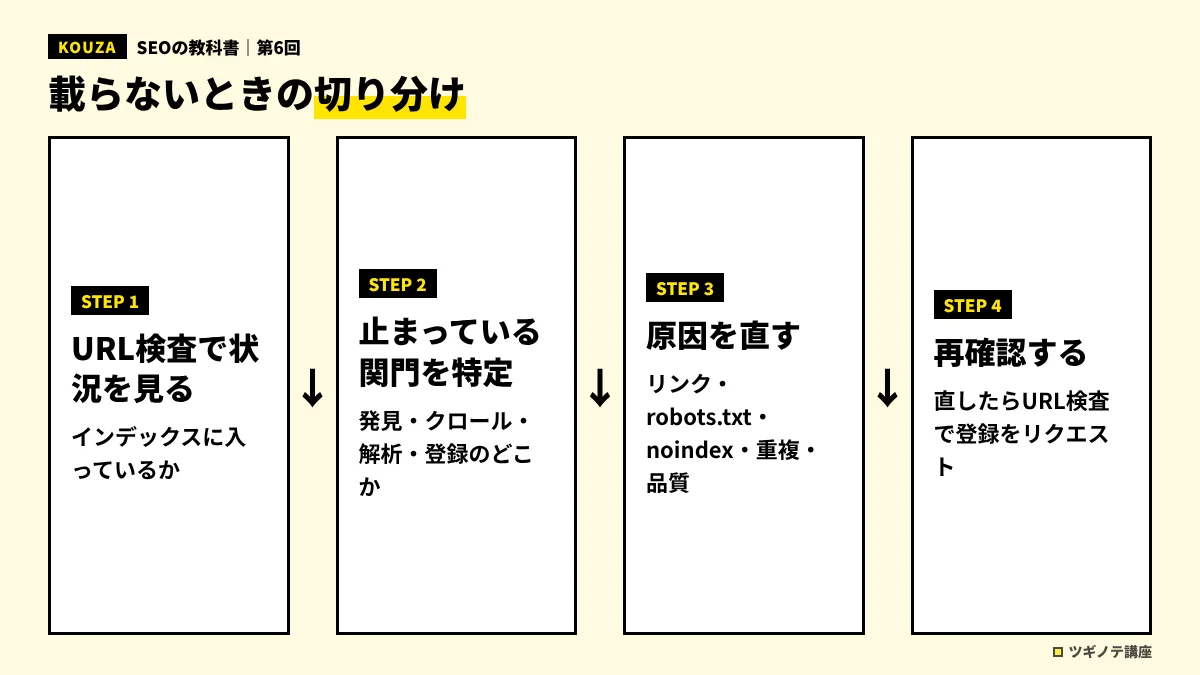
- URL検査ツールで、そのURLの状態を見る:「URL は Google に登録されています」と出れば、インデックスには入っています。その場合は順位や内容の問題なので、第2回・第4回・第5回に戻って見直します。
- 登録されていない場合、理由を見る:URL検査ツールやページのインデックス登録レポートには、登録されていない理由が表示されます。代表的なものと対応は次のとおりです。
- 「noindex タグによって除外されました」:意図したものか確認し、意図しないなら設定を外す
- robots.txtによるブロックを示す表示:robots.txtの記述を見直す
- 重複や代替ページ(正規ページが別にある)を示す表示:どのページが代表に選ばれたかを確認し、canonicalや内部リンク、内容の違いを見直す
- 「クロール済み – インデックス未登録」:クロールはされたが登録が見送られた状態。内容の独自性や品質、ほかのページとの重複を見直す
- 「検出 – インデックス未登録」:URLは知られているが、まだクロールされていない状態。内部リンクを増やす、サイト全体の品質を上げる、などで改善を図る
- 修正したらインデックス登録をリクエストする:URL検査ツールから登録をリクエストできます。ただし、リクエストしても登録が保証されるわけではなく、同じURLを何度もリクエストしても早くはなりません。
- サイト全体の傾向を定期的に見る:ページのインデックス登録レポートで、登録されていないページが急に増えていないかを月に1回は確認します。サイトのリニューアルや設定変更の直後は特に注意が必要です。
こうした技術的な点検を自社で回すのが難しい場合は、テクニカルSEOに強い会社やツールを使う方法もあります。SEO会社のおすすめ比較やSEOツールのおすすめ比較で、技術面の対応範囲も比べています。
もう一歩深く:サイトのリニューアルは技術SEOの最大の山場
サイトのリニューアルやドメインの変更では、URLが大量に変わり、インデックスが大きく揺れることがあります。古いURLから新しいURLへの301リダイレクトを1対1で設定する、新しいサイトでnoindexが外れているかを公開前に確認する、サイトマップを新しいURLで送り直す、といった準備を怠ると、検索流入が大きく落ち込むこともあります。リニューアルを計画するときは、デザインだけでなく「URLの対応表」を必ず作ることを、制作会社との打ち合わせの議題に入れておきましょう。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- ページが検索結果に載るまでには「発見・クロール・レンダリング・インデックス登録」の関門がある。
- 順位を気にする前に、まずインデックスに入っているかを確かめる。
- robots.txtはクロール、noindexはインデックス登録、canonicalは代表ページを示すシグナル。混同しない。
- 検索結果に出したくないページは、クロールを許可したうえでnoindexを使う。
- Search ConsoleのURL検査ツールとページのインデックス登録レポートで、原因を切り分けて直す。
確認テスト
Q1. robots.txtの役割として正しいものはどれでしょう?
- ページのインデックス登録を確実に防ぐ
- 検索エンジンのクローラーに、どのURLをクロールしてよいかを伝える
- 検索順位を上げるための設定ファイル
答えと解説
正解は2です。robots.txtはクロールをコントロールする道具です。インデックス登録を防ぐ確実な方法ではなく、検索結果に出したくないページにはnoindexを使います。
Q2. 数百ページの企業サイトで、最初に優先すべき技術面の対策はどれでしょう?
- クロールバジェットを細かく計算して管理する
- サイトマップを毎日何度も送信し直す
- 孤立したページをなくし、重要なページがインデックスに入っているかを確かめる
答えと解説
正解は3です。Googleは、クロールバジェットの管理が必要なのは主に非常に大規模なサイトだと説明しています。一般的な規模のサイトでは、リンク構造とインデックスの状態の確認が先です。
Q3. Search Consoleで「クロール済み – インデックス未登録」と表示されたページについて、まず見直すべきことはどれでしょう?
- 内容の独自性や品質、ほかのページとの重複
- robots.txtでブロックしていないか
- サーバーの電源が入っているか
答えと解説
正解は1です。この状態は、クロールはされたものの登録が見送られたことを示しています。技術的にはたどり着けているので、内容の独自性や品質、重複の見直しが優先です。
Q4. サイトのリニューアルでURLが変わるとき、特に重要な準備はどれでしょう?
- 古いページをすべて削除してから、新しいサイトを公開する
- 古いURLから新しいURLへの301リダイレクトを1対1で設定する
- 新しいサイトの全ページにnoindexを付けておく
答えと解説
正解は2です。古いURLの評価を新しいURLに引き継ぐために、対応する新しいURLへ301リダイレクトを設定します。新しいサイトにnoindexが残っていると、検索結果から消えてしまうので注意が必要です。
次回予告
第7回は「表示速度・スマホ対応・構造化データ」です。ページ エクスペリエンス(ページの使いやすさ)の中心にあるCore Web Vitalsの見方と、検索結果での見え方を豊かにする構造化データの基本を、優先順位とあわせて解説します。
参考資料
- Google 検索セントラル「Google 検索の仕組みに関する詳細ガイド」 https://developers.google.com/search/docs/basics/how-search-works?hl=JA(2026年11月12日確認)
- Google 検索セントラル「noindex を使用してコンテンツをインデックスから除外する」 https://developers.google.com/search/docs/crawling-indexing/block-indexing?hl=ja(2026年11月12日確認)
- Google 検索セントラル「rel=”canonical” などを利用して正規 URL を指定する方法」 https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls?hl=ja(2026年11月12日確認)
- Google 検索セントラル「大規模なサイト所有者向けのクロール バジェット管理ガイド」 https://developers.google.com/search/docs/crawling-indexing/large-site-managing-crawl-budget?hl=ja(2026年11月12日確認)
- Google 検索セントラル「URL の再クロールを Google にリクエストする」 https://developers.google.cn/search/docs/guides/submit-URLs?hl=ja(2026年11月12日確認)
- Google 検索セントラル「Google 検索結果のタイトルリンク(見出し)の変更」 https://developers.google.com/search/docs/advanced/appearance/title-link?hl=ja(2026年11月12日確認)
- SEOcrawl「『クロール済み – インデックス未登録』とは?意味と修正方法」(Search Console の表示名の確認に使用) https://seocrawl.ai/ja/blog/google-search-console-crawled-currently-not-indexed(2026年11月12日確認)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較