
画像・動画生成AIのしくみ:拡散モデルは「ノイズから絵を描く」|画像・動画生成AIのビジネス活用 第1回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かることは3つです。①いまの画像生成AIの多くが使っている「拡散モデル」が、ノイズを少しずつ取り除いて絵をつくるしくみ、②言葉の指示で絵を導く方法と、動画への広がり、③しくみから見えてくる、画像・動画生成AIの得意なことと苦手なことです。仕事で使うときに「なぜ思った絵が出ないのか」「なぜ毎回違う絵になるのか」を理解する土台になります。
画像生成AIは「ノイズを少しずつ消して」絵をつくる
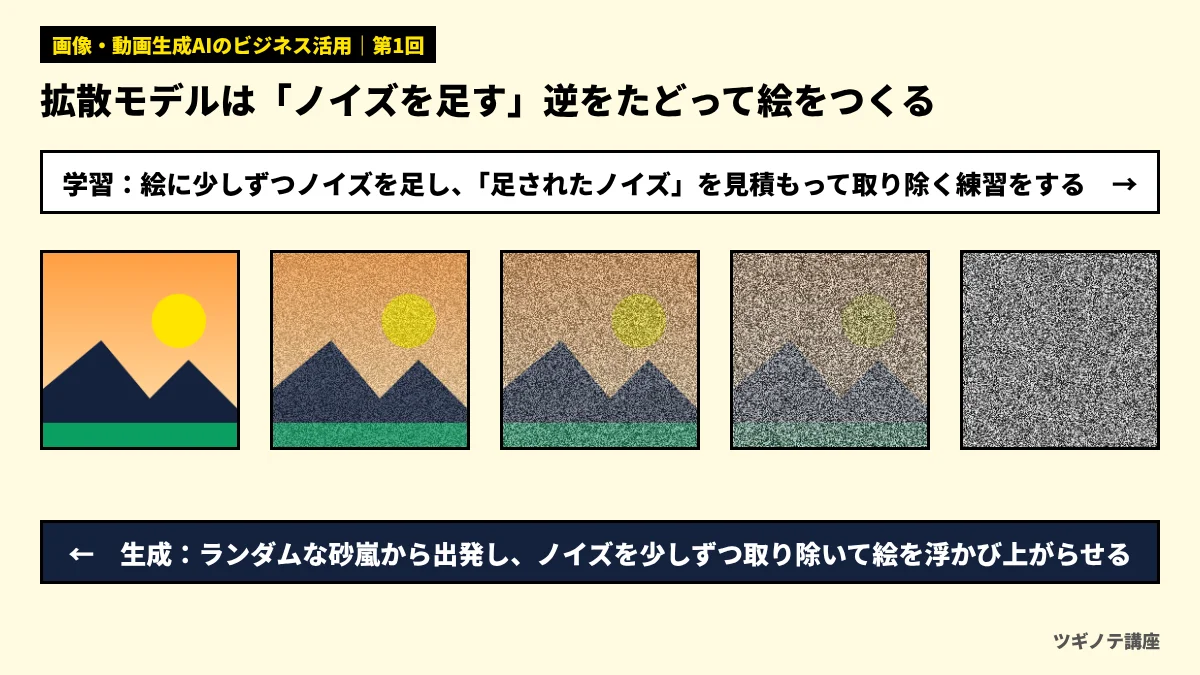
画像生成AIというと、「どこかにある画像を探してきて、切り貼りしている」と想像する人もいます。しかし、いま広く使われている画像生成AIの多くは、そうした切り貼りではなく、「ノイズ(ザラザラした砂嵐のような模様)を少しずつ取り除いていく」ことで、一枚の絵を描いています。このしくみを「拡散モデル」と呼びます。
学習のときは「わざと汚して、元に戻す練習」をする
拡散モデルの学習は、たとえるなら「汚れた写真を元に戻す修復職人」の修行です。
- 学習用の画像に、ほんの少しノイズを加えます。
- さらにノイズを加え、また加え……と何段階も繰り返すと、最後は元の絵がまったく分からない砂嵐になります。
- AIは、「ノイズが少し加わった画像から、加わったノイズを見積もって取り除く」練習を、さまざまな段階・さまざまな画像で大量に繰り返します。
この考え方を広めた代表的な研究の1つが、2020年に発表された「Denoising Diffusion Probabilistic Models(DDPM)」という論文です。
生成のときは「砂嵐から絵を浮かび上がらせる」
修行を積んだ職人は、最後には「完全な砂嵐」から出発しても、ノイズを少しずつ取り除いていくことで、それらしい絵を浮かび上がらせられるようになります。霧が少しずつ晴れて、景色が見えてくるようなイメージです。
ここで大切なのは、出発点の砂嵐が毎回ランダムに違うことです。同じ指示を出しても、出発点が違えば、浮かび上がる絵も変わります。「同じ指示なのに、毎回違う画像が出る」のは、このためです。サービスによっては、出発点を決める値(シードと呼ばれます)を固定して、似た結果を再現できるものもあります。
技術的な仕組みをもう少し詳しく知りたい方は、姉妹講座の拡散モデルとテキストから画像の回で、図とたとえを使って説明しています。
言葉で絵を導く:テキストから画像へ
ノイズを取り除くだけなら、「何かそれらしい絵」はできても、「夕暮れの海辺を歩く犬」のような狙った絵にはなりません。そこで、ノイズを取り除く一歩一歩を、言葉の指示で導くしくみが加えられています。
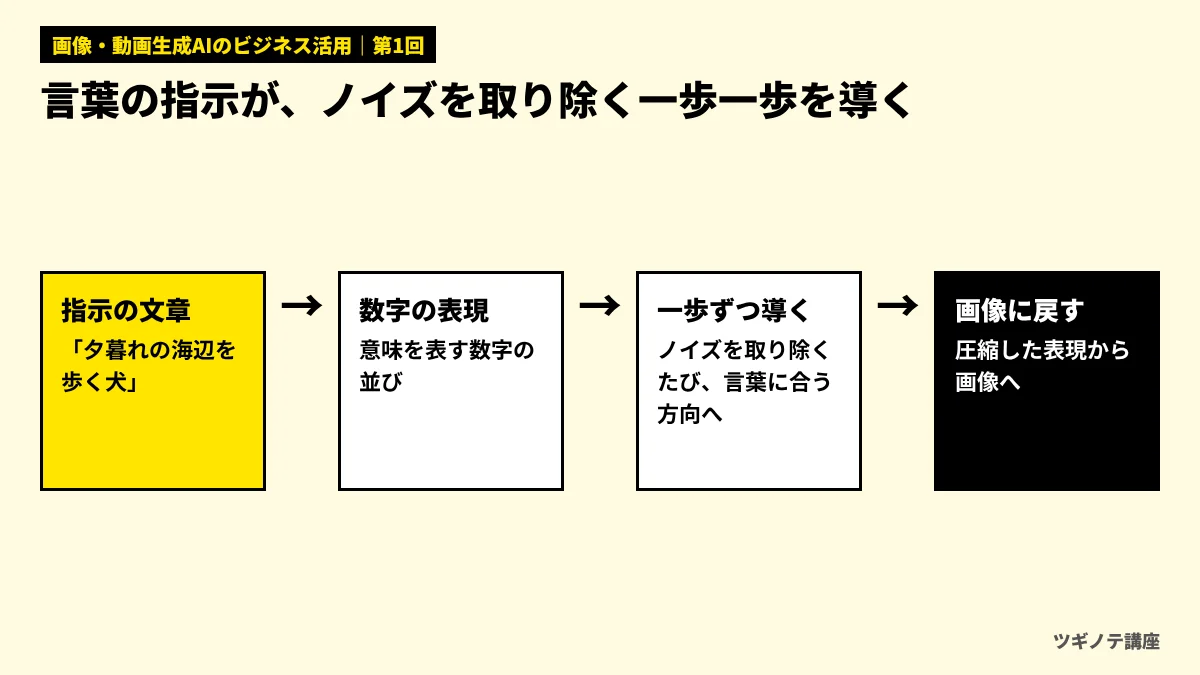
流れは、おおまかに次のとおりです。
- 言葉を数字の表現に変える。 指示の文章は、意味を表す数字の並びに変換されます(文章の生成AIでも使われる考え方です)。
- 一歩ごとに、言葉の表現を参考にする。 ノイズを取り除くたびに、「海辺」「夕暮れ」「犬」といった言葉の表現に合う方向へ、絵を少しずつ寄せていきます。
- 圧縮した世界で描いて、最後に画像に戻す。 2022年に発表された「潜在拡散モデル」の論文では、画像をそのまま扱うのではなく、学習済みの仕組みで小さく圧縮した表現の上で拡散モデルを動かすことで、計算量を大きく減らす方法が示されました。また、言葉などの条件を取り入れるしくみ(クロスアテンション)を組み込むことで、テキストから画像をつくれるようにしています。この考え方は、その後の多くの画像生成AIの土台になりました。
このしくみから分かるのは、生成AIは指示の言葉を「意味の方向」として受け取っている、ということです。言葉に書かれていない部分(背景の細部、人物の服の色など)は、学習した大量の画像の「よくあるパターン」で埋められます。思った絵が出ないときは、多くの場合、大事な部分が言葉で指定されていないか、指定の仕方があいまいなのです(第3回で詳しく扱います)。
同じ指示を同じ画像生成AIに出したのに、毎回違う画像が出てきます。しくみから考えたもっとも大きな理由はどれでしょう?
- 画像生成AIが、毎回違うWebサイトから画像を探してきているから
- 生成の出発点となるノイズ(砂嵐)が毎回ランダムに違い、そこから浮かび上がる絵も変わるから
- 画像生成AIが、前の画像を覚えていて、同じものを出さないようにしているから
答えと解説
正解は2。拡散モデルは、ランダムなノイズから出発して少しずつノイズを取り除きます。出発点が違えば結果も変わります。出発点を決める値(シード)を固定できるサービスでは、似た結果を再現しやすくなります。
動画へ:時間の方向にも広げる
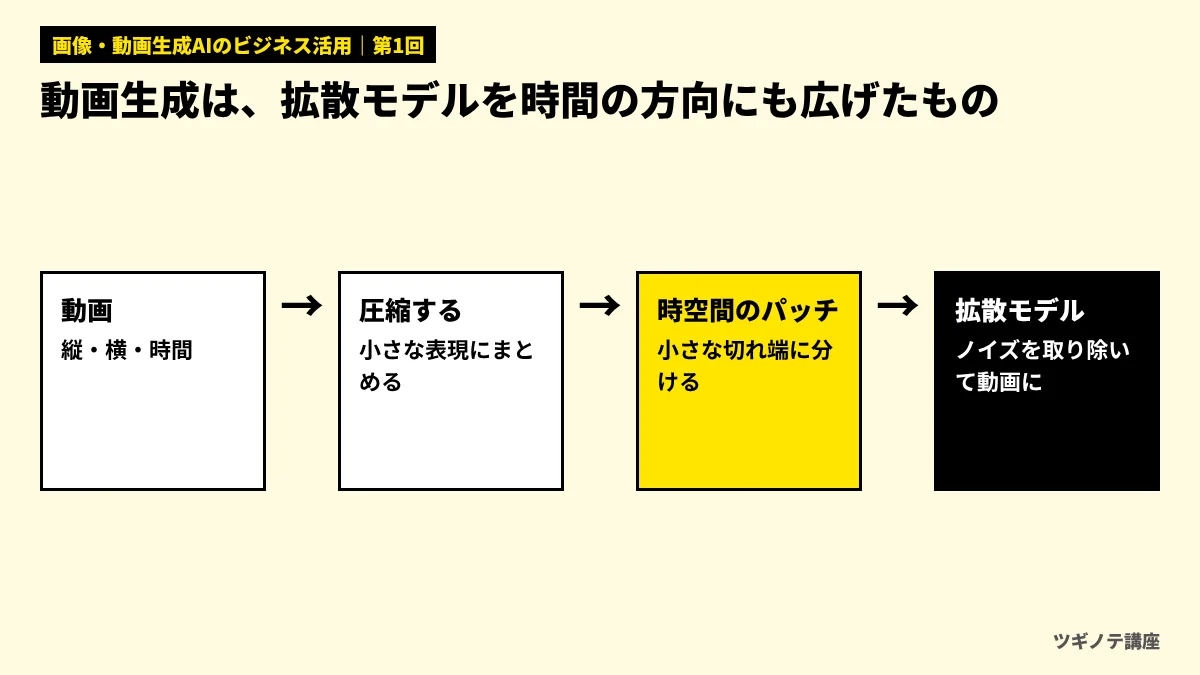
動画生成AIも、基本的には同じ考え方を時間の方向に広げたものです。OpenAIが2024年2月に公開した動画生成モデル「Sora」の技術レポートでは、次のような説明がされています。
- 動画を、空間(縦・横)と時間の両方の方向に圧縮した表現に変える
- その表現を「時空間のパッチ(小さな切れ端)」に分け、それを単位として扱う
- ノイズの入ったパッチから、きれいなパッチを予測する拡散モデル(Transformerを使ったもの)で動画をつくる
同じレポートでは、課題として、ガラスが割れるような基本的な物理の動きを正確に再現できないことや、長い動画で一貫性が崩れることなどが挙げられていました。その後、各社の動画生成AIは急速に改良され、音声つきの動画を生成できるものも増えています。
一方で、この分野はサービスの入れ替わりもとても速いのが特徴です。たとえばOpenAIは、Soraのアプリとウェブ版の提供を2026年4月26日に終了したと公式ページで告知しています。仕事で使うツールを選ぶときは、機能だけでなく、提供が続くかどうかや、つくったデータを手元に保存できるかにも目を配る必要があります(第2回で扱います)。
「つくる」だけでなく「直す」にも使える
拡散モデルのしくみは、ゼロから絵をつくるだけでなく、すでにある画像を直すことにも応用されています。仕事では、むしろこちらのほうがよく使われるかもしれません。代表的な機能は次の3つです。サービスによって呼び方は違います。
| 機能 | 何をするか | 仕事での例 |
|---|---|---|
| 一部の描き直し(インペインティング) | 画像の一部を選んで、その部分だけを指示どおりに描き直す | 商品写真の背景にある不要な物を消す、空の色を変える |
| 画像の拡張(アウトペインティング) | 画像の外側を、元の絵に合うように描き足す | 縦長の写真を、横長のバナーに使えるよう左右を広げる |
| 画像から画像へ | 元の画像の構図や雰囲気を手がかりに、新しい画像をつくる | 手描きのラフから、清書したイメージ案をつくる |
一部の描き直しは、「選んだ部分にだけノイズを加え、周りの絵に合うように取り除き直す」と考えると分かりやすいでしょう。周りの絵が手がかりになるので、ゼロからつくるより狙いどおりになりやすいのが特徴です。
ただし、実在の人物の写真の顔や体を描き換える、商品の形や色を実物と違うように変える、といった使い方は、権利や誤解の問題につながります。直す機能は便利なぶん、「どこまで変えてよいか」を決めておく必要があります(第5回・第6回で扱います)。
しくみから分かる、得意なことと苦手なこと
拡散モデルのしくみを知ると、画像・動画生成AIの得意・不得意が、ある程度予想できるようになります。
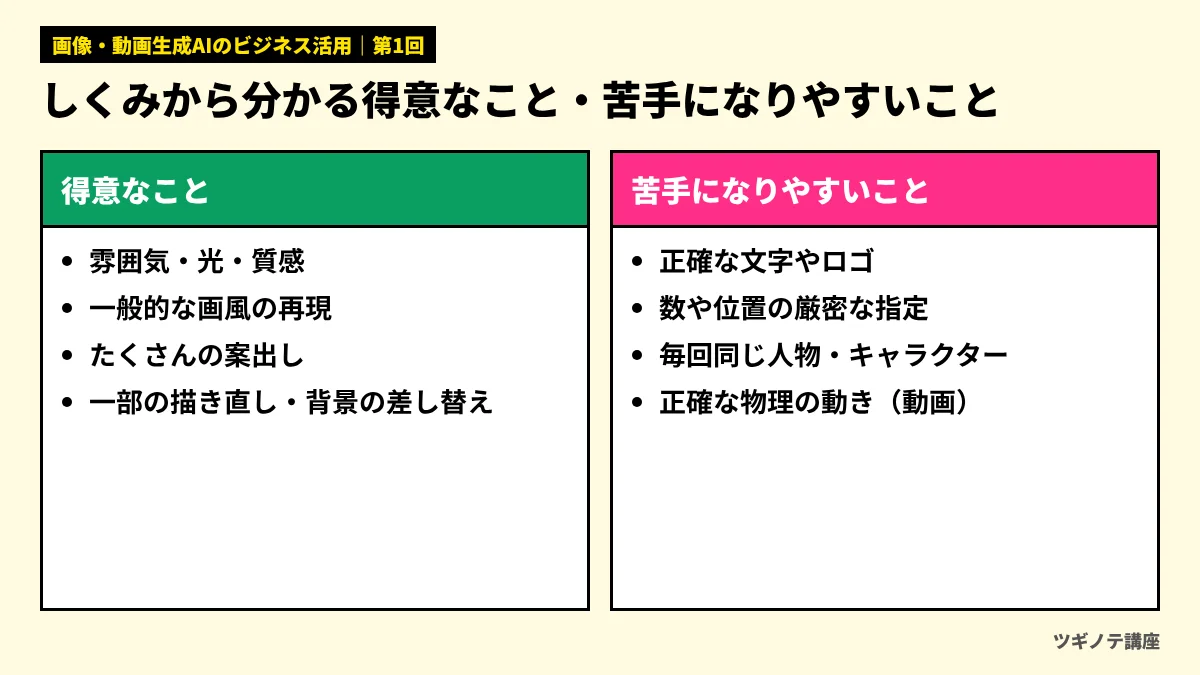
得意なこと
- 雰囲気・光・質感の表現(「朝の柔らかい光」「木のぬくもり」)
- 一般的な画風の再現(写真風、水彩画風、フラットなイラスト風など)
- 少しずつ違う案を大量に出すこと
- 写真の一部の描き直しや、背景の差し替え・拡張
苦手になりやすいこと
- 正確な文字やロゴ:モデルによって改善が進んでいますが、細かい文字やブランドのロゴを正確に描くのは、まだ不安定なことがあります。
- 数や位置の厳密な指定:「左から3番目の人だけ赤い服」のような指定は、外れることがあります。
- 毎回同じ人物・キャラクター:出発点が毎回違うため、同じ顔や服装を何枚も保つのは難しく、参考画像を使う機能などの工夫が必要です。
- 正確な物理の動き(動画):手の動き、物が壊れる様子、複雑な動作は、不自然になることがあります。
写真のように見えても、写真ではない
画像生成AIの絵は、どれほど写真らしく見えても、実際にその場面をカメラで撮ったものではありません。商品の実物、実在の店舗、実際のイベントの様子を伝える場面で生成画像を使うと、見る人に誤解を与えるおそれがあります。この点は、第5回・第6回の権利と表示の話につながります。
画像生成AIで新商品のチラシをつくるとき、もっとも慎重に扱うべき使い方はどれでしょう?
- 背景の雰囲気をつくるイメージ画像に使う
- レイアウトのラフ案をたくさん出して比べる
- 実物の商品の写真の代わりに、生成した商品画像を「この商品です」として載せる
答えと解説
正解は3。生成画像は写真のように見えても、実物を撮ったものではありません。実物と違う見た目で商品を紹介すると、見る人に誤解を与えるおそれがあります。雰囲気づくりやラフ案は、生成AIが得意な使い方です。
よくある誤解
誤解1「画像生成AIは、ネット上の画像を切り貼りしている」
拡散モデルは、画像を切り貼りするのではなく、学習した大量の画像のパターンをもとに、ノイズから新しい絵を描きます。ただし、学習に使われた特定の画像とよく似た絵が出てくることも、まれにありえます。特に、有名な作品やキャラクターの名前を指示に入れた場合です。だからこそ、権利の確認が必要になります(第5回)。
誤解2「指示を細かく書けば、思いどおりの1枚が必ず出る」
指示を工夫すれば、狙いに近づける確率は上がります。しかし、出発点のランダムさがある以上、「必ず」はありません。複数の案を出して選ぶ、気に入った案の一部だけを描き直す、といった進め方が現実的です。
誤解3「動画生成AIなら、長い広告動画も一発でつくれる」
いまの動画生成AIは、短い場面をつくるのは得意になってきましたが、長い動画で人物や物の一貫性を保つのは、まだ難しいことがあります。短い場面を組み合わせ、編集は人が行う、という使い方が中心です。
実務ではこう使う
- 「案出し」と「仕上げ」を分けて考える。 生成AIは、たくさんの案を短時間で出すのが得意です。最終的な仕上げ(文字入れ、ロゴ、色の調整)は、デザインソフトや人の手で行うと品質が安定します。
- 文字とロゴは、あとから載せる。 生成した画像には文字を入れず、文字やロゴは別のソフトで重ねるのが確実です。
- 気に入った画像は、指示とシード(使える場合)を記録する。 似た画像をもう一度つくりたいときに役立ちます。記録の仕方は第6回で扱います。
- 実物・実在を伝える場面では使わない、または明記する。 商品の実物、実在の人物、実際の出来事を伝える場面は、写真や実際の素材を使うのが基本です。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- いまの画像生成AIの多くは「拡散モデル」。ノイズを少しずつ取り除いて絵を描く。切り貼りではない
- 言葉の指示は数字の表現に変えられ、ノイズを取り除く一歩一歩を導く。圧縮した表現の上で描く工夫が、多くのモデルの土台になった
- 出発点のノイズが毎回違うため、同じ指示でも違う絵になる
- 動画生成は、拡散モデルを時間の方向に広げたもの。サービスの入れ替わりが速い
- 雰囲気・画風・案出しは得意。正確な文字やロゴ、厳密な配置、同じ人物の維持、正確な物理の動きは苦手になりやすい
確認テスト
拡散モデルの学習で行っていることの説明として、正しいものはどれでしょう?
- 画像に少しずつノイズを加え、加わったノイズを見積もって取り除く練習を大量に繰り返す
- インターネット上の画像を切り抜いて、部品として保存する
- 画像の色の数を数えて、平均の色を覚える
答えと解説
正解は1。拡散モデルは「汚して元に戻す」練習をします。生成のときは、その逆をたどって、ノイズだけの状態から絵を浮かび上がらせます。
2022年に発表された「潜在拡散モデル」の工夫として、正しいものはどれでしょう?
- 画像を一切使わずに、文章だけで学習する
- 生成した画像を、必ず白黒にする
- 画像を小さく圧縮した表現の上で拡散モデルを動かし、計算量を減らす。言葉などの条件を取り入れるしくみも組み込む
答えと解説
正解は3。圧縮した表現の上で描くことで計算量を大きく減らし、クロスアテンションというしくみで言葉などの条件を取り入れられるようにしました。多くの画像生成AIの土台になった考え方です。
画像生成AIで、資料の表紙に会社名入りのイラストを使いたいとき、もっとも確実な進め方はどれでしょう?
- 会社名のロゴも含めて、すべてを画像生成AIに描かせる
- 文字やロゴを入れずにイラストをつくり、会社名とロゴはあとからデザインソフトなどで正しい素材を載せる
- 会社名を長い文章で指示すれば、必ず正確に描かれる
答えと解説
正解は2。正確な文字やロゴは、モデルによっては不安定なことがあります。イラストと文字・ロゴを分け、文字とロゴは正しい素材を使って載せるのが確実です。
動画生成AIを仕事で使うときの考え方として、この回の内容に合うものはどれでしょう?
- 長い広告動画も、1回の指示で完成させられる
- 動画生成AIのサービスは、一度選べば長く変わらないので、提供の継続は気にしなくてよい
- 短い場面をつくって人が編集で組み合わせる使い方が中心。サービスの入れ替わりが速いので、提供の継続やデータの保存にも目を配る
答えと解説
正解は3。長い動画での一貫性はまだ難しいことがあり、短い場面を組み合わせる使い方が現実的です。また、Soraのアプリ提供終了の例のように、サービスの入れ替わりは速いので、データを手元に残す工夫も大切です。
次回予告
次回は、画像・動画生成AIのツールを、チャット型・専門ツール型・デザインツール組み込み型・業務システム組み込み型の4つのタイプに分けて整理します。商用利用の条件、学習データ、生成物の公開範囲など、仕事で使う前に確かめるべき点を学びます。
NEXT|第2回主要ツールの違いと選び方:4つのタイプと確かめるべき点次の回へ進む →参考資料
- Jonathan Ho ほか「Denoising Diffusion Probabilistic Models」(NeurIPS 2020)。
- Robin Rombach ほか「High-Resolution Image Synthesis with Latent Diffusion Models」(CVPR 2022)。圧縮した表現の上で拡散モデルを動かして計算量を減らすこと、クロスアテンションで言葉などの条件を取り入れることを確認。
- OpenAI「Video generation models as world simulators」(2024年2月15日)。動画を圧縮して時空間のパッチに分け、拡散Transformerで生成すること、物理の再現などの課題を確認。
- OpenAI「Launching Sora responsibly」。ページ上で、Soraの提供が2026年4月26日に終了したことの告知を確認。
- 確認日:2026年11月12日
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較