
A/Bテストと有意差:偶然の差か、本当の差か|マーケターのためのデータ分析・統計入門 第5回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かること:①A/Bテストの正しい手順と、なぜ「ランダムに分ける」のか、②p値と「有意差」が本当は何を意味しているのか(よくある誤解も含めて)、③途中で結果をのぞいて止める、たくさん比べすぎる、などのテストの失敗パターン。前回は、因果を確かめるには対象を無作為に分けて比べるのが最も強い方法だと学びました。今回は、その代表であるA/Bテストを、数式に頼らずに理解していきます。
A/Bテストとは
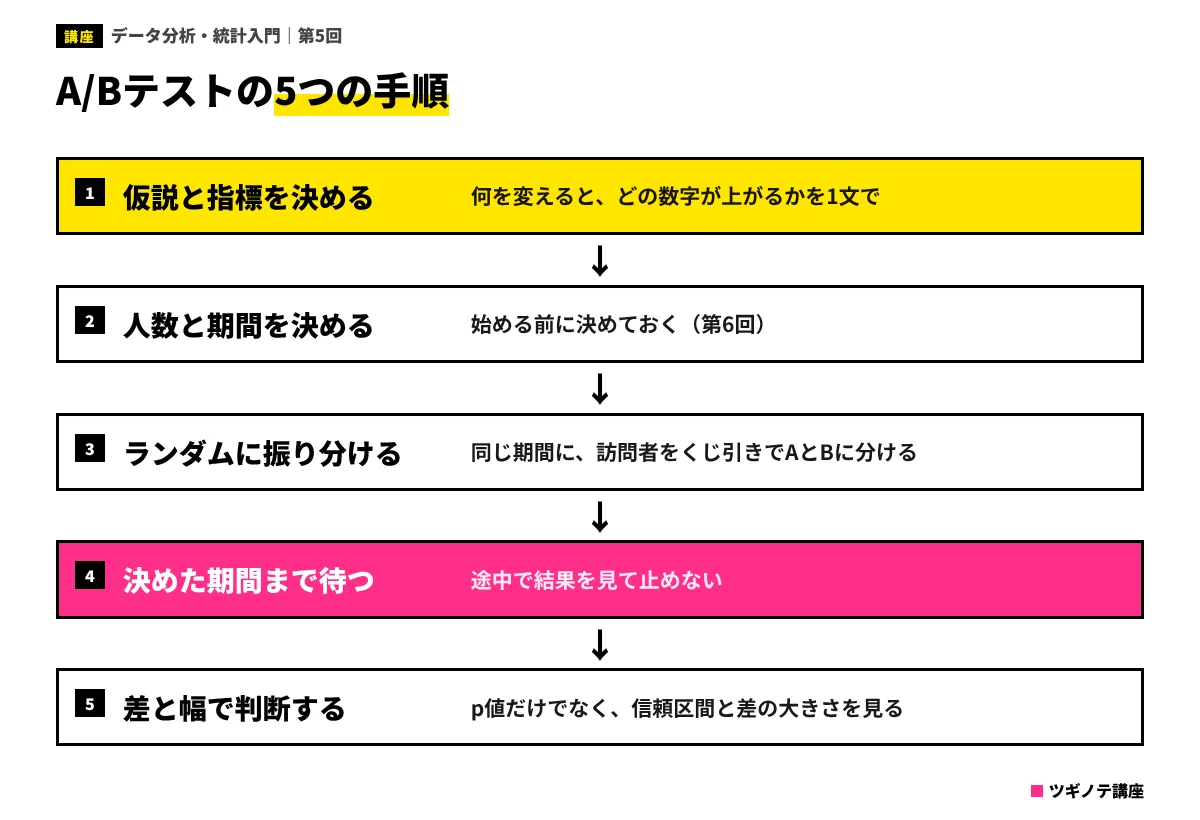
A/Bテストは、2つ(またはそれ以上)の案を、同じ期間に、無作為に分けた別々の人たちに見せて、成果を比べる方法です。ランディングページのボタンの色、メールの件名、広告の文言、料金ページの見せ方など、マーケティングのさまざまな場面で使われます。
前回学んだとおり、「無作為に分ける」ことがA/Bテストの心臓部です。訪問者をくじ引きのようにAとBに振り分けると、パソコンかスマホか、どの流入元から来たか、ブランドが好きかどうか、といった条件が、AとBの両方に同じように散らばります。そのうえで成果に差が出れば、その差は「案の違い」によるものだと考えやすくなります。先月はA、今月はBというように時期をずらして比べると、季節やキャンペーンの影響が混ざってしまうので、AとBは必ず同じ期間に出します。
ただし、無作為に分けても、まだ1つ問題が残ります。それが「偶然のぶれ」です。
同じものを比べても、差は出る
コインを100回投げると、表がちょうど50回出ることはむしろ珍しく、48回や53回になるのがふつうです。購入率も同じで、AとBがまったく同じページだったとしても、たまたまAに買う気の強い人が少し多く振り分けられれば、Aの購入率のほうが高く出ます。
つまり、A/Bテストで差が出たとき、考えられる可能性は2つあります。
- 本当に案の違いによる差がある
- 本当は差がないのに、偶然のぶれで差が出ただけ
この2つを見分けるための道具が、p値と有意差の考え方です。
p値は「差がない」と仮定したときの起こりにくさ
架空の例で考えます。A社がランディングページの新しい案Bを試し、次の結果が出ました。
| 訪問数 | 購入数 | 購入率 | |
|---|---|---|---|
| 案A(今のページ) | 10,000 | 200 | 2.0% |
| 案B(新しいページ) | 10,000 | 250 | 2.5% |
差は0.5ポイントです。これは偶然でも起こりうる差でしょうか。
そこで、いったん「本当はAとBに差はない」と仮定してみます(この仮定を「帰無仮説」と呼びます)。差がないなら、どちらの購入率も、合わせた平均の2.25%のはずです。この条件で、1万人ずつに分けて購入率を比べる実験を、コンピューターの中で20万回くり返したのが図2です。
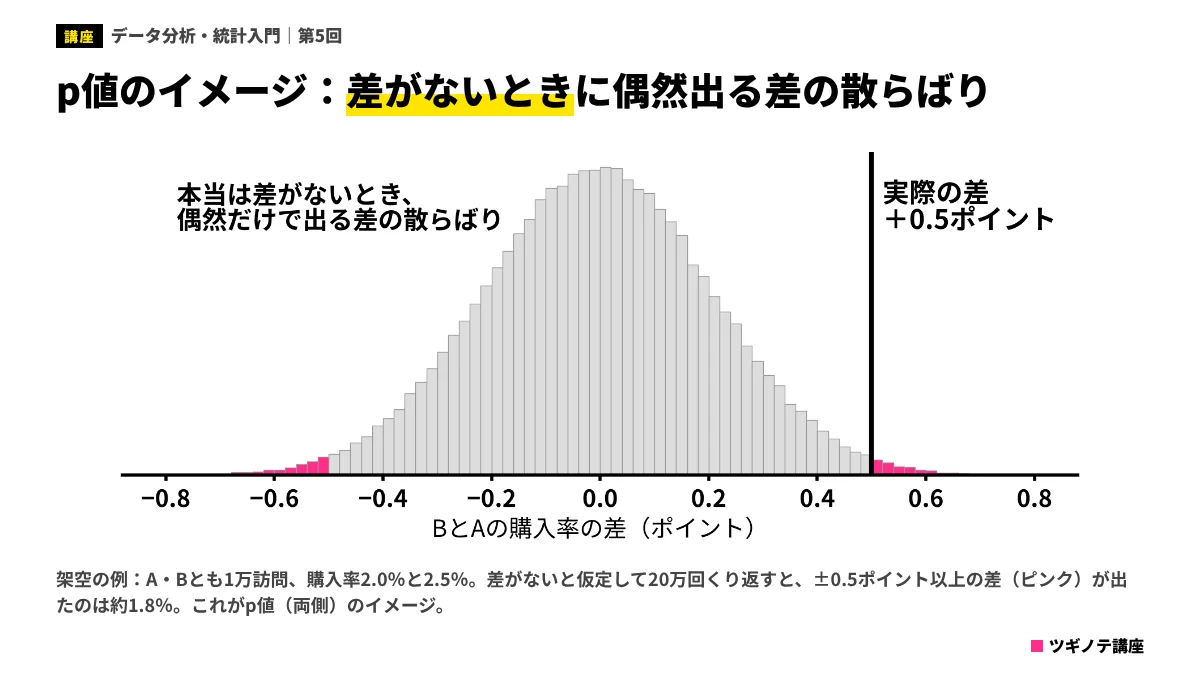
差がなくても、偶然のぶれによって、差は0を中心に±0.3ポイントくらいの範囲によく散らばります。では、実際に観測した「±0.5ポイント以上」の差が偶然だけで出たのは何回だったかというと、20万回のうち約1.8%でした。この「差がないと仮定したとき、実際の結果と同じかそれ以上に極端な差が偶然出る割合」が、p値の考え方です(この例のp値は約0.017で、シミュレーションの結果とほぼ一致します)。
p値が小さいほど、「差がない」という仮定のもとでは起こりにくい結果だった、ということになります。そこで、あらかじめ決めた基準(多くの場合0.05)より小さいとき、「差がないという仮定とデータは合わない。偶然だけでは説明しにくい」と判断します。これを「統計的に有意な差がある(有意差あり)」と表現します。基準の0.05は自然の法則ではなく、慣習として広く使われている目安です。
p値の説明として正しいものはどれでしょう?
- 案Bのほうが優れている確率
- 本当は差がないと仮定したとき、実際と同じかそれ以上に極端な差が偶然出る割合
- テストで得られた差の大きさ
答えと解説
正解は2です。p値は「差がない」という仮定のもとでの起こりにくさを表します。案Bが優れている確率でも、差の大きさでもありません。この区別は、次の節でもう一度整理します。
p値の「言えること」と「言えないこと」
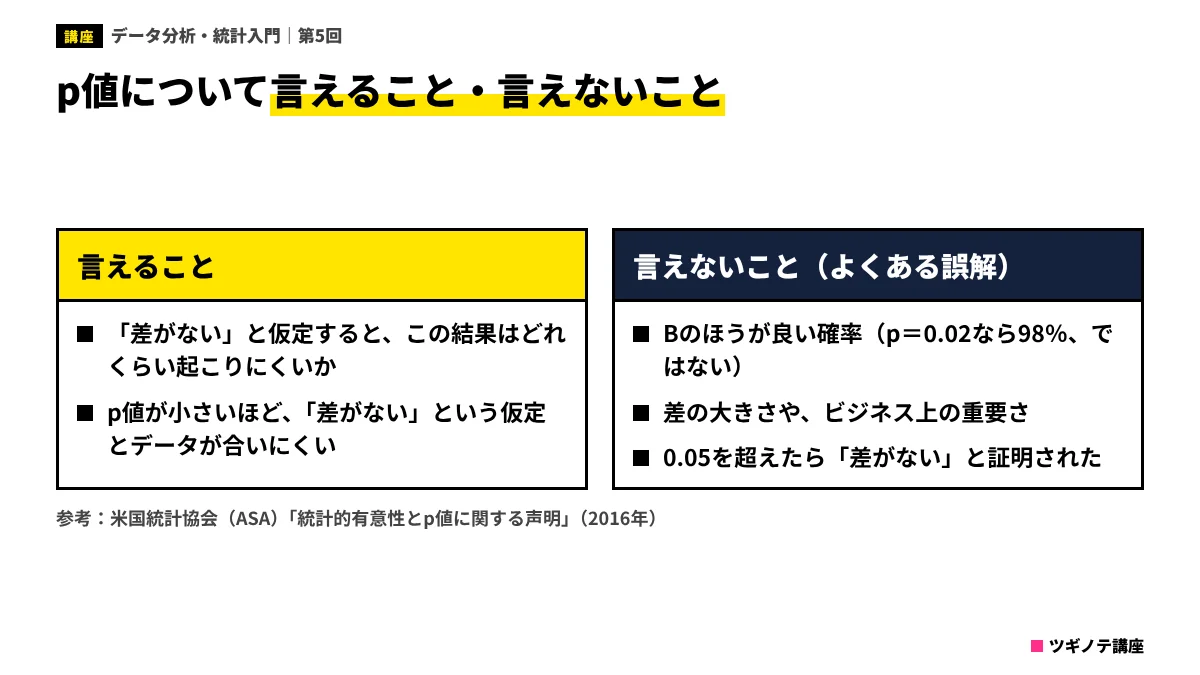
p値はとても誤解されやすい数字です。米国統計協会(ASA)は2016年に、p値の誤用が広がっていることを受けて「統計的有意性とp値に関する声明」を発表し、6つの原則を示しました。要点は次のとおりです。
- p値は、データが特定の統計モデル(ここでは「差がない」という仮定)とどれくらい合わないかを示しうる。
- p値は、仮説が正しい確率や、結果が偶然だけで生じた確率を表すものではない。
- ビジネスや政策の判断は、p値がある基準を下回ったかどうかだけで決めるべきではない。
- 正しい推論には、何を何回試したかを含めた、すべての報告と透明性が必要である。
- p値は、効果の大きさや結果の重要性を表さない。
- p値だけでは、モデルや仮説についての証拠としては弱い。
特に実務で多い誤解は次の3つです。
- 「p=0.02だから、Bが良い確率は98%」:誤りです。p値は「差がない」と仮定したうえでの計算なので、「Bが良い確率」を直接表すものではありません。
- 「有意差があったから、大きな効果がある」:誤りです。データが何十万件もあれば、0.01ポイントのようなごく小さな差でも有意になります。差の大きさは、差そのものと次に説明する信頼区間で見ます。
- 「p=0.3だったから、AとBに差はない」:誤りです。「偶然でも説明できる」というだけで、「差がない」と証明されたわけではありません。データが少なければ、本当は差があっても有意にならないことはよくあります。
最後の点を確かめてみましょう。同じ2.0%と2.5%でも、訪問数が1,000ずつ(購入20件と25件)だったら、p値は約0.45になります。差の見た目は同じでも、データが少ないと偶然のぶれが大きく、偶然と区別できないのです。必要なデータの量については、次回くわしく扱います。
差の大きさは「信頼区間」で見る
p値と合わせて見たいのが「信頼区間」です。図2の例で、購入率の差(+0.5ポイント)の95%信頼区間を計算すると、およそ+0.09〜+0.91ポイントになります。
信頼区間は、ざっくり言えば「データから考えて、本当の差はこのあたりにありそうだ」という幅です。この例なら「差は0より大きそうだが、0.1ポイント程度の小さな改善かもしれないし、0.9ポイント程度の大きな改善かもしれない」と読めます。区間が0をまたいでいなければ、有意水準5%で有意な差があることとほぼ対応します。
もう一歩深く:「95%信頼区間」の正確な意味
95%信頼区間は、「同じやり方でデータを取り直して区間を作ることを何度もくり返すと、そのうち約95%の区間が本当の差を含む」という意味の区間です。「この区間に本当の差が入っている確率が95%」という言い方は、厳密には正しくありません。ただ、実務では「本当の差のありそうな幅」と理解しておけば、判断を大きく誤ることはありません。
訪問数が1,000ずつのA/Bテストで、購入率が2.0%と2.5%、p値が約0.45でした。正しい読み方はどれでしょう?
- AとBに差がないことが証明された
- Bのほうが良い確率は55%である
- この程度の差は偶然でも十分に起こりうるので、このデータだけでは判断できない
答えと解説
正解は3です。p値が大きいことは「偶然でも説明できる」という意味で、「差がない」証明ではありません。データを増やすか、差がないことを前提に判断するかを、テスト前に決めた基準に沿って考えます。
A/Bテストでよくある失敗
正しく計算しても、テストの進め方を誤ると結果は信用できなくなります。代表的な失敗を見ていきましょう。
失敗1:途中でのぞいて、良いところで止める
もっとも多い失敗が、テスト中に毎日結果を確かめ、「有意差が出た!」と思った時点でテストを止めてしまうことです。
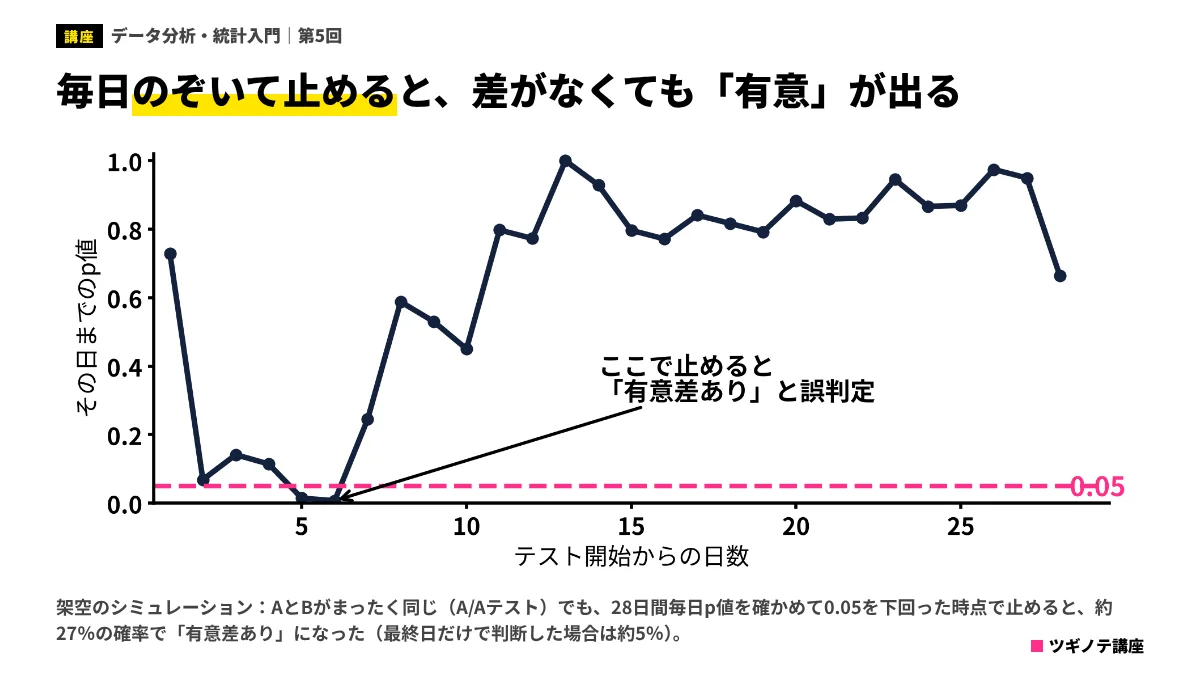
図4は、AとBがまったく同じページ(A/Aテスト)なのに、毎日p値を計算した例です。偶然のぶれで、5〜6日目にp値が0.05を下回っています。ここで止めれば「有意差あり」と報告してしまいますが、そのまま続けると最終日には0.66まで戻っています。
コンピューターで同じ条件のA/Aテストを5,000回くり返したところ、最終日だけで判断した場合に「有意差あり」と誤って判定されたのは約5%(有意水準どおり)でしたが、28日間毎日のぞいて0.05を下回った時点で止めるルールにすると、約27%で「有意差あり」になりました。のぞくたびに、偶然の当たりくじを引くチャンスが増えるからです。対策は、テストの期間(または必要な人数)を始める前に決め、そこまで判定しないことです。途中で判断する必要がある場合は、くり返し確認することを前提に作られた方法(逐次検定など)を使います。
失敗2:たくさん比べすぎる
案を10個同時に試したり、購入率・クリック率・滞在時間・直帰率など指標を20個見たりすると、本当は効果がなくても、どれか1つくらいは偶然「有意」になります。有意水準5%なら、20回比べれば平均して1回は偶然の「当たり」が出る計算です。テストの前に「主な指標を1つ」決めておき、ほかの指標は参考として扱いましょう。
テストのあとで「スマホの新規客だけで見るとBが勝っている」のように、切り口を探して有意な結果を見つけるのも同じ問題です。後から見つけた切り口は「次のテストで確かめる仮説」として扱います。
A/Bテストのあと、全体では有意差がなかったものの、「40代・スマホ・広告経由」に絞るとBが有意に勝っていました。適切な扱いはどれでしょう?
- 後から見つけた切り口なので偶然の可能性が高いと考え、次のテストで確かめる仮説として扱う
- 有意差が出たので、40代・スマホ・広告経由の訪問者にはBを出すと決める
- 全体の結果は無視し、この切り口の結果だけを報告する
答えと解説
正解は1です。切り口を何通りも探せば、偶然どこかで有意な結果が見つかります。後から見つけた結果は、あらためてその切り口を主な対象にしたテストで確かめましょう。
失敗3:振り分けの比率がずれている
50%ずつ振り分けたはずなのに、AとBの訪問数が大きくずれていることがあります(例:A 10,000、B 9,200)。これは、ツールの設定ミスや、特定のブラウザでBのページが表示されないなどの不具合のサインです。比率のずれがあると結果が信用できないので、まず原因を調べます。
失敗4:差の大きさとビジネス上の意味を見ない
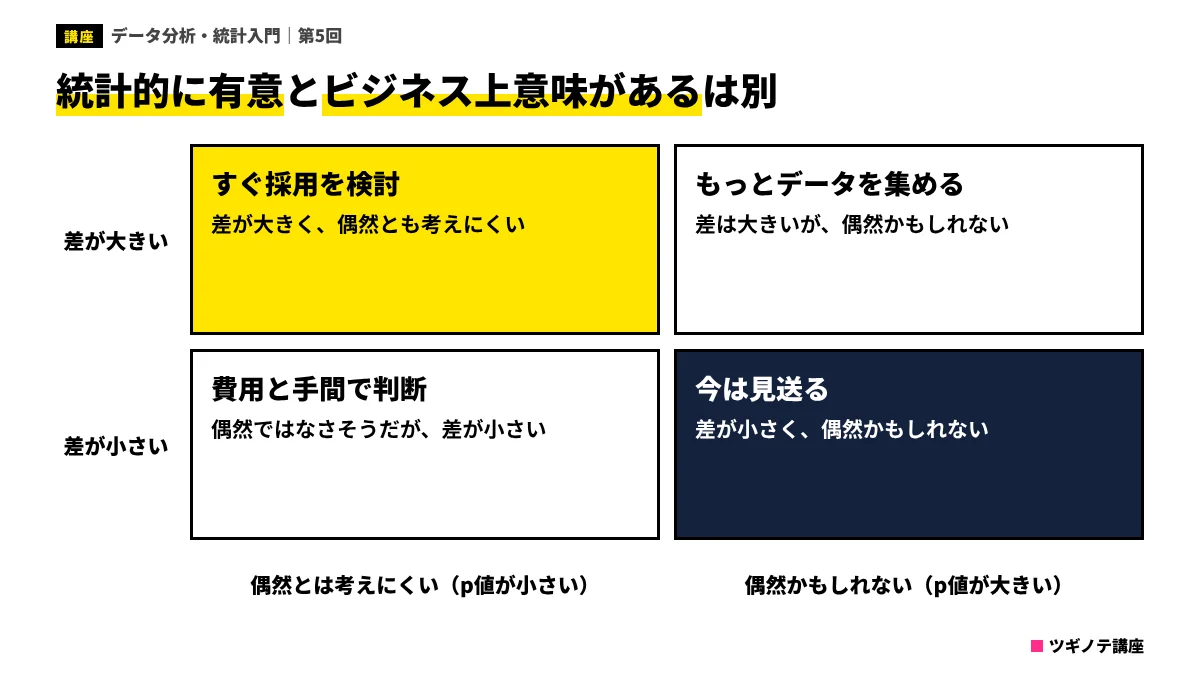
「有意差あり」は「偶然とは考えにくい」という意味にすぎず、「やる価値がある」という意味ではありません。図5のように、差の大きさと偶然の可能性を分けて考え、改修にかかる費用や手間と比べて判断します。
実務ではこう使う:テスト設計シートを先に書く
A/Bテストは、始める前の設計で結果の信頼性がほぼ決まります。次のような設計シートを、テスト開始前に関係者と共有しておきましょう。
| 項目 | 書くこと | 例(架空) |
|---|---|---|
| 仮説 | 何を変えると、なぜ、どの数字が上がるか | 料金を先に見せると、不安が減って購入率が上がる |
| 主な指標 | 判断に使う指標を1つ | 購入率(購入数÷訪問数) |
| 参考指標 | 悪化していないか見る指標 | 平均購入金額、返品率 |
| 振り分け | 対象と比率 | 新規訪問者のみ、50%ずつ |
| 期間・人数 | 始める前に決める(第6回) | 各案1万訪問、または最低2週間 |
| 判断基準 | 何を満たせば採用するか | 有意水準5%で有意、かつ差が+0.3ポイント以上 |
期間は、曜日による違いをならすために、少なくとも1週間単位で設定するのが無難です。Google が無料で提供していたA/Bテストツール「Google オプティマイズ」は2023年9月30日に提供を終了しているため、現在は有料・無料のLPOツールやA/Bテストツールを使うのが一般的です。ツールの選び方はLPOツールおすすめ比較で、A/Bテストで改善を重ねた会社の話はLPOツールの成功事例で紹介しています。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- A/Bテストは、同じ期間に無作為に分けた人たちに別の案を見せて比べる方法。無作為に分けることで条件がそろう。
- p値は「差がない」と仮定したとき、実際以上に極端な差が偶然出る割合。小さいほど偶然では説明しにくい。
- p値は「Bが良い確率」でも「差の大きさ」でもない。p値が大きくても「差がない」証明にはならない。
- 差の大きさは、差そのものと信頼区間で見る。
- 途中でのぞいて止めない、比べすぎない、振り分けのずれを確かめる。期間・指標・判断基準は始める前に決める。
確認テスト
A/BテストでAとBを「同じ期間に」「無作為に分けた人に」見せる理由として、最も適切なものはどれでしょう?
- ツールの料金が安くなるから
- 結果が早く出るから
- 季節や訪問者の種類などの条件を両方でそろえ、差を案の違いによるものと考えやすくするため
答えと解説
正解は3です。時期をずらしたり、見せる相手を選んだりすると、案以外の違いが混ざってしまいます。無作為に同じ期間に振り分けることで、比べる条件がそろいます。
A/Bテストでp値が0.03でした。正しい解釈はどれでしょう?
- 差がないと仮定すると、これほど極端な差が偶然出るのは約3%なので、偶然だけでは説明しにくい
- 案Bのほうが優れている確率は97%である
- 案Bは案Aより3%売上が多い
答えと解説
正解は1です。p値は「差がない」という仮定のもとでの起こりにくさです。Bが優れている確率や、差の大きさを表すものではありません。
テスト中に毎日結果を確かめ、p値が0.05を下回った日にテストを止めるやり方の問題点はどれでしょう?
- テストにかかる費用が増える
- 確かめるたびに偶然の「有意」を拾うチャンスが増え、本当は差がないのに有意と判定してしまう割合が大きくなる
- p値が正しく計算できなくなる
答えと解説
正解は2です。この回のシミュレーションでは、差のないA/Aテストでも、毎日のぞいて止めるルールでは約27%で「有意差あり」になりました。期間や人数は始める前に決めておきます。
データが非常に多いA/Bテストで、購入率の差が0.02ポイントで「有意差あり」となりました。最も適切な判断はどれでしょう?
- 有意差があるので、すぐに採用する
- 有意差があるので、大きな効果が期待できる
- 偶然ではなさそうだが差はとても小さいので、改修の費用や手間と比べて採用するかを判断する
答えと解説
正解は3です。データが多いと、ごく小さな差でも有意になります。「有意」は偶然とは考えにくいという意味で、ビジネス上の価値は差の大きさと費用で判断します。
次回予告
次回は、「何人のデータがあれば信じられるのか」を扱います。アンケートの誤差の幅の読み方と、A/Bテストを始める前に必要な人数を見積もる考え方を学びます。
参考資料
- American Statistical Association「ASA Statement on Statistical Significance and P-Values」(Wasserstein, R. L. & Lazar, N. A., The American Statistician, 2016)の内容を紹介した ScienceDaily の記事「Statistical significance and p-values」(2016年3月7日、確認日:2026年11月12日)https://www.sciencedaily.com/releases/2016/03/160307092305.htm
- Google アナリティクス ヘルプ「[Sunset September 2023] Google Optimize」(確認日:2026年11月12日)https://support.google.com/optimize/answer/6211951?hl=en
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較