
回帰分析の考え方:数字を動かす要因を探る|マーケターのためのデータ分析・統計入門 第8回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かること:①回帰分析で引く「回帰直線」の意味と、傾き・切片・残差の読み方、②複数の要因を同時に扱う「重回帰分析」で、要因の影響を切り分ける考え方、③係数と決定係数の読み方と、回帰分析を使うときの注意点。前回は顧客を分けて見る方法を学びました。今回は、売上や問い合わせ数が「何によって、どれくらい動くのか」を数字で表す回帰分析を扱います。
回帰分析とは:点の集まりに「いちばん合う線」を引く
第4回で、2つの数字の関係を散布図と相関係数で見る方法を学びました。相関係数は「どれくらい一緒に動くか」を教えてくれますが、「広告費を10万円増やすと、売上はいくら増えそうか」という問いには答えてくれません。この問いに答えるための道具が回帰分析です。
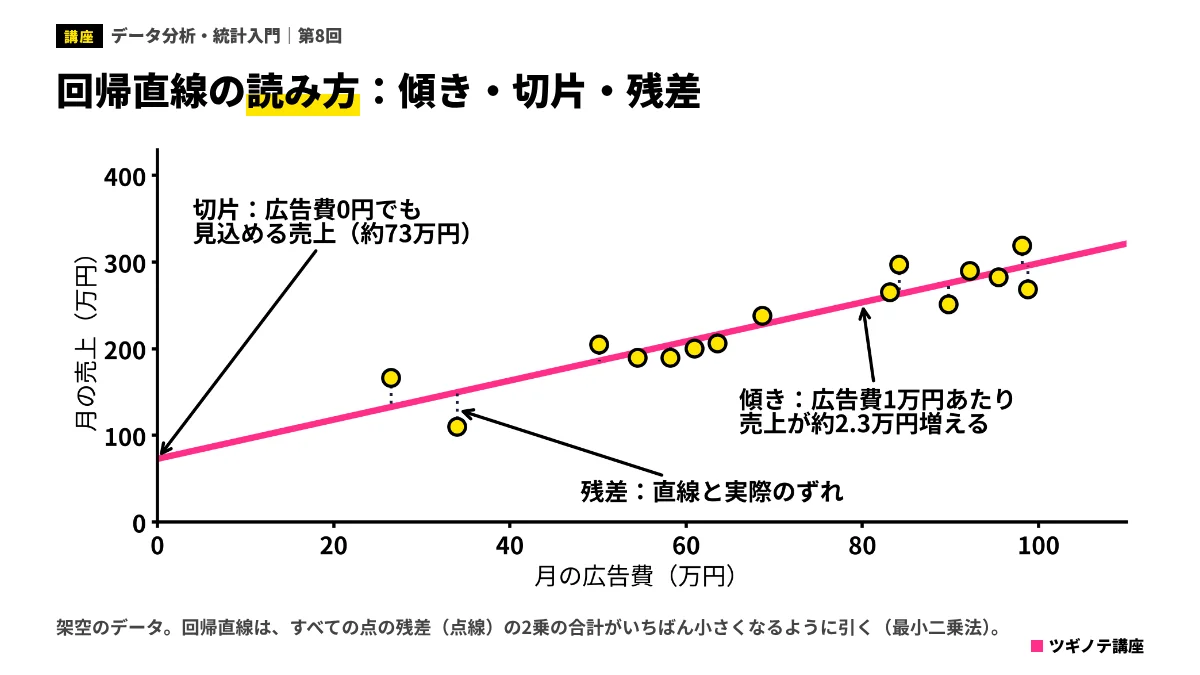
回帰分析は、散布図の点の集まりに「いちばん合う直線」を引き、その直線で一方の数字(結果)をもう一方の数字(要因)から説明する方法です。結果の側を「目的変数」、要因の側を「説明変数」と呼びます。図1の例では、売上が目的変数、広告費が説明変数です。
「いちばん合う」の決め方として広く使われているのが「最小二乗法」です。それぞれの点と直線の縦のずれ(残差)を2乗して合計し、その合計がいちばん小さくなるように直線を引きます。米国国立標準技術研究所(NIST)の統計ハンドブックでも、最も広く使われているモデルの作り方として紹介されています。
傾き・切片・残差
回帰直線は「売上 = 切片 + 傾き × 広告費」という形で表せます。図1の例では、おおよそ次のようになります。
売上(万円)≒ 73 + 2.3 × 広告費(万円)
- 傾き(係数):説明変数が1増えたとき、目的変数がどれだけ増えるか。この例では「広告費が1万円増えると、売上が約2.3万円増える傾向がある」と読みます。
- 切片:説明変数が0のときの目的変数の値。この例では「広告費0円でも約73万円の売上がある」ことになりますが、データに広告費0円の月が含まれていない場合、この値は「直線を延ばした先の計算上の値」にすぎない点に注意が必要です。
- 残差:実際の値と、直線から計算した値のずれ。残差が大きい月には、広告費以外の理由(セール、在庫切れ、天候など)が隠れているかもしれません。残差の大きい点を1つずつ調べるのも、立派な分析の一歩です。
「問い合わせ数 = 5 + 0.8 × ウェビナー参加者数」という回帰直線が得られました。傾き0.8の読み方として正しいものはどれでしょう?
- ウェビナー参加者の80%が問い合わせをする
- ウェビナー参加者が1人増えると、問い合わせ数が約0.8件増える傾向がある
- 問い合わせ数の80%はウェビナーから生まれている
答えと解説
正解は2です。傾きは「説明変数が1増えたときの目的変数の増え方」を表します。参加者のうち何割が問い合わせたか、といった割合を直接表すものではありません。
要因を1つだけにすると、判断を誤ることがある
では、架空のA社の実際の24か月分のデータで、広告費と売上の関係を調べてみましょう。
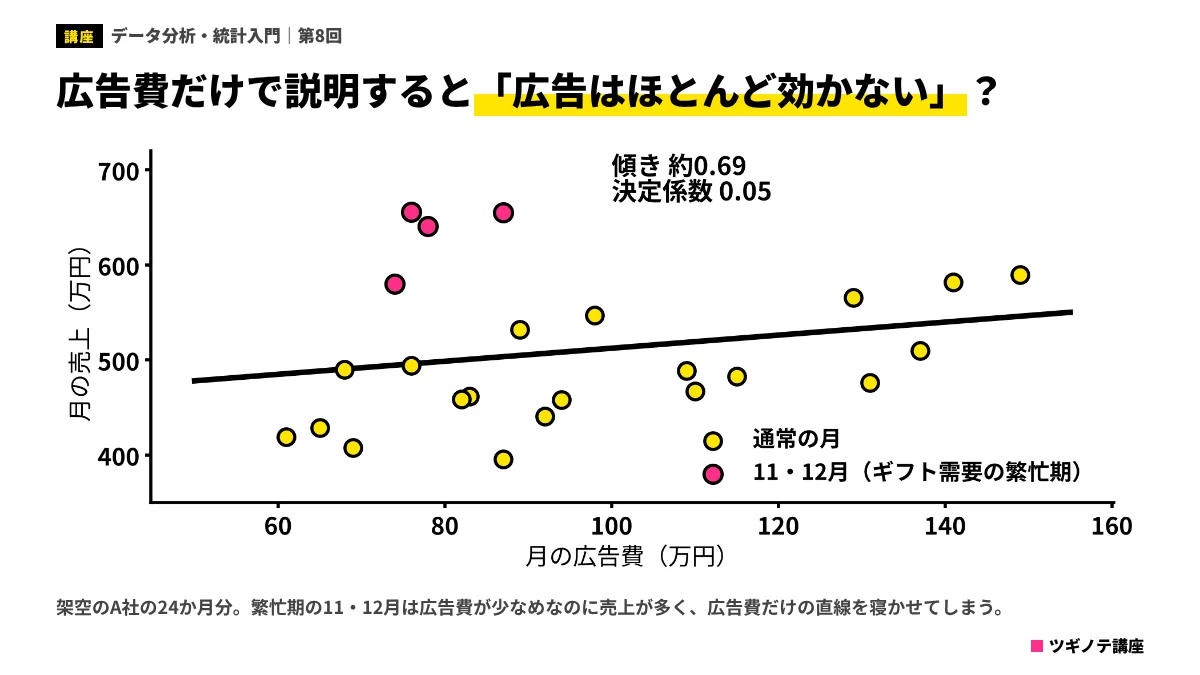
広告費だけで直線を引くと、傾きは約0.69でした。「広告費を1万円増やしても売上は0.69万円しか増えない。広告は赤字だ」という結論になりそうです。しかも、後で説明する決定係数は0.05で、売上の上下のほとんどを説明できていません。
ここで散布図をよく見ると、ピンクの点、つまり11月と12月の売上が、広告費が少なめなのに飛び抜けて高いことに気づきます。A社のコーヒー豆は年末のギフト需要で売上が伸びる一方、この時期は「広告を出さなくても売れる」と考えて広告費を控えめにしていたのです。その結果、「広告費が少ないのに売上が多い月」がいくつもでき、直線が寝かされていました。
これは、第4回で学んだ「第三の要因(交絡)」の問題そのものです。季節という要因が、広告費と売上の両方に関わっているため、広告費だけを見ると、広告の効き方を正しくつかめないのです。
重回帰分析:要因を一緒に入れて、影響を切り分ける
そこで、「繁忙期かどうか」という要因を一緒に入れて分析してみます。このように、説明変数を2つ以上使う回帰分析を「重回帰分析」と呼びます。
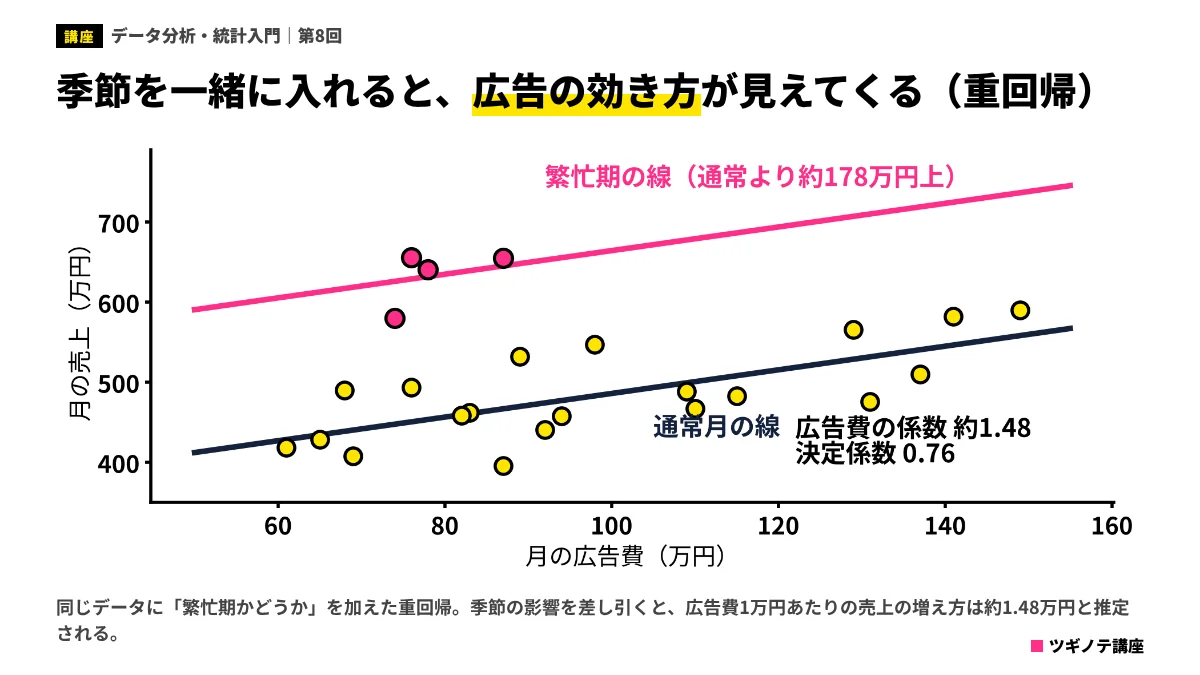
売上(万円)≒ 339 + 1.48 × 広告費(万円)+ 178 ×(繁忙期なら1、そうでなければ0)
「繁忙期なら1、そうでなければ0」のように、ある/なしを0と1で表した変数を「ダミー変数」と呼びます。結果を読むと、次のことが分かります。
- 広告費の係数(1.48):繁忙期かどうかが同じなら、広告費1万円あたり売上が約1.48万円増える傾向がある
- 繁忙期の係数(178):広告費が同じなら、繁忙期は通常の月より売上が約178万円多い
広告費だけで見たときの0.69から、季節の影響を差し引くと1.48に変わりました。図3の2本の平行な直線は、「通常月の線」と「繁忙期の線」で、同じ傾き(広告の効き方)を持ちながら、高さ(季節の上乗せ)だけが違うことを表しています。重回帰分析の係数は、「ほかの要因が同じだったら」という条件つきの影響を表すのが特徴です。
ただし、この係数も「広告費を増やせば必ず売上がこれだけ増える」という因果の証明ではありません。モデルに入れていないほかの要因(競合のセール、商品の入れ替えなど)が混ざっている可能性は残ります。重回帰分析は「考えられる交絡をできるだけ取り除いた推定」と理解し、可能なら第4回・第5回で学んだように、広告を出す地域や期間を無作為に分けて確かめるのが理想です。
もう一歩深く:係数にも「誤差の幅」がある
回帰分析の係数も、手元のデータから計算した推定値なので、第5回・第6回で学んだ偶然のぶれを含みます。統計ソフトや表計算ソフトで回帰分析をすると、係数ごとに「標準誤差」「t値」「p値」「95%信頼区間」が一緒に出てきます。たとえばA社の例では、広告費の係数の95%信頼区間はおよそ「0.78〜2.17」でした。これは「広告費1万円あたりの売上の増え方は、データから考えておおよそ0.8〜2.2万円の幅にありそうだ」と読みます。区間が0をまたいでいる要因は、「影響があるとは言い切れない」と慎重に扱いましょう。24か月分のような少ないデータでは、この幅がかなり広くなることも珍しくありません。
重回帰分析で「広告費の係数が1.48」と出たときの読み方として、最も適切なものはどれでしょう?
- 広告費を1万円増やせば、どんな場合でも必ず売上が1.48万円増える
- 売上の148%は広告から生まれている
- モデルに入れたほかの要因(繁忙期かどうか)が同じなら、広告費1万円あたり売上が約1.48万円増える傾向がある
答えと解説
正解は3です。重回帰分析の係数は「ほかの要因が同じなら」という条件つきの関係を表します。モデルに入れていない要因の影響は残るので、因果の証明ではない点にも注意しましょう。
決定係数:どれくらい説明できたか
回帰分析の結果でよく見る数字に「決定係数(R²)」があります。決定係数は、目的変数の上下(ばらつき)のうち、モデルでどれくらいを説明できたかを0〜1(0〜100%)で表した数字です。
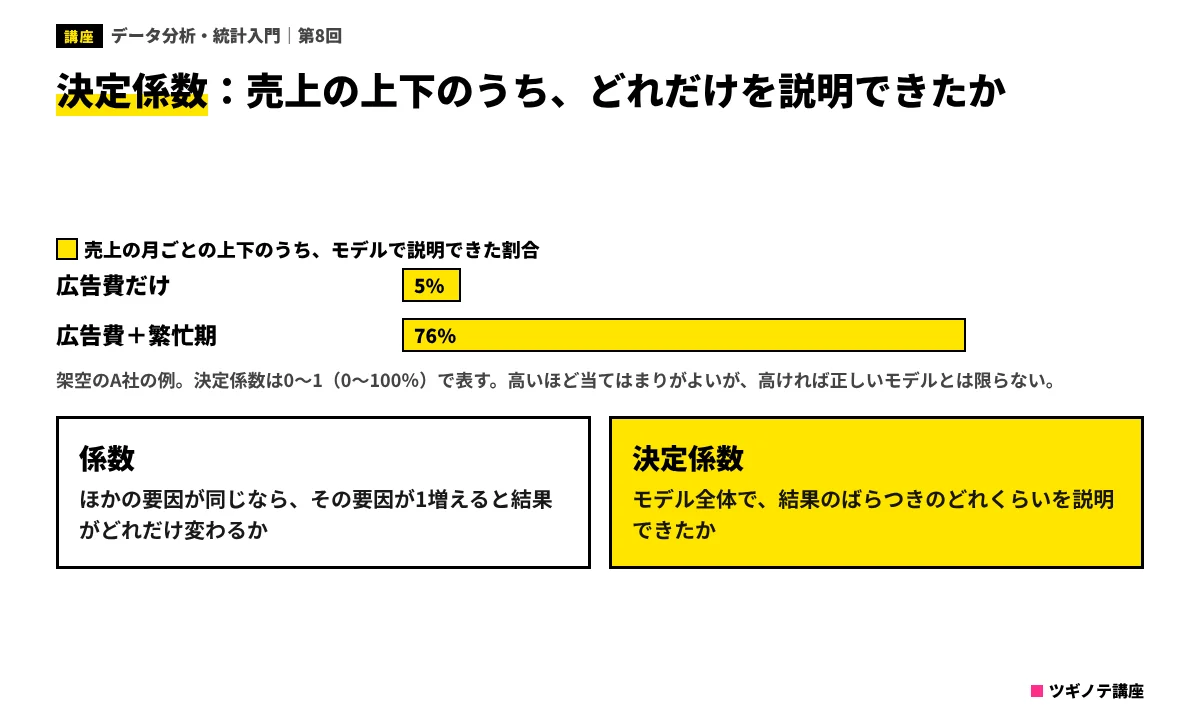
A社の例では、広告費だけのモデルの決定係数は約0.05(5%)、繁忙期を加えたモデルは約0.76(76%)でした。売上の月ごとの上下の4分の3ほどを、広告費と季節で説明できたことになります。
よくある誤解:「決定係数が高ければ、良いモデル」
決定係数は高いほど「手元のデータへの当てはまりが良い」ことを示しますが、それだけで良いモデルとは言えません。
- 要因を増やすと、決定係数は上がりやすい:意味のない要因を入れても、決定係数はほとんど下がらず、たいてい少し上がります。要因を入れすぎたモデルは、手元のデータにはよく合っても、新しいデータ(来月の売上)の予測は外れやすくなります。これを「過学習」と呼びます。要因の数を考慮した「自由度調整済み決定係数」を見るのも1つの方法です。
- 決定係数が低くても役に立つことはある:人の行動のように偶然の要素が大きいものは、決定係数がそれほど高くならないのがふつうです。それでも「この要因は結果を確かに動かしている」と分かれば、判断の材料になります。
回帰分析を使うときの注意
最後に、回帰分析を実務で使うときの注意点をまとめます。NISTの統計ハンドブックでも、直線のモデルは範囲の外への予測(外挿)が苦手なこと、1〜2個の外れ値で結果が大きくゆがみうることが、弱点として挙げられています。
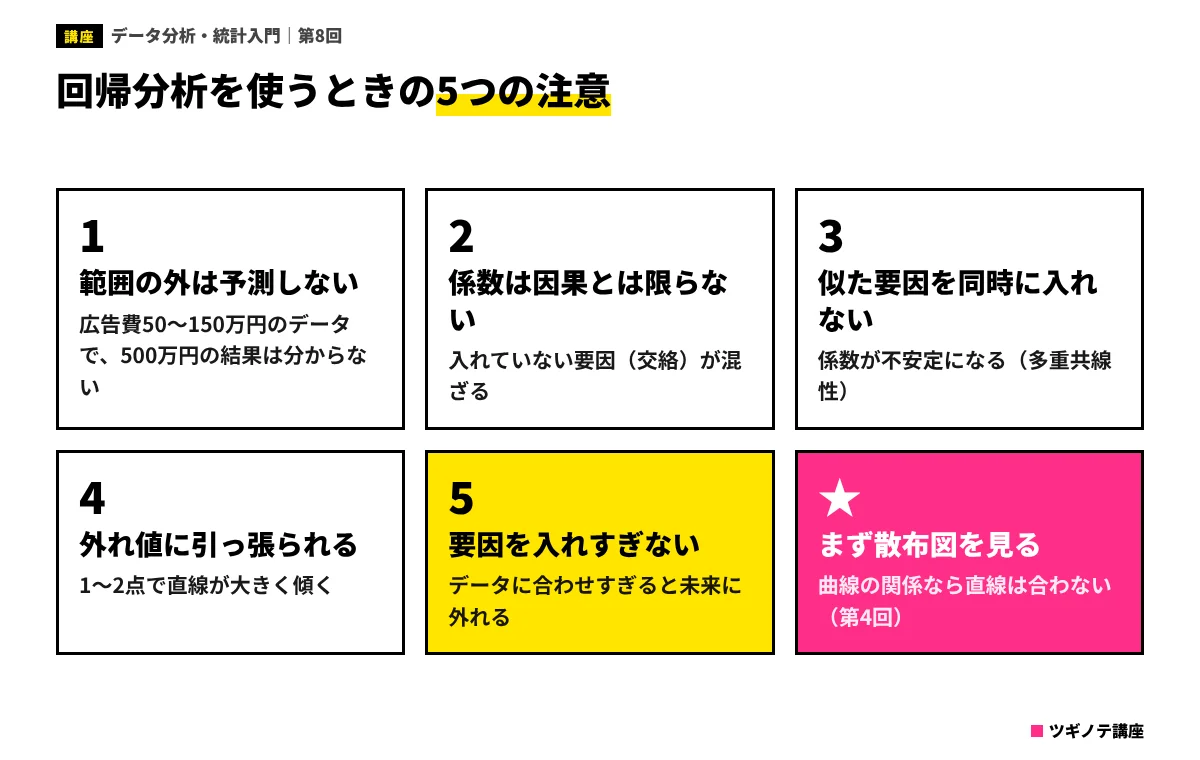
- データの範囲の外は予測しない:広告費50〜150万円のデータから作ったモデルで、「広告費を500万円にすれば売上は…」と計算するのは危険です。広告にはどこかで効き目が頭打ちになる点があるのがふつうで、直線はそれを表せません。
- 係数は因果とは限らない:モデルに入れていない交絡があれば、係数はゆがみます。
- よく似た要因を同時に入れない:「広告費」と「広告のクリック数」のように、ほとんど同じ動きをする要因を同時に入れると、それぞれの係数が不安定になり、符号が逆になることさえあります(多重共線性と呼ばれます)。
- 外れ値に注意する:大型キャンペーンの月など、ほかと大きく違う月が1つあるだけで、直線が大きく傾くことがあります。残差の大きい点を確かめましょう。
- 要因を入れすぎない:データの件数に比べて要因が多すぎると、過学習を起こします。24か月分のデータに10個の要因を入れるような分析は避けましょう。
そして何より、回帰分析を始める前に散布図を見ることです。第4回のアンスコムの例のように、関係が曲線だったり、外れ値1点で関係が作られていたりすれば、直線のモデルは合いません。
広告費50〜150万円の月のデータで「売上 = 339 + 1.48 × 広告費」というモデルを作りました。このモデルの使い方として、最も慎重さが必要なものはどれでしょう?
- 広告費を500万円にしたときの売上を、このモデルで予測する
- 広告費100万円の月と120万円の月の売上の違いを見積もる
- 残差が大きい月を取り出して、理由を調べる
答えと解説
正解は1です。データの範囲(50〜150万円)の外の予測は外挿と呼ばれ、直線のモデルが苦手とするところです。広告には効き目が頭打ちになる点があるのがふつうなので、500万円での売上はこのモデルからは分かりません。
実務ではこう使う:「何が効いているか」の会議を数字で進める
回帰分析は、「広告とセールとメールの、どれが売上に効いているのか」といった、要因の切り分けの議論で役に立ちます。進め方の例は次のとおりです。
| 手順 | やること | ポイント |
|---|---|---|
| 1 | 目的変数と、候補になる要因を書き出す | 第1回の仮説ツリーを使う。要因はデータの件数に比べて少なめに |
| 2 | 要因ごとに散布図を描く | 曲線の関係や外れ値がないかを確かめる |
| 3 | 季節など、明らかな交絡を一緒に入れて重回帰分析をする | ダミー変数を使う |
| 4 | 係数・決定係数・残差を確かめる | 係数の符号が常識と逆なら、似た要因や交絡を疑う |
| 5 | 結論を「傾向」として伝え、可能なら実験で確かめる | 広告を止める地域・期間を無作為に決めて試すなど |
回帰分析は、表計算ソフトでも実行できます(次回扱います)。広告の効果をより本格的に測るには、媒体ごとの効果を推定する分析手法や、専門の分析会社の力を借りる方法もあります。広告の計測の基本はWeb広告運用の基本 第7回で、分析の外部委託についてはデータ分析会社おすすめ比較で紹介しています。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 回帰分析は、点の集まりにいちばん合う直線を引き、結果を要因で説明する方法。傾き(係数)・切片・残差を読む。
- 要因を1つだけにすると、交絡によって影響を見誤ることがある。
- 重回帰分析は、複数の要因を同時に入れて、「ほかの要因が同じなら」という条件つきの影響を推定する。
- 決定係数はモデル全体の説明力。高ければ良いモデルとは限らず、要因の入れすぎは過学習を招く。
- 範囲の外は予測しない、似た要因を同時に入れない、外れ値に注意する。何より先に散布図を見る。
確認テスト
回帰分析の「残差」の説明として、正しいものはどれでしょう?
- 実際の値と、回帰直線から計算した値とのずれ
- 回帰直線の傾き
- 説明変数が0のときの目的変数の値
答えと解説
正解は1です。残差が大きい点には、モデルに入っていない理由が隠れていることがあります。2は傾き(係数)、3は切片の説明です。
広告費だけで回帰分析をしたときの係数が0.69、繁忙期のダミー変数を加えると1.48に変わりました。この変化の主な理由として最も適切なものはどれでしょう?
- 計算方法が間違っていたから
- データの件数が増えたから
- 繁忙期という交絡が、広告費だけのモデルでは広告の効き方を小さく見せていたから
答えと解説
正解は3です。繁忙期は広告費が少なめなのに売上が多かったため、広告費だけのモデルでは直線が寝かされていました。季節の影響を一緒に入れることで、広告の効き方を切り分けられます。
決定係数についての説明として、正しいものはどれでしょう?
- 決定係数が高ければ、そのモデルの係数は因果関係を表している
- 意味のない要因を加えても決定係数は上がりやすいので、高いだけで良いモデルとは言えない
- 決定係数が低いモデルは、まったく役に立たない
答えと解説
正解は2です。要因を増やすと決定係数は上がりやすく、手元のデータに合わせすぎた「過学習」のモデルになることがあります。決定係数が低くても、要因の影響を知る材料になることもあります。
「広告費」と「広告のクリック数」を同時に説明変数に入れたところ、広告費の係数がマイナスになりました。考えられる理由として最も適切なものはどれでしょう?
- 広告を出すと売上が減るから
- 決定係数が低すぎるから
- ほとんど同じ動きをする要因を同時に入れたため、係数が不安定になった(多重共線性)
答えと解説
正解は3です。よく似た要因を同時に入れると、どちらの影響かを切り分けられず、係数が不安定になったり符号が逆になったりします。どちらか一方に絞るなどの対処をします。
次回予告
次回は、ここまで学んだ分析を、ExcelやGoogle スプレッドシートで実際に手を動かして確かめます。代表値やばらつきを出す関数、ピボットテーブルでのセグメント分析、相関や回帰分析の出し方を、手順つきで紹介します。
参考資料
- NIST/SEMATECH e-Handbook of Statistical Methods「4.1.4.1. Linear Least Squares Regression」(確認日:2026年11月12日)https://itl.nist.gov/div898/handbook/pmd/section1/pmd141.htm
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較