
サンプルサイズと誤差:何人のデータがあれば信じられるか|マーケターのためのデータ分析・統計入門 第6回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かること:①一部のデータから全体を推し量るときに必ず生まれる「誤差」の正体と、その幅の読み方、②人数を増やすと減る誤差(ぶれ)と、増やしても減らない誤差(偏り)の違い、③アンケートやA/Bテストに必要な人数の見積もり方と、少ない数から出した割合の落とし穴。前回は、A/Bテストの差が偶然かどうかをp値で考えました。今回は、その「偶然のぶれ」がデータの量によってどう変わるかを学びます。
一部を調べて、全体を推し量る
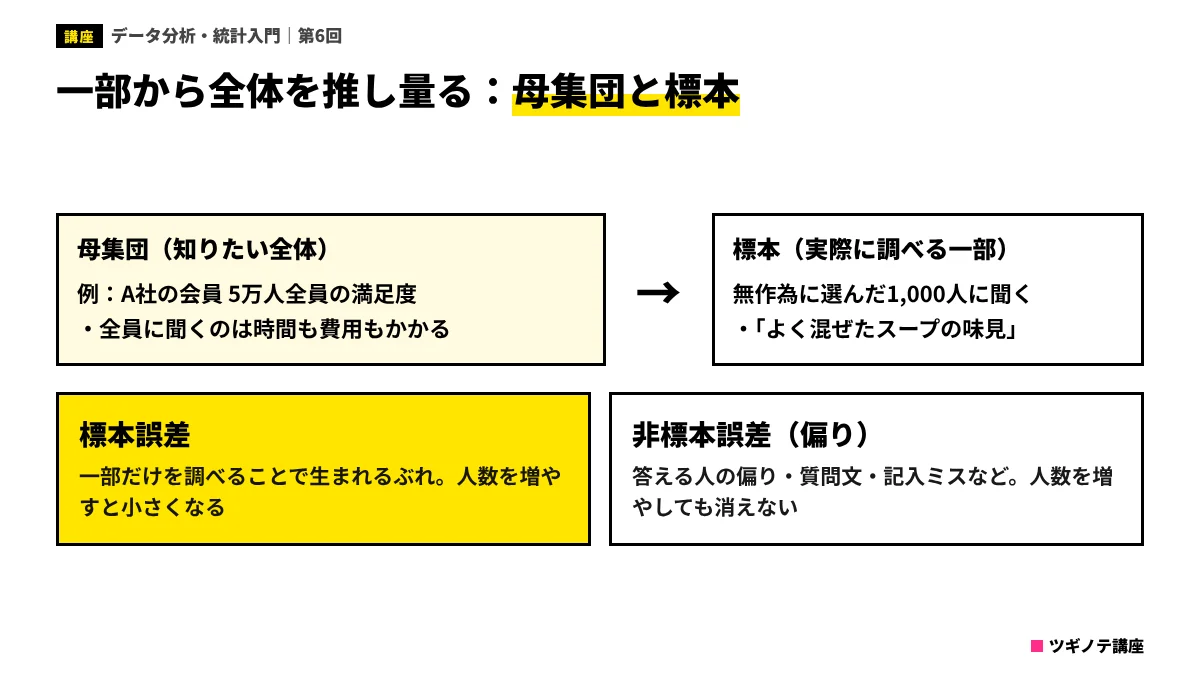
A社が会員5万人の満足度を知りたいとき、全員に聞くのは時間も費用もかかります。そこで、一部の会員を選んでアンケートをとり、その結果から全体の満足度を推し量ります。このとき、知りたい全体を「母集団」、実際に調べる一部を「標本(サンプル)」、標本の人数を「サンプルサイズ」と呼びます。
たとえるなら、標本調査は「スープの味見」です。大きな鍋のスープを全部飲まなくても、よくかき混ぜてからスプーン1杯を味見すれば、全体の味はだいたい分かります。ここで大事なのは「よくかき混ぜる」ことです。かき混ぜずに上澄みだけをすくえば、底に沈んだ具の味は分かりません。調査でいえば、「無作為に選ぶ」ことがかき混ぜることに当たります。
一部だけを調べる以上、標本から出した数字は、全体の本当の値とぴったり同じにはなりません。この「ずれ」が誤差です。総務省統計研究研修所のコラムでも、統計の誤差は大きく「標本誤差」と「非標本誤差」に分けられると説明されています。
| 種類 | 原因 | 人数を増やすと |
|---|---|---|
| 標本誤差(ぶれ) | 全体の一部だけを調べるために、たまたま選ばれた人によって結果がぶれる | 小さくなる |
| 非標本誤差(偏り) | 答える人の偏り、質問文の書き方、記入ミス、集計ミスなど | 小さくならない |
誤差の幅:「±何ポイント」を読む
アンケートの結果に「満足している:62%(誤差±3ポイント)」のように、誤差の幅が添えられていることがあります。これは、「無作為に選んだ標本から計算すると62%だったが、本当の値はおおよそ59〜65%のどこかにありそうだ」という意味です。前回の信頼区間と同じ考え方です。
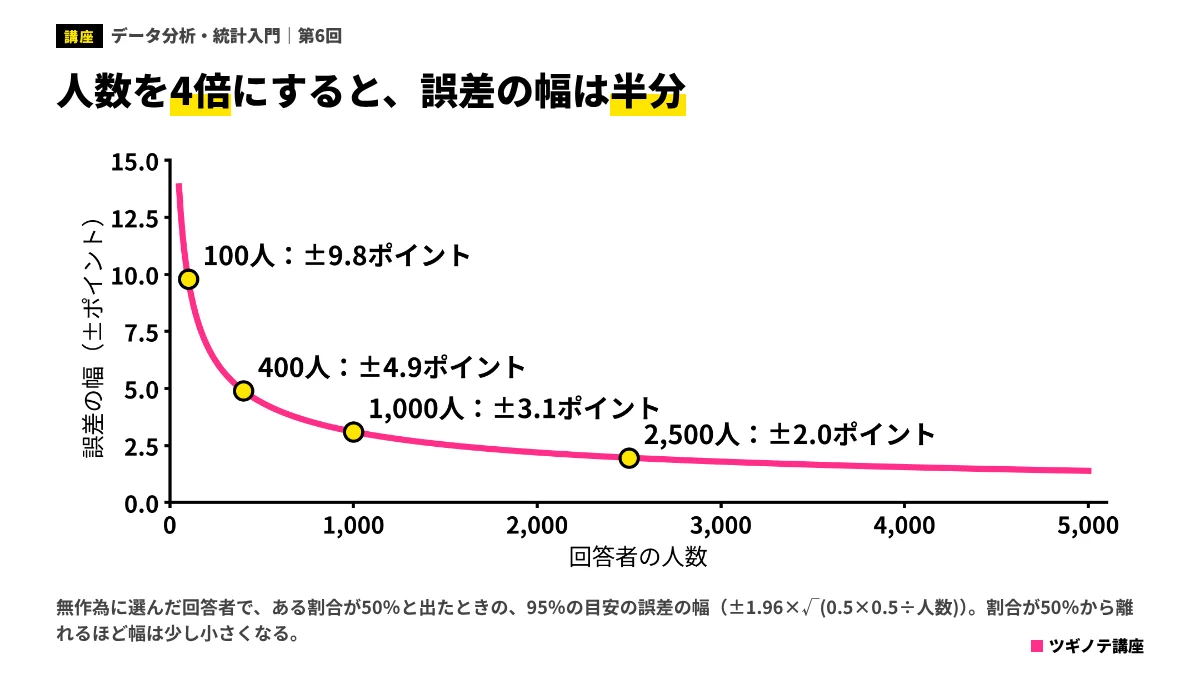
総務省統計局の労働力調査の解説では、標本の取り方をくり返したときの推定値のばらつきを「標準誤差」と呼び、推定値と本当の値の差が標準誤差の2倍に収まる確率はおよそ95%だと説明しています。アンケートなどで割合を推定するときの「95%の目安の誤差の幅」は、次の式でおおよそ計算できます。
誤差の幅 ≒ ±1.96 × √(割合 ×(1 − 割合)÷ 人数)
式を覚える必要はありません。大事なのは、次の図2に表れている性質です。
| 回答者の人数 | 誤差の幅(割合が50%のとき) | 誤差の幅(割合が10%のとき) |
|---|---|---|
| 100人 | ±9.8ポイント | ±5.9ポイント |
| 400人 | ±4.9ポイント | ±2.9ポイント |
| 1,000人 | ±3.1ポイント | ±1.9ポイント |
| 2,500人 | ±2.0ポイント | ±1.2ポイント |
| 10,000人 | ±1.0ポイント | ±0.6ポイント |
ここから分かることは2つです。
- 誤差の幅は人数の平方根に反比例する:人数を4倍にすると幅は半分、100倍にすると幅は10分の1になります。100人から400人に増やすと幅は大きく縮みますが、2,500人から1万人に増やしても1ポイントしか縮みません。人数を増やすほど、費用のわりに精度は上がりにくくなります。
- 母集団の大きさにはほとんど左右されない:意外かもしれませんが、母集団が5万人でも5,000万人でも、無作為に選んだ1,000人の誤差の幅はほぼ同じです(母集団に対して標本がかなり大きいときは、少し小さくなります)。スープの味見に必要なスプーンの大きさが、鍋の大きさにほとんど関係ないのと同じです。
無作為に選んだ400人のアンケートで、誤差の幅が±4.9ポイントでした。幅をおよそ±2.5ポイントまで小さくしたいとき、必要な人数の目安はどれでしょう?
- 約800人(2倍)
- 約1,600人(4倍)
- 約4,000人(10倍)
答えと解説
正解は2です。誤差の幅は人数の平方根に反比例するので、幅を半分にするには人数を4倍にする必要があります。
前月との「差」を読むときの注意
誤差の幅を知っていると、数字の上がり下がりの読み方が変わります。たとえば、400人のアンケートで満足度が先月52%、今月55%だったとします。誤差の幅はそれぞれ約±5ポイントあるので、3ポイントの上昇は偶然のぶれの範囲に十分収まります。「満足度が上がった」と報告する前に、誤差の幅と見比べる習慣をつけましょう。
人数を増やしても消えない「偏り」
誤差の幅の計算は、「無作為に選んだ」ことが前提です。この前提が崩れていると、人数をいくら増やしても正しい答えには近づきません。
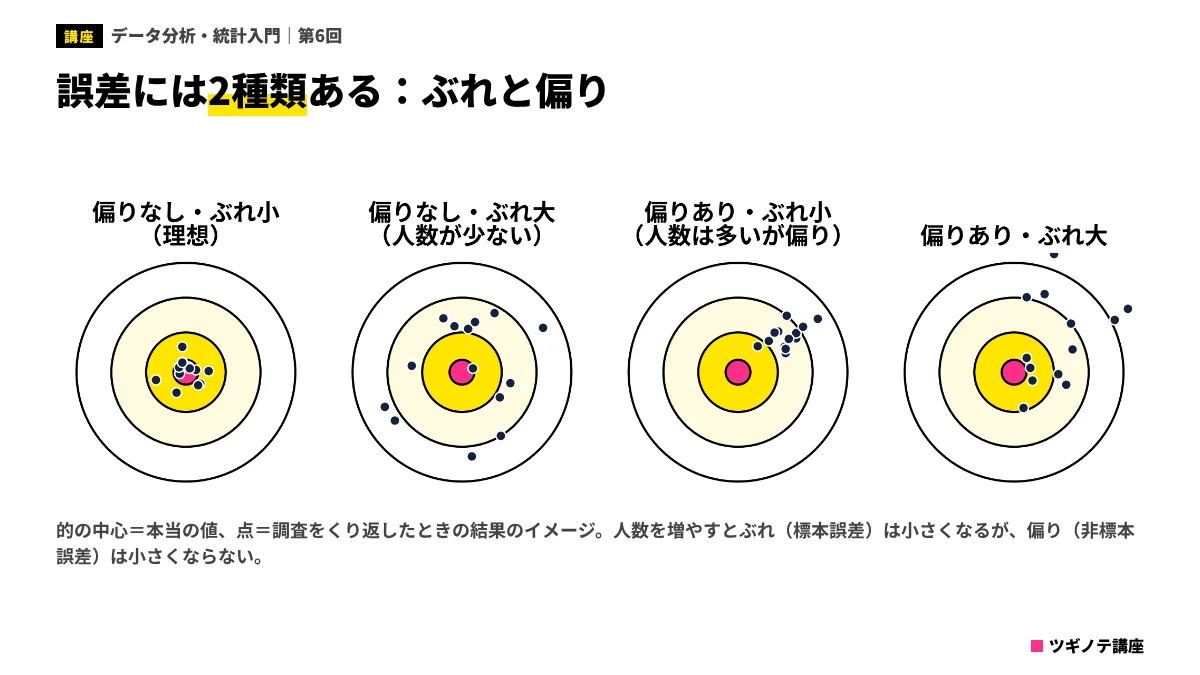
図3の3つ目の的のように、点がぎゅっと集まっていても、的の中心から外れていれば正しい答えではありません。マーケティングの調査では、次のような偏りが起こりがちです。
- 答える人の偏り:購入後のアンケートに答えるのは、特に満足した人か、特に不満がある人に偏りやすい。SNSでの投票は、そのアカウントのファンに偏る。
- 選び方の偏り:メールアドレスを登録している会員だけに聞くと、メールを見ない会員の声が抜け落ちる。
- 聞き方の偏り:「当社の新サービスはとても便利ですが、使ってみたいですか?」のような誘導的な質問は、回答を一方に寄せる。
- 答えない人の偏り:回答率が低いと、答えた人と答えなかった人の違いが結果をゆがめる。
よくある誤解:「1万人に聞いたから正確」
回答者の数が多いことは、ぶれが小さいことを保証しますが、偏りがないことは保証しません。偏った方法で集めた1万人の回答より、無作為に選んだ1,000人の回答のほうが、全体の姿を正しく表すことはよくあります。調査結果を見るときは、人数だけでなく「誰に、どうやって聞いたか」を必ず確かめましょう。
自社のSNSアカウントで「新商品を買いたいですか?」と投票を募ったところ、5,000票集まり、80%が「買いたい」でした。この結果の一番の問題点はどれでしょう?
- 回答者がもともと自社のファンに偏っている可能性が高く、人数が多くても市場全体の意向を表しているとは限らない
- 5,000票では少なすぎて、誤差の幅が大きすぎる
- 80%という割合は、誤差の計算ができない
答えと解説
正解は1です。5,000票なら標本誤差(ぶれ)は小さいですが、答えたのは自社のファンという偏った集団です。人数を増やしても、この偏りは消えません。
A/Bテストに必要な人数を見積もる
前回、A/Bテストでは期間や人数を「始める前に決める」ことが大切だと説明しました。では、何人いれば足りるのでしょうか。必要な人数は、主に次の3つで決まります。
- 今の数値(ベースライン):今の購入率が2%なのか20%なのか
- 見つけたい差の大きさ:2.0%を3.0%に上げる大きな改善を見つけたいのか、2.2%の小さな改善まで見つけたいのか
- 判断の厳しさ:有意水準(多くは5%)と、本当に差があるときにそれを見つけられる確率(検出力、多くは80%)
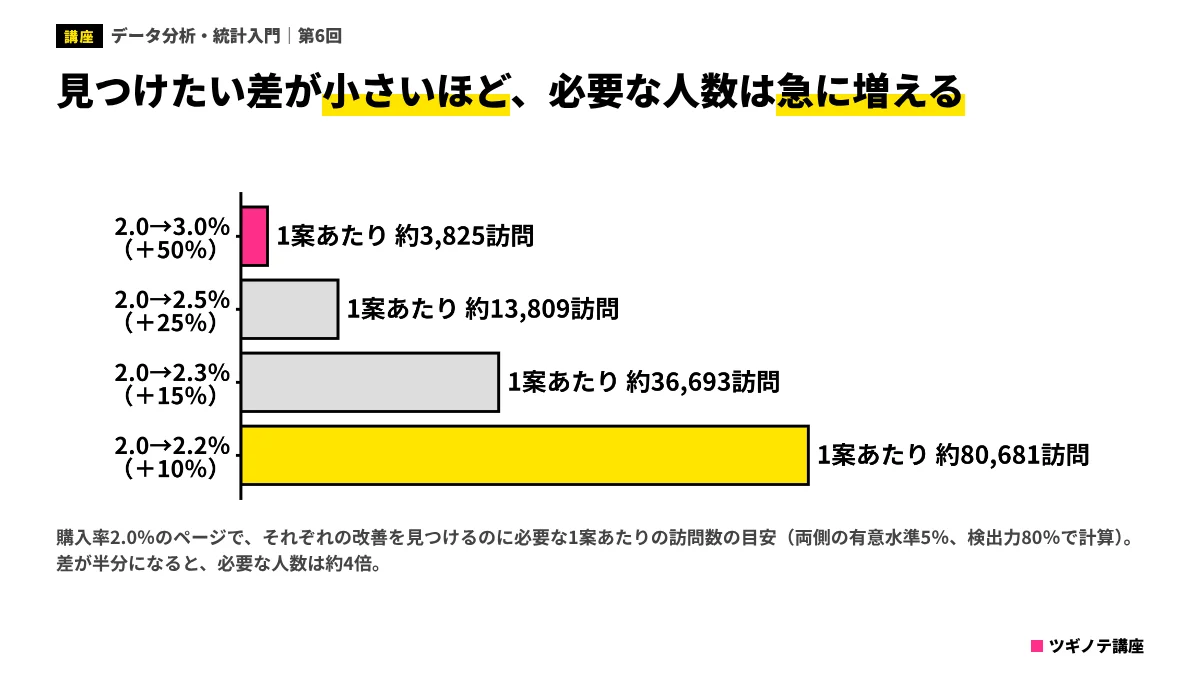
図4は、購入率2.0%のページで、両側の有意水準5%・検出力80%として計算した、1案あたりに必要な訪問数の目安です。2.0%を2.5%に上げる改善(相対的に25%の改善)を見つけるには1案あたり約1万4,000訪問、2.2%(10%の改善)なら約8万訪問が必要になります。見つけたい差が半分になると、必要な人数はおよそ4倍になります。
ここから、実務上の大事な判断が生まれます。
- 訪問数が少ないサイトでは、小さな改善はテストで確かめられない:月に1万訪問のサイトで2.0→2.2%の差を確かめようとすると、2案で16万訪問、つまり1年以上かかります。こうした場合は、見出しやオファーなど、大きな差が出そうな変更に絞ってテストするのが現実的です。
- 「検出力」が低いと、本当は効く改善を見逃す:人数が足りないままテストを終えると、本当は効果がある案でも「有意差なし」になりやすくなります。前回学んだとおり、「有意差なし」は「効果なし」ではありません。
必要な人数は、多くのA/Bテストツールや、統計ソフト・表計算ソフトで計算できます。テストの設計シートに「必要な人数」と「それが集まるまでの期間」を書いてから始めましょう。
もう一歩深く:検出力とは
検出力は、「本当に一定以上の差があるとき、テストでそれを有意と判定できる確率」です。検出力80%とは、本当に効く案のうち5回に1回は見逃してしまう、ということでもあります。見逃しを減らしたければ検出力を上げますが、そのぶん必要な人数は増えます。
母数が小さい割合は、極端に出やすい
最後に、日々のレポートでよく出会う落とし穴を紹介します。店舗別、担当者別、広告別、記事別など、たくさんのグループの「割合」を並べてランキングにするときです。
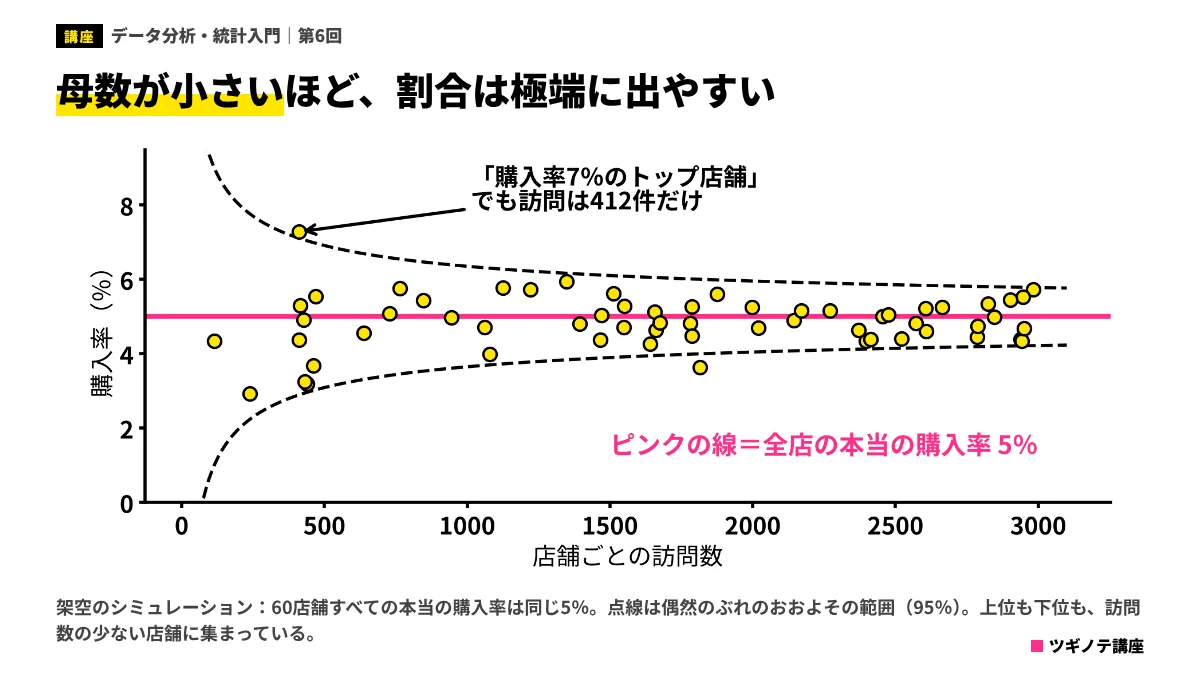
図5は、本当の購入率がすべて5%の60店舗を、コンピューターの中で作った例です。それでも、訪問数の少ない店舗では、偶然のぶれで7%になったり3%になったりします。購入率のランキングを作れば、上位にも下位にも訪問数の少ない店舗が並びやすくなります。「トップ店舗のやり方を全店に広げよう」と考える前に、その店舗の母数が十分か、点線(偶然のぶれの範囲)の外に出ているかを確かめましょう。
同じことは、「記事Aは5人中3人がクリック(60%)」「新しい広告は10件中4件が成約(40%)」のような、小さな母数の割合にも当てはまります。割合を報告するときは、必ず母数(何件中か)を添えましょう。
営業担当者別の成約率ランキングで、1位の担当者の成約率は80%でしたが、商談は5件だけでした。最も適切な受け止め方はどれでしょう?
- 1位なので、この担当者のやり方を全員に広げる
- 成約率80%は高すぎるので、データが間違っている
- 母数が5件と小さく偶然のぶれが大きいので、件数が増えるまで判断を保留し、ほかの担当者と比べる際も件数を添える
答えと解説
正解は3です。5件中4件の成約は、偶然でも十分に起こりえます。母数の小さい割合は極端に出やすいので、件数とあわせて判断しましょう。
実務ではこう使う:数字に「n」と「幅」を添える
この回の内容を実務に生かす一番簡単な方法は、割合や平均を報告するときに、必ず次の2つを添えることです。
| 添えるもの | 書き方の例 | 効果 |
|---|---|---|
| n(母数・人数) | 満足度62%(n=1,000) | 少ない母数の数字に飛びつかなくなる |
| 誤差の幅または信頼区間 | 満足度62%(±3ポイント) | 偶然のぶれの範囲内の上下に一喜一憂しなくなる |
そのうえで、調査を設計するときは「誰に、どうやって聞くか(偏りを防ぐ)」と「何人に聞くか(ぶれを抑える)」を両方決めます。アンケートの設計や分析を専門の会社に任せる場合は、データ分析会社おすすめ比較も参考にしてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 一部(標本)から全体(母集団)を推し量るとき、誤差は避けられない。誤差には「ぶれ(標本誤差)」と「偏り(非標本誤差)」がある。
- ぶれの幅は人数の平方根に反比例する。人数を4倍にすると幅は半分。母集団の大きさにはほとんど左右されない。
- 偏りは人数を増やしても消えない。「誰に、どうやって聞いたか」を確かめる。
- A/Bテストに必要な人数は、今の数値・見つけたい差・判断の厳しさで決まる。差が半分なら人数は約4倍。
- 母数の小さい割合は極端に出やすい。割合には必ずnと誤差の幅を添える。
確認テスト
無作為に選んだ回答者のアンケートで、誤差の幅について正しい説明はどれでしょう?
- 母集団が大きいほど、同じ人数でも誤差の幅は大きくなる
- 回答者の人数を4倍にすると、誤差の幅はおよそ半分になる
- 回答者の人数を2倍にすると、誤差の幅は半分になる
答えと解説
正解は2です。誤差の幅は人数の平方根に反比例するので、4倍で半分になります。母集団の大きさには、ほとんど左右されません。
人数を増やしても小さくならない誤差はどれでしょう?
- 無作為に選んだ一部だけを調べることによる、たまたまのぶれ
- 前月と今月で回答者が入れ替わることによる、たまたまのぶれ
- 満足した人ほど回答しやすいなど、答える人の偏りによるずれ
答えと解説
正解は3です。偏り(非標本誤差)は、同じ偏った方法で人数を増やしても消えません。調査の方法そのものを見直す必要があります。
購入率2.0%のページで、2.0%→2.2%という小さな改善をA/Bテストで確かめたいときの説明として、最も適切なものはどれでしょう?
- 大きな改善を確かめるときより、はるかに多くの訪問数が必要になる
- 改善が小さいので、少ない訪問数で十分に確かめられる
- 訪問数に関係なく、1週間テストすれば確かめられる
答えと解説
正解は1です。見つけたい差が小さいほど、偶然のぶれと区別するために多くのデータが必要です。この回の例では、2.0→2.5%なら1案あたり約1万4,000訪問、2.0→2.2%なら約8万訪問が目安でした。
60店舗の購入率ランキングで、上位と下位にどちらも訪問数の少ない店舗が多く並びました。考えられる理由として最も適切なものはどれでしょう?
- 訪問数の少ない店舗ほど、接客がとても上手か、とても下手だから
- 母数が小さいほど偶然のぶれが大きく、割合が極端な値になりやすいから
- 訪問数の少ない店舗はデータの集計を間違えているから
答えと解説
正解は2です。本当の購入率が同じでも、母数が小さい店舗では偶然のぶれで極端な値が出やすくなります。ランキングを見るときは母数を添えて判断しましょう。
次回予告
次回は、顧客を「分けて見る」分析を学びます。平均の中に隠れた違いを見つけるセグメント分析、購入の新しさ・回数・金額で顧客を分けるRFM分析、始めた時期ごとに顧客の定着を追うコホート分析を、架空のA社のデータで試していきます。
参考資料
- 総務省統計研究研修所 奥積雅彦「統計図書館コラム【雑学編】No.1013 統計を生かすための留意点」(確認日:2026年11月12日)https://www.stat.go.jp/library/pdf/column1013.pdf
- 総務省統計局「労働力調査 標本設計の解説」(平成30年4月、確認日:2026年11月12日)https://www.stat.go.jp/data/roudou/hyohon/pdf/18hyohon.pdf
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較