
プロンプトとは何か:生成AIは「何を見て」答えているのか|プロンプト設計の教科書 第1回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かることは3つです。①生成AIは、指示の一文だけでなく「文脈」と呼ばれる情報のかたまり全体を見て答えを組み立てていること、②その文脈が、サービスの設定・会話の履歴・貼り付けた資料などの層でできていること、③同じ頼み方でも答えがぶれる理由と、プロンプト設計を「文脈を設計する仕事」ととらえる考え方です。全8回の土台になる回です。
生成AIは「続き」を予測して答えをつくる
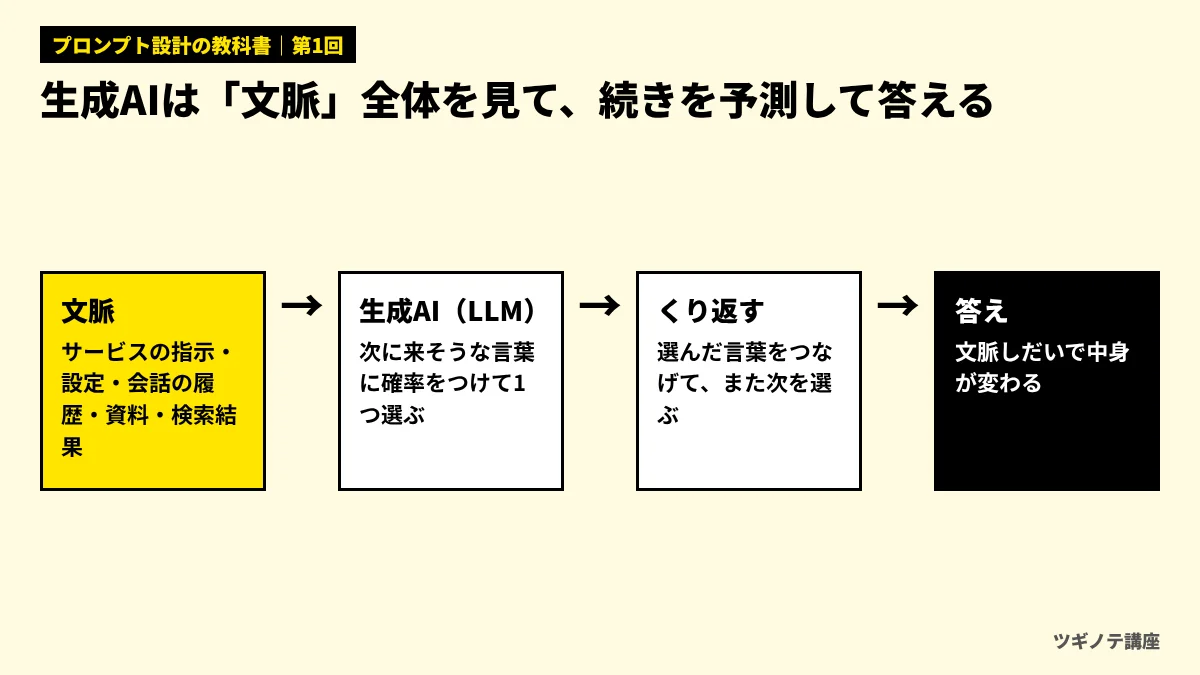
ChatGPTやGemini、Claude、Microsoft 365 Copilotなど、文章を生み出す生成AIの中心には、大規模言語モデル(LLM)と呼ばれる仕組みがあります。LLMがしていることを一言でいうと、「ここまでの文章の続きとして、もっともらしい言葉を1つずつ選んでいく」ことです。
もう少し正確にいうと、LLMは文章を「トークン」と呼ばれる小さな単位(日本語なら1〜数文字程度のかたまり)に分けて扱います。そして、それまでに並んだトークン全体を見たうえで、次に来そうなトークンの候補に確率をつけ、そこから1つを選びます。選んだトークンを後ろにつなげ、また次を選ぶ。これを繰り返して、一続きの答えができあがります。仕組みの詳しい説明は、姉妹講座のトークンと埋め込みの回と、Transformerと注意機構の回で扱っています。
ここで大事なのは、「次の言葉」を選ぶときに見ているのが、あなたが最後に打った一文だけではない、という点です。LLMは、そのとき手元にある文章のかたまり全体を手がかりにします。このかたまりを「文脈(コンテキスト)」と呼びます。
たとえ話をしましょう。生成AIは、とても物知りで文章もうまいけれど、今日あなたの会社に来たばかりの応援スタッフのようなものです。一般的な知識は豊富でも、あなたの会社の事情、相手の顔、前回の打ち合わせの中身は、机の上に置かれた資料と、あなたが話した内容からしか知ることができません。机の上に置かれたものが、そのまま答えの材料になります。プロンプトを書くとは、この「机の上」を整えることなのです。
もう一歩深く:「知っていること」と「文脈から読み取ること」
LLMは、大量の文章で事前に学習しています。そのため、一般常識や言葉の使い方、よく知られた事実は、文脈がなくてもある程度答えられます。一方で、学習した時点より新しい出来事、社内の情報、あなたの好みや判断基準は、文脈で渡さない限り分かりません。分からないとき、LLMは「分かりません」と止まるより、それらしい続きを組み立ててしまうことがあります。これが、もっともらしい間違い(ハルシネーション)が生まれる原因の1つです(第6回で詳しく扱います)。
生成AIが見ている「文脈」は5つの層でできている
チャット画面には、あなたの入力と生成AIの答えしか表示されません。しかし実際には、もっと多くの情報が文脈として生成AIに渡されています。サービスによって違いはありますが、おおむね次の5つの層に分けて考えると整理しやすくなります。
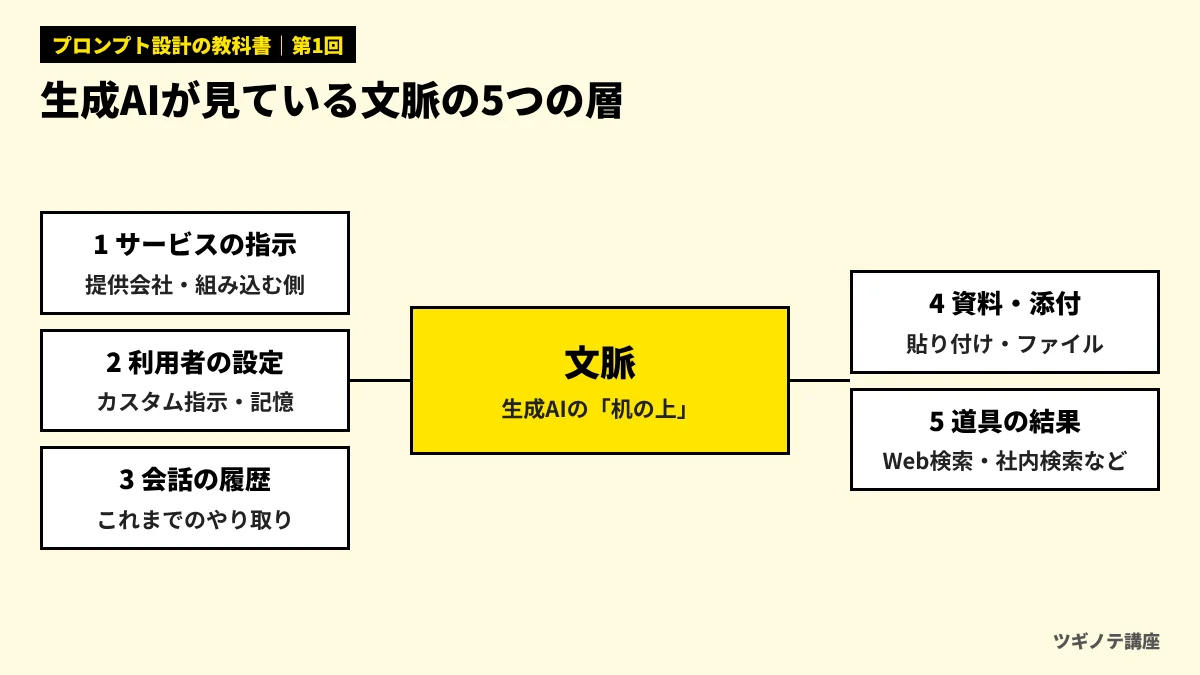
| 層 | 中身 | 誰が決めるか |
|---|---|---|
| 1. サービスの指示 | 生成AIの振る舞いの基本方針(安全のための決まり、答え方の方針など) | サービスを提供する会社。APIで自社システムに組み込む場合は、組み込む側も「システムの指示」を書ける |
| 2. 利用者の設定 | 「カスタム指示」や記憶(メモリ)機能などで登録した、自分の立場や好み | 利用者(機能の有無と名前はサービスによって違う) |
| 3. 会話の履歴 | 同じ会話の中での、これまでのやり取り | 利用者と生成AI |
| 4. 貼り付けた資料・添付 | 本文に貼った文章、アップロードしたファイル | 利用者 |
| 5. 道具を使った結果 | Web検索の結果、社内文書の検索結果、計算の結果など | 生成AIが自動で取りに行くことが多い |
ふだん「プロンプト」と呼んでいるのは、主に3と4の層、つまりあなたが入力する部分です。しかし答えは5つの層すべての影響を受けます。たとえば、同じ質問をしても、同僚と答えが違うことがあります。その理由は、同僚が「カスタム指示」に別の設定を入れていたり、同じ会話の中で前に別の話をしていたりと、見えない層が違うことかもしれません。
会話の履歴は「助け」にも「ノイズ」にもなる
同じ会話を続けると、前のやり取りが文脈に残るので、「さっきの案をもう少し短く」のような頼み方ができて便利です。一方で、まったく別の仕事を同じ会話の中で頼むと、前の話題に引っぱられた答えが出やすくなります。
また、文脈には入れられる量の上限があります(コンテキストウィンドウと呼ばれます)。上限はモデルやサービスによって大きく違い、会話がとても長くなると、古い部分が要約されたり、見えなくなったりする作りのサービスもあります。長い会話の終盤で、最初に伝えた条件が守られなくなったと感じたら、この上限や、情報が多すぎて大事な指示が埋もれていることを疑いましょう。
同じ会話の中で「新商品のプレスリリース」を作ったあと、続けて「社内向けの休暇ルールの案内文」を頼んだところ、案内文の口調が妙に宣伝っぽくなりました。もっとも考えられる原因はどれでしょう?
- 生成AIが休暇ルールについての知識を持っていないから
- 生成AIは毎回、ランダムに口調を決めているから
- 前のプレスリリースのやり取りが会話の履歴として文脈に残り、口調が引っぱられたから
答えと解説
正解は3。同じ会話の中では、前のやり取りも文脈として見られています。別の種類の仕事を頼むときは、新しい会話を始めるか、「ここからは別の仕事です。前の文章の口調は引き継がないでください」と区切りを伝えると、ぶれが減ります。
同じ頼み方でも答えがぶれる3つの理由
「昨日はうまくいったのに、今日は同じプロンプトで違う答えが出た」という経験は、多くの人にあるはずです。これは故障ではなく、仕組みから来る性質です。理由は大きく3つあります。
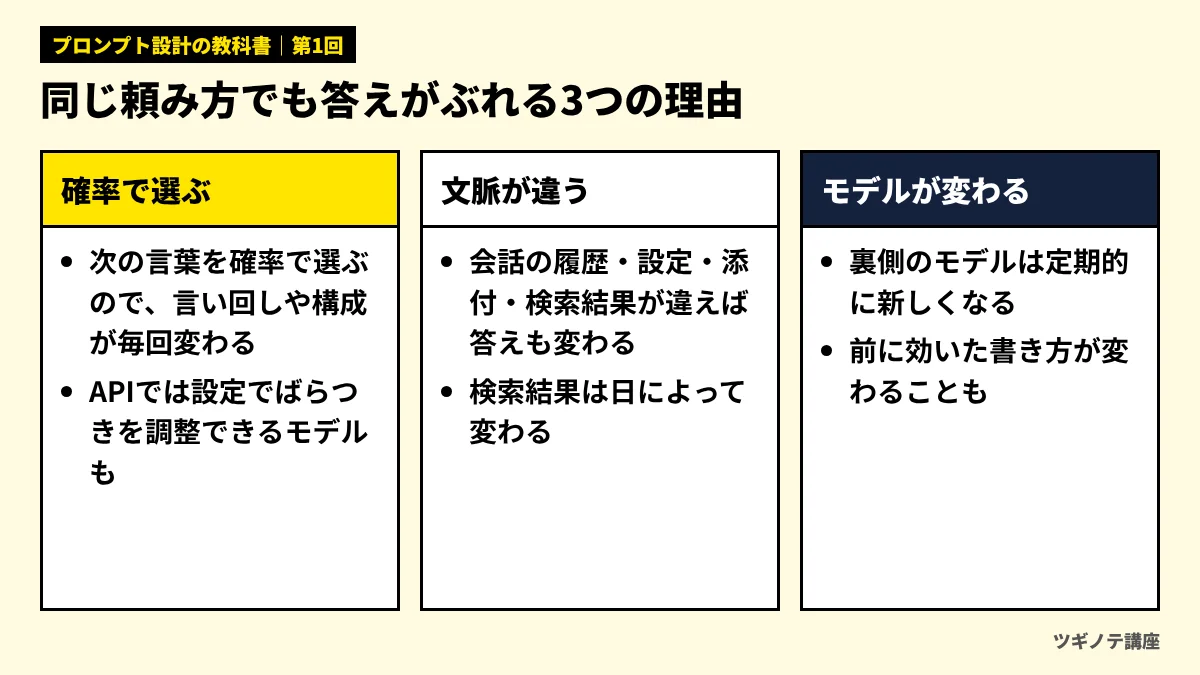
理由1:確率で言葉を選んでいるから。 先ほど説明したとおり、LLMは次の言葉の候補に確率をつけて選びます。いつも一番確率の高いものを選ぶとは限らないため、同じ文脈でも言い回しや構成が変わります。APIで使う場合は「temperature(温度)」などの設定で、ばらつきの大きさを調整できるモデルもあります。ただし、最近のモデルでは設定を既定のまま使うことが推奨される場合もあります。たとえばGoogleのGemini APIの公式ガイドでは、Gemini 3系のモデルについて、温度などの設定は既定値のままにするよう勧めています(2026年11月時点)。
理由2:文脈が少しずつ違うから。 会話の履歴、カスタム指示、添付した資料、検索で取ってきた情報が違えば、同じ一文でも答えは変わります。特にWeb検索を使う設定のときは、検索結果そのものが日によって変わります。
理由3:モデルそのものが変わるから。 生成AIのサービスは、裏側のモデルを定期的に新しくしています。性能が上がる一方で、以前のモデルでうまくいったプロンプトの効き方が変わることもあります。各社の公式ガイドでも、モデルの世代によって勧める書き方が変わる場合があると説明されています。
ぶれをゼロにすることはできません。大切なのは、「ぶれても困らない頼み方」と「ぶれたことに気づける仕組み」を持つことです。前者は第2回〜第5回、後者は第6回と第8回で扱います。
よくある誤解
誤解1「どこかに魔法の言葉がある」
「この一文を入れると精度が上がる」といった言い回しが話題になることがあります。特定のモデルで効果があった言い回しも実際にありますが、モデルが変わると効かなくなることも多いのが実情です。たとえば「一歩ずつ考えて」という指示は、2022年の研究で、当時のモデルの計算問題の正答率を大きく上げたと報告されました。一方で、考える力が強い「推論モデル」では、こうした指示はほとんど不要だと各社のガイドで説明されています(第3回で詳しく扱います)。魔法の言葉を探すより、「何が足りないか」を考えるほうが長く通用します。
誤解2「長く書くほど良い答えになる」
必要な情報が足りないと答えは平均的になりますが、関係のない情報を大量に入れると、大事な指示が埋もれてしまいます。量ではなく「答えるのに必要なものがそろっているか」「余計なものが混ざっていないか」で考えましょう。
誤解3「生成AIは、自分のことを分かってくれている」
記憶機能があるサービスでも、何をどこまで覚えているかは設定や仕様次第です。また、あなたの頭の中にある前提(社内の略語、取引先との経緯、上司の好み)は、書かなければ伝わりません。「言わなくても分かるはず」は、人に頼むとき以上に通じないと考えておくのが安全です。
「プロンプト設計」の考え方として、この回の説明にもっとも合うものはどれでしょう?
- 精度が上がる決まり文句を集めて、毎回入れるようにする
- 生成AIが答えるのに必要な材料・条件・形が、文脈の中にそろっているかを整える
- できるだけ長い文章で、思いついたことをすべて書いて渡す
答えと解説
正解は2。生成AIは文脈全体から答えを組み立てるので、必要なものがそろい、余計なものが混ざっていない状態をつくることが基本です。決まり文句はモデルによって効き方が変わり、長さそのものは質を保証しません。
プロンプト設計とは「文脈を設計する」こと
ここまでの話をまとめると、プロンプト設計とは「生成AIの机の上に、何を、どの順番で、どんな区切りで置くか」を決める仕事だといえます。最近は、この考え方を指して「コンテキストエンジニアリング(文脈の設計)」という言葉が使われることも増えています。言葉は違っても、やることは同じです。
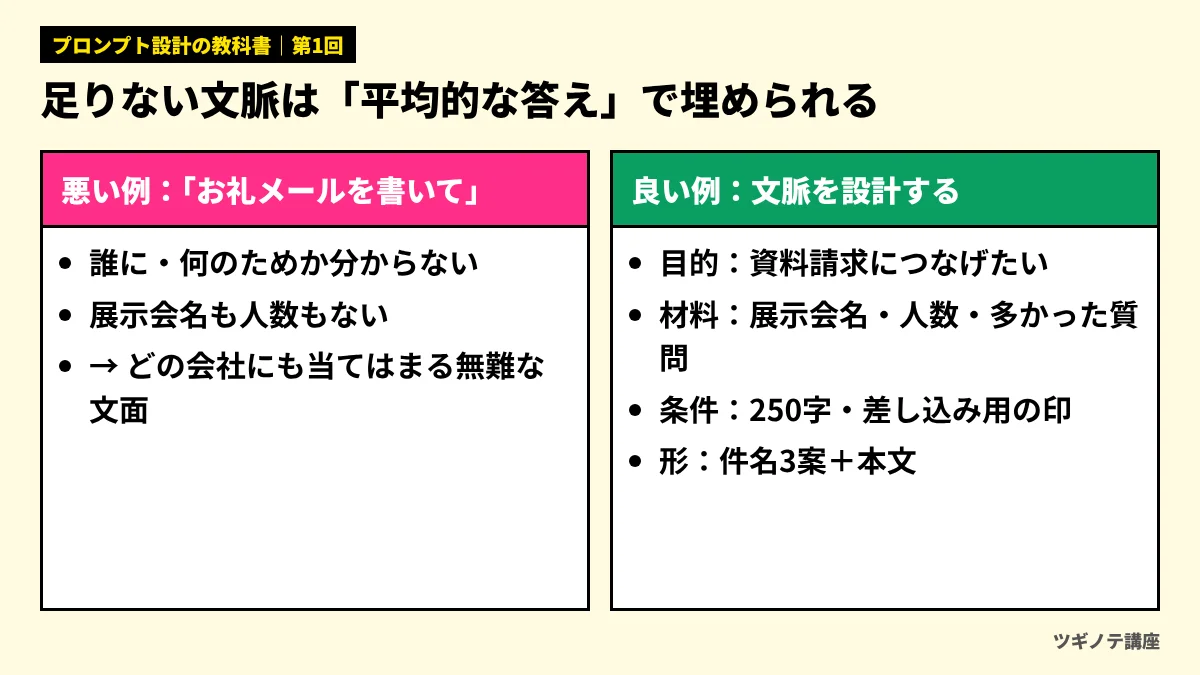
実際に比べてみましょう。次の2つは、どちらも同じ目的で書かれたプロンプトです。
悪い例
展示会のお礼メールを書いて
良い例
来週、展示会のブースで名刺交換した方々に、お礼のメールを送ります。

【目的】
・資料請求や打ち合わせにつなげたいが、売り込み色は弱めにしたい

【材料】
・展示会:11月の「〇〇EXPO」、当社は業務効率化のクラウドサービスを出展
・名刺交換した人数:約120名。業種はさまざま
・ブースで多かった質問:導入までの期間、料金の目安

【条件】
・本文は250字程度。冒頭で来場のお礼、多かった質問への短い回答、最後に資料ダウンロードの案内
・相手の名前と会社名は {氏名} {会社名} のように差し込み用の印にする

【出力形式】
件名の候補を3つ、続けて本文を1つ
悪い例でも、生成AIはそれらしいメールを書いてくれます。ただし、展示会の名前も、相手の数も、何につなげたいのかも分からないので、どの会社にも当てはまる無難な文面になります。良い例では、答えを決めるのに必要な情報が、区切りを入れて置かれています。生成AIの能力は同じでも、机の上が違えば、出てくるものが変わるのです。
文脈を整えるときは、次の3つの問いを自分に投げかけてみてください。
- 何を知っていれば、正しく答えられるか?(材料・前提・判断の基準)
- 何をしてはいけないか?(守ること・避けること)
- どんな形で受け取れば、そのまま使えるか?(長さ・構成・形式)
この3つは、第2回で「仕様書型のプロンプト」として、もう少しきちんとした型にします。
実務ではこう使う
- 仕事の種類が変わったら、新しい会話を始める。 前の話題に引っぱられるのを防げます。長い会話で条件が守られなくなったときも、要点をまとめ直して新しい会話で続けると立て直しやすくなります。
- 自分の立場や好みは「設定」に書いておく。 多くのサービスには、毎回の会話に共通して渡される設定(カスタム指示など)があります。「BtoBのSaaS企業のマーケティング担当」「文章は結論から、です・ます調で」のように書いておくと、毎回書く手間が減ります。ただし、どの会話にも効くので、特定の仕事だけの条件は入れないほうが無難です。
- うまくいったプロンプトは、そのまま保存する。 生成AIの答えではなく、頼み方のほうを残しておくと、次回からは中身を差し替えるだけで済みます。チームでの共有の仕方は第8回で扱います。
- 答えが期待と違ったら、まず「何が足りなかったか」を考える。 言い回しを変えて何度も引き直すより、足りない材料や条件を足すほうが早く安定します。
自社に合う生成AIのツールを選ぶ段階なら、法人向け生成AIツールおすすめで、データの扱いや管理機能を含めて比べています。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 生成AI(LLM)は、文脈全体を見て「もっともらしい続き」を1つずつ選び、答えを組み立てている
- 文脈は、サービスの指示・利用者の設定・会話の履歴・貼り付けた資料・道具を使った結果の5つの層でできている
- 答えがぶれるのは、確率で選んでいる、文脈が違う、モデルが変わる、の3つが主な理由
- 足りない文脈は「平均的な答え」で埋められる。プロンプト設計とは、必要なものをそろえ、余計なものを減らす「文脈の設計」
- 3つの問い:何を知っていれば正しく答えられるか、何をしてはいけないか、どんな形で受け取りたいか
確認テスト
LLMが答えをつくる仕組みの説明として、もっとも正しいものはどれでしょう?
- 質問に合う答えを、データベースから丸ごと探して表示している
- それまでの文脈を見て、次に来そうな言葉(トークン)を1つずつ選んでつなげている
- 入力された最後の一文だけを見て、答えを決めている
答えと解説
正解は2。LLMは文脈全体を手がかりに、次のトークンの候補に確率をつけて1つずつ選びます。答えを丸ごと検索しているわけではなく、最後の一文だけを見ているわけでもありません。
同僚と同じ質問を同じ生成AIにしたのに、答えの雰囲気がかなり違いました。原因として考えにくいものはどれでしょう?
- 同僚がカスタム指示に別の設定を入れていた
- 同僚は同じ会話の中で、前に別の話をしていた
- 生成AIが、質問した人の名前で答えを変えるよう決まっている
答えと解説
正解は3。答えの違いは、利用者の設定や会話の履歴など、見えない文脈の層の違いから生まれることが多いです。確率で言葉を選ぶ性質によるぶれもあります。名前で答えを変えるような決まりが原因だと考える根拠はありません。
「一歩ずつ考えて」という指示についての説明として、この回の内容に合うものはどれでしょう?
- 効果が報告された時期やモデルもあるが、考える力の強いモデルではほとんど不要とされるなど、効き方はモデルによって変わる
- どのモデルでも必ず精度が上がる、魔法の言葉である
- どのモデルでも逆効果なので、絶対に使ってはいけない
答えと解説
正解は1。2022年の研究では、当時のモデルで計算問題の正答率が大きく上がったと報告されました。一方、各社のガイドでは推論モデルにはこうした指示がほとんど不要と説明されています。決まり文句の効き方はモデル次第です。
答えが期待と違ったときの最初の対応として、もっとも適切なものはどれでしょう?
- 同じプロンプトのまま、良い答えが出るまで何度も引き直す
- 答えを決めるのに必要な材料・条件・形のうち、何が足りなかったかを考えて足す
- 生成AIは向いていないと判断して、使うのをやめる
答えと解説
正解は2。引き直しで偶然よい答えが出ても、次も同じとは限りません。足りない文脈を足すほうが、答えが安定し、次にも使える頼み方になります。
次回予告
次回は、今回の「3つの問い」を、役割・目的・前提・条件・出力形式からなる「仕様書型のプロンプト」に組み立てます。あいまいな言葉を消す書き方、してほしいことを肯定形で書くコツ、指示と材料の区切り方を、悪い例と良い例で比べながら学びます。
NEXT|第2回指示の基本設計:役割・目的・条件・出力形式を「仕様書」にする次の回へ進む →参考資料
- Google「Prompt design strategies」(Gemini API ドキュメント)。Gemini 3系では温度などの設定を既定値のまま使うことを勧めている記述を確認。
- OpenAI「Reasoning best practices」。推論モデルには段階的に考えさせる指示が不要とする記述を確認。
- Takeshi Kojima ほか「Large Language Models are Zero-Shot Reasoners」(NeurIPS 2022)。「Let’s think step by step」を加えると、当時のモデル(text-davinci-002)でMultiArithの正答率が17.7%から78.7%に上がったと報告。
- 確認日:2026年11月12日
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較