
AIに引用される仕組み:RAGと情報源の選ばれ方|AI検索対策 第2回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
KOUZAAI検索対策
第2回/全4回
講師:田中 磨生(株式会社Abin 代表取締役)この講座の目次を見る
- 第1回AI検索で何が変わったか:AIによる概要・AIモード・ChatGPT検索の現在地
- 第2回AIに引用される仕組み:RAGと情報源の選ばれ方会員
- 第3回引用されるコンテンツとサイト:一次情報・構造・サイテーション会員
- 第4回計測と体制:AI検索での言及・引用の測り方とツール、続け方会員
この回で分かること:①AIが答えをつくるときの2つの知識の出どころ(学習した知識と、その場で検索した情報)の違い ②AI検索の中心にある「RAG」という仕組みと、クエリ ファンアウトの流れ ③どんなページが情報源として選ばれやすいのか。前回は、AI検索が「AIが複数のページを読んで答えをまとめ、根拠のリンクを添える」形だと整理しました。今回は、その「読んで、まとめる」の中身を見ていきます。
AIの知識には2つの出どころがある
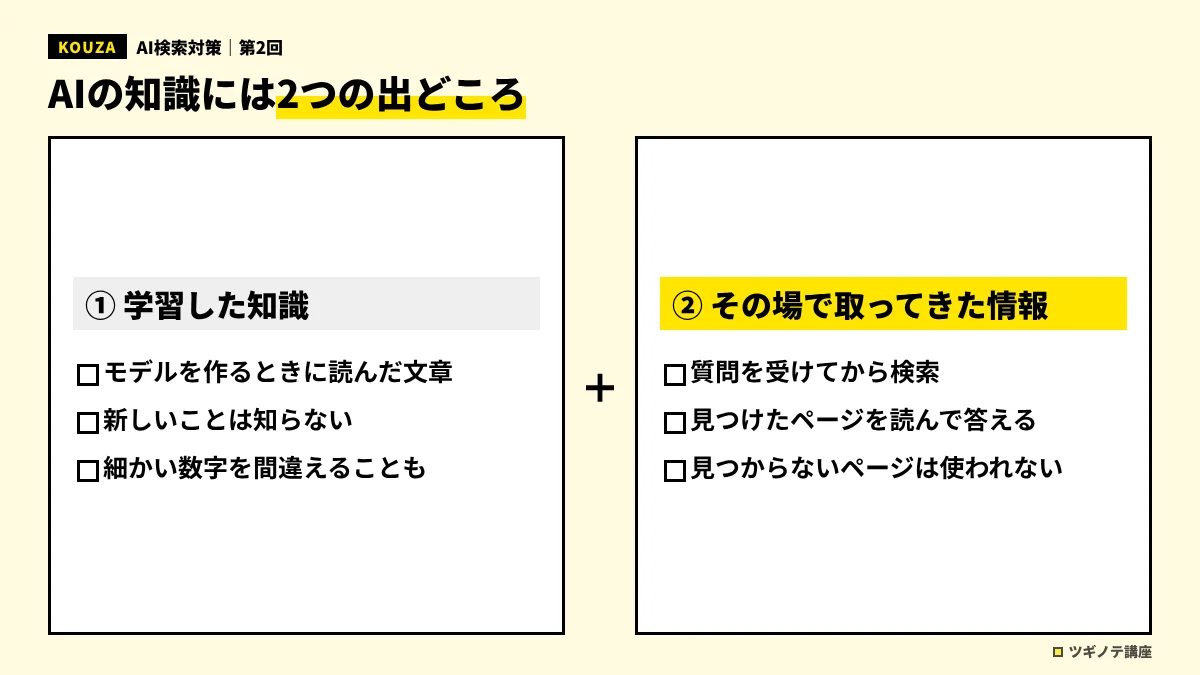
ChatGPTのような大規模言語モデル(LLM)は、大量の文章を学習して、「次にどんな言葉が来そうか」を予測することで文章をつくります。仕組みの詳細は生成AIのしくみ講座で扱いますが、AI検索対策を考えるうえで押さえたいのは、AIの答えのもとになる知識に2つの出どころがあることです。
| 出どころ | どんなものか | 弱点 |
|---|---|---|
| ① 学習した知識 | モデルをつくるときに読み込んだ大量の文章から身につけた知識 | 学習した時点より新しいことは知らない。細かい数字や固有名詞を間違えることがある |
| ② その場で取ってきた情報 | 質問を受けてから検索し、見つけたページの内容 | 検索で見つからない、読み取れないページは使えない |
たとえば、図書館の司書をイメージしてください。①は、司書がもともと頭に入れている知識です。②は、質問を受けてから書棚に行って本を取ってきて、該当ページを確認しながら答えることにあたります。頭の中の知識だけで答えると、うろ覚えのまま間違えることがあります。そこで、本を取ってきて確かめてから答えるのが②のやり方です。
AI検索で「根拠のリンク」が付いているのは、②のやり方で答えているからです。そして、サイト運営者が直接働きかけられるのも、主に②の部分です。①の学習データに自社の情報を入れてもらうことは、短期的にはほとんど制御できません。
よくある誤解:「AIに学習させれば、AI検索に出る」
「GPTBot(学習用のクローラー)を許可しないと、ChatGPTに出てこなくなる」と心配する声があります。しかしOpenAIの説明では、ChatGPTの検索結果に表示するためのクローラーは「OAI-SearchBot」で、学習用の「GPTBot」とは別に許可・拒否を設定できます。検索への表示は許可し、学習への利用は断る、という設定もできるのです。この違いは第3回で詳しく扱います。
AI検索の回答に「根拠のリンク」が付くのは、主にどちらの出どころの知識を使っているからでしょう?
- モデルが学習した知識
- 質問を受けてからその場で検索して取ってきた情報
- ユーザーが過去に入力した会話
答えと解説
正解は2。その場で検索したページを読んで答えるので、そのページを根拠としてリンクできます。サイト運営者が働きかけやすいのも、この部分です。
RAG:検索してから答える仕組み
RAGとは
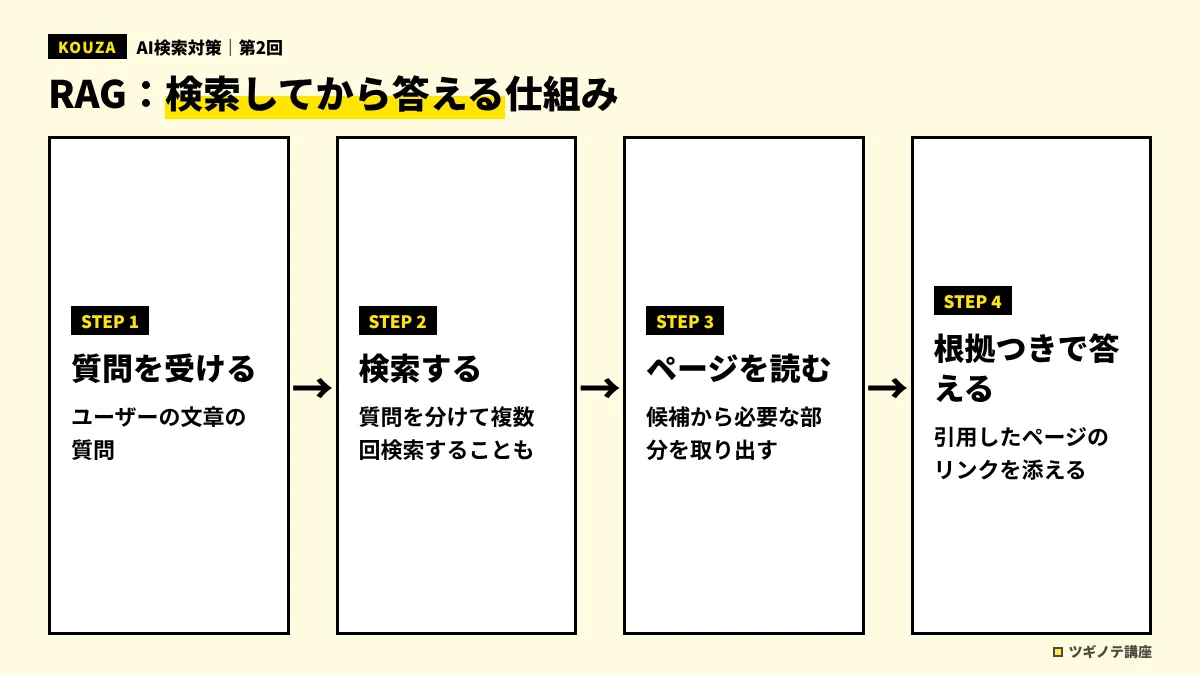
「その場で取ってきた情報を使って答える」仕組みは、一般にRAG(Retrieval-Augmented Generation、検索拡張生成)と呼ばれます。2020年にMeta(当時のFacebook)の研究者らが発表した論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」で広まった考え方で、言語モデルに外部の文書を検索する仕組みを組み合わせることで、知識が必要な質問により正確に答えられるようにするものです。
今のAI検索の多くは、細部はサービスごとに違いますが、大まかには次の流れで動いていると考えられます。
- 質問を理解する:ユーザーの質問から、何を知りたいのか、どんな条件があるのかを読み取る
- 検索する(Retrieval):検索エンジンの仕組みを使って、関係しそうなページを探す
- 読む・選ぶ:見つかったページの中から、質問に答えるのに役立つ部分を取り出す
- 答えをつくる(Generation):取り出した部分をもとに、言語モデルが文章で答えをまとめる
- 根拠を示す:答えのもとになったページをリンクとして添える
ここで注目したいのは、②の「検索する」段階です。AI検索の多くは、まず通常の検索エンジンの仕組みで候補のページを集めます。GoogleがAI機能に表示される条件として「インデックスされ、スニペット付きで検索結果に表示される資格があること」を挙げているのは、この段階で候補に入らなければ、そもそも読まれないからです。SEOがAI検索の土台だというのは、こういう意味です。
クエリ ファンアウト:1つの質問を何回も検索する
GoogleはAIモードについて、質問をサブトピックに分け、それぞれを検索する「クエリ ファンアウト」を使っていると説明しています。「AI 機能とウェブサイト」のドキュメントでも、AIによる概要とAIモードが、サブトピックやデータの出どころをまたいで複数の関連検索を行い、そこで見つかったページから、従来の検索より幅広く多様なリンクを示せると説明されています。
たとえば「従業員30人のBtoB企業がSEOを外注するとき、費用の目安と選び方は?」という質問なら、AIの裏側では次のような検索が並行して行われているイメージです。
- SEO 外注 費用 相場
- SEO会社 選び方 BtoB
- SEO 中小企業 内製 外注
- SEO会社 契約 注意点
この仕組みから分かることが2つあります。
- 「ビッグキーワードで1位」でなくても引用されうる:元の質問そのものではなく、分解されたサブトピックの検索で見つかれば、候補に入ります。ニッチでも具体的な疑問にしっかり答えているページには、出番があります。
- 1ページに全部を詰め込む必要はない:サブトピックごとに分かりやすいページがあれば、それぞれが別々に拾われる可能性があります。逆に、何でも少しずつ書いた長いだけのページは、どのサブトピックでも「いちばん分かりやすい答え」になりにくいことがあります。
クエリ ファンアウトの考え方から言えることとして、正しいものはどれでしょう?
- 大きなキーワードで1位でなくても、分解されたサブトピックで見つかれば引用されうる
- 元の質問と完全に同じ言葉を含むページしか引用されない
- 1つの質問につき、検索は1回しか行われない
答えと解説
正解は1。AIは質問をいくつかのサブトピックに分けて検索するため、具体的な疑問にしっかり答えているページにも出番があります。
どんなページが情報源として選ばれやすいのか
では、候補に入ったページの中から、AIはどれを読み、引用するのでしょうか。各社とも細かい基準は公開していません。ここでは、公式の説明と研究から言えることと、編集部の見立てを分けて整理します。
公式の説明から言えること
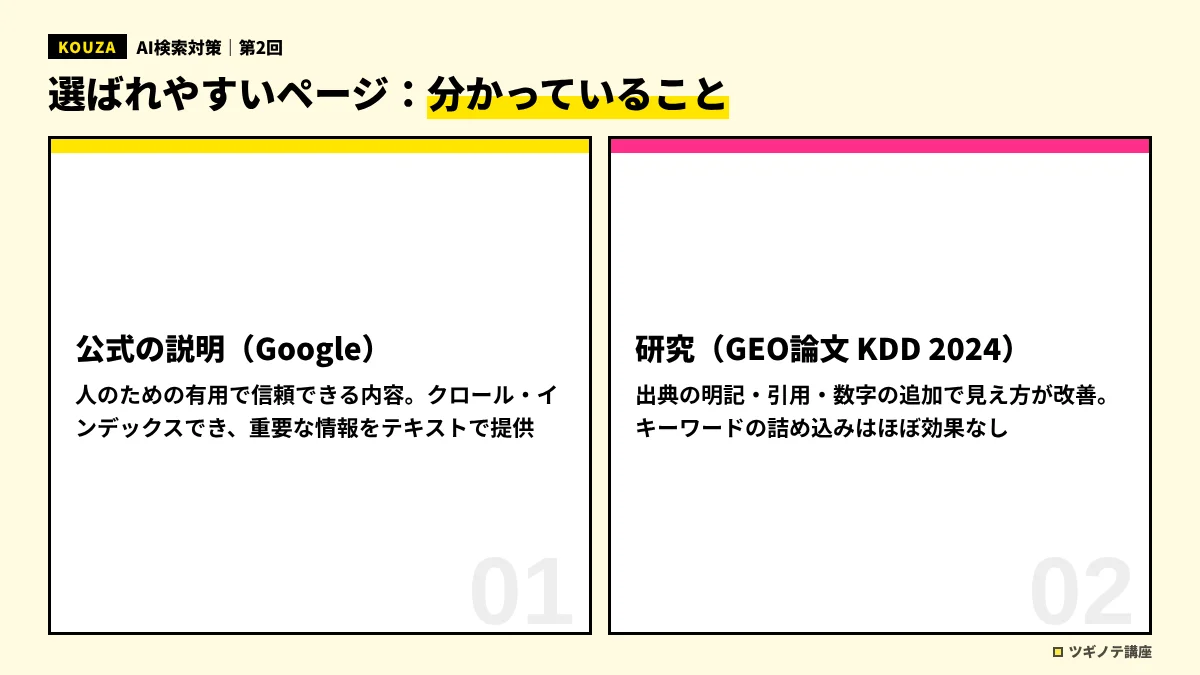
Googleは、AI機能で成果を出すための考え方として、従来から示している「ユーザーを第一に考えた、有用で信頼できるコンテンツ」をつくることを挙げています。具体的には、技術的な要件(クロールできる、インデックスできる)、内部リンクで見つけやすくすること、重要な情報をテキストで提供すること、構造化データを使うならページに見えている内容と一致させること、などです。
研究から言えること
2023年に発表され、2024年の国際会議KDDで採択された論文「GEO: Generative Engine Optimization」(プリンストン大学などの研究者)は、生成AIの検索エンジンでの「見え方」を、文章の書き方によってどう変えられるかを実験しました。約1万件の質問で試した結果、出典を明記する(Cite Sources)、専門家などの引用を加える(Quotation Addition)、統計や数字を加える(Statistics Addition)といった手法で、AIの回答の中での見え方が最大で4割ほど改善したと報告しています。一方、SEOでよく見られた「キーワードを詰め込む」手法は、ほとんど効果がありませんでした。
ただし、この研究は研究用に用意した環境での実験が中心で、実際のサービスの仕組みとは違います。また、効果は分野や質問の種類によって違い、もともと上位にあるページでは逆効果になった手法もあったと報告されています。「この書き方をすれば必ず引用される」という法則ではなく、「根拠のある具体的な情報を、出どころが分かる形で書く」ことが有利になりやすい、という方向性として受け止めるのがよいでしょう。
編集部の見立て:選ばれやすいページの4条件
公式の説明と研究を踏まえると、AIに選ばれやすいページには、次のような共通点があると考えられます。これは編集部の整理であり、各社が公表している基準ではありません。
| 条件 | 理由 | 例 |
|---|---|---|
| ① 問いに対する答えがすぐ見つかる | AIは役立つ部分を取り出して使うため、答えが埋もれていると取り出しにくい | 見出しの直後に結論を1〜2文で書く |
| ② その情報の出どころが分かる | AIも人間も、根拠のある情報を優先しやすい | 調査日、出典、誰が確認したかを明記 |
| ③ ほかのページにない情報がある | どのページにも書いてある内容なら、あなたのページを選ぶ理由がない | 自社データ、実際の事例、検証結果 |
| ④ 誰の情報かがはっきりしている | 会社や著者の実在性・専門性が伝わると、信頼の判断材料になる | 運営者情報、著者プロフィール、サイト外での言及 |
この4つは、第3回で具体的な打ち手に落とし込みます。
GEOの研究で、AIの回答での見え方を改善しにくかった手法はどれでしょう?
- 出典を明記する
- 統計や数字を加える
- キーワードを詰め込む
答えと解説
正解は3。研究では、キーワードの詰め込みはほとんど効果がなかったと報告されています。出典や数字、引用を加える手法のほうが、見え方の改善につながりやすい結果でした。
AIが「読めない・読みにくい」ページ
RAGの流れでは、候補に入ったページの中身をAIが読み取れなければ、どれだけ良いことが書いてあっても使われません。人間には見えていても、機械には読み取りにくいページがあります。代表的なものを挙げておきます。
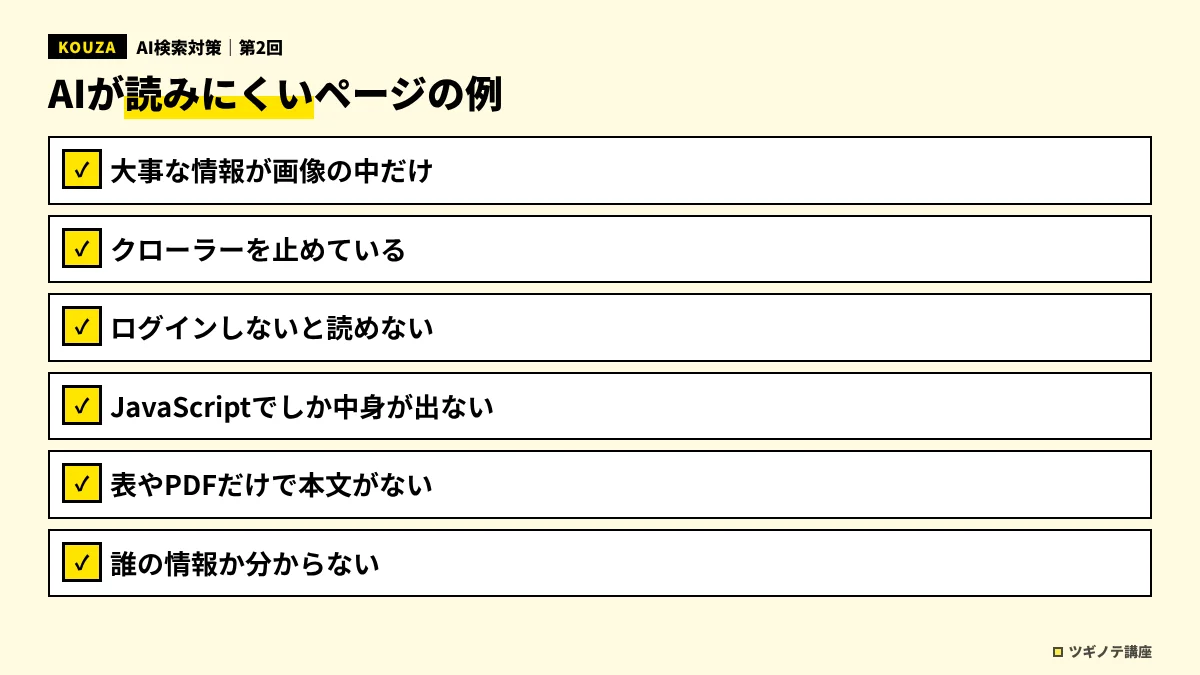
| 読みにくいもの | なぜ読みにくいか | 対処の例 |
|---|---|---|
| 画像の中の文字(料金表、図の中の説明) | 画像を文字として読み取れるとは限らない | 重要な数字や説明はテキストでも書く。画像には代替テキストを付ける |
| ボタンを押さないと出てこない情報 | クローラーが操作しないと表示されない部分は、読まれない可能性がある | 主要な情報は最初から表示されるHTMLに入れる |
| ログインや会員登録が必要なページ | クローラーはログインできない | 公開してよい要点は、ログイン前のページに書く |
| PDFだけで公開している資料 | 読める場合もあるが、HTMLに比べて構造が伝わりにくい | 要点をHTMLのページにまとめ、PDFは補足として添える |
| 表示に時間がかかる、エラーが多いページ | 取得に失敗すると、そもそも候補から外れる | 表示速度とサーバーの安定性を確認する |
Googleは、AI機能に関する説明の中で、重要な情報をテキストで提供すること、ページの体験を良くすることを挙げています。これは、「AIに読める形で情報を置く」ことと同じ意味だと考えるとよいでしょう。
もう一歩深く:学習データとRAGはどう関係しているのか
AIの答えは、②の「その場で取ってきた情報」だけでつくられているわけではありません。取ってきたページをどう読み、どう要約し、どの順番で書くかは、①の「学習した知識」で身につけた言葉の力に頼っています。また、検索するかどうか、何を検索するかを判断するのも、モデル自身です。つまり、①と②は役割分担しながら一緒に働いています。サイト運営者にとっての実務的な意味は、「事実や数字は②で取りにいくので、根拠のある最新の情報をページに置くことが効く」「言い回しや説明の組み立ては①に頼るので、自社の書き方そのものをAIにまねさせることは難しい」という2点です。
実務ではこう使う:自社のページを「AIの目」で読む
この回の内容を実務に生かすには、自社の主要なページを1つ選び、AIになったつもりで読んでみるのがおすすめです。
- お客様の質問を1つ想定する:例「〇〇の料金はいくら?」「〇〇は中小企業でも使える?」
- ページの中で答えを探す:答えは見出しの近くにあるか、何回スクロールしないと出てこないか
- 答えの根拠を確かめる:その数字や説明は、いつ時点のものか、どこで確認できるか書いてあるか
- よそとの違いを探す:このページにしか書いていない情報はあるか
多くのサイトで、「答えはあるが、ページの後半にある」「料金は『お問い合わせください』だけ」「いつ時点の情報か書いていない」といった点が見つかります。これらは、AIだけでなく人間の読者にとっても不親切な点です。AI検索対策の多くは、結局「読者にとって分かりやすく、信頼できるページにする」ことと重なります。
AI検索での引用を実際に増やした会社の打ち手は、LLMO・AIO対策の成功事例にまとめています。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- AIの知識の出どころは「学習した知識」と「その場で検索した情報」の2つ。サイト運営者が働きかけやすいのは後者
- AI検索の多くはRAG(検索してから答える)の仕組みで動いており、まず検索で候補に入ることが前提になる
- GoogleのAI機能は、質問をサブトピックに分けて検索する「クエリ ファンアウト」を使う。具体的な疑問にしっかり答えるページにも出番がある
- 研究では、出典・引用・数字を加えると見え方が改善しやすく、キーワードの詰め込みは効果が薄かった。ただし法則ではなく方向性として受け止める
確認テスト
Q1. RAG(検索拡張生成)の説明として正しいものはどれでしょう?
- AIが学習データだけを使って答える仕組み
- 質問に関係する文書を検索し、その内容をもとに答えをつくる仕組み
- 検索広告を自動でつくる仕組み
答えと解説
正解は2。RAGは、言語モデルに外部の文書を検索する仕組みを組み合わせ、見つけた情報をもとに答える方法です。AI検索の根拠のリンクは、この仕組みから来ています。
Q2. GoogleがAI機能に表示される前提として挙げている条件はどれでしょう?
- インデックスされ、スニペット付きで検索結果に表示される資格があること
- Googleの有料プランに加入していること
- ページの文字数が1万字以上あること
答えと解説
正解は1。検索で候補に入らなければ、AIに読まれることもありません。文字数や有料プランは条件ではありません。
Q3. OpenAIのクローラーについて、正しい説明はどれでしょう?
- GPTBotを拒否すると、ChatGPTの検索には絶対に表示されない
- ChatGPTの検索に表示するクローラーは存在しない
- 検索表示用のOAI-SearchBotと学習用のGPTBotは、別々に許可・拒否を設定できる
答えと解説
正解は3。OpenAIは、検索への表示はOAI-SearchBot、学習用データの収集はGPTBotと用途を分けており、それぞれ独立して設定できると説明しています。
Q4. GEOの研究結果の受け止め方として、この回の説明に合うものはどれでしょう?
- 統計を入れれば、どのページでも必ず引用が4割増える
- 根拠のある具体的な情報を出どころが分かる形で書くことが、有利になりやすいという方向性
- 研究結果はAI検索とは無関係なので参考にならない
答えと解説
正解は2。研究は実験環境での結果で、分野や順位によって効果が違いました。法則ではなく方向性として受け止めるのが妥当です。
次回予告
第3回では、この回で見た「選ばれやすいページの4条件」を、具体的な打ち手に落とし込みます。一次情報のつくり方、答えが見つけやすいページの構造、サイトの外で言及されること(サイテーション)、そしてクローラーの許可設定まで、チェックリスト形式で整理します。
参考資料
- Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(NeurIPS 2020、arXiv:2005.11401、2026年11月12日確認)
- Aggarwal ほか「GEO: Generative Engine Optimization」(KDD 2024、arXiv:2311.09735、2026年11月12日確認)
- Google 検索セントラル「AI 機能とウェブサイト」(2025年12月10日更新、2026年11月12日確認)
- Google 日本の公式ブログ「Google 検索における『AI モード』を日本語で提供開始」(2025年9月9日、2026年11月12日確認)
- OpenAI「Overview of OpenAI Crawlers」(開発者向けドキュメント、2026年11月12日確認)
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較