
マーケの分析をSQLで書く:ファネル・コホート・RFM|マーケターのためのSQL入門 第5回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
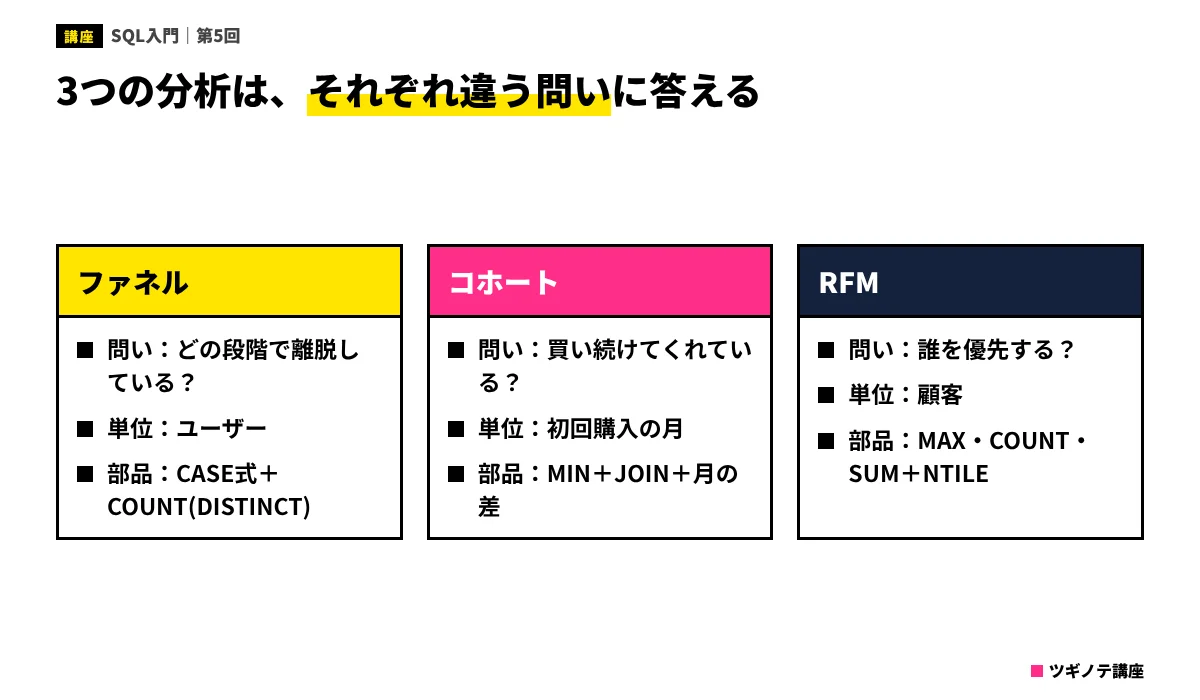
この回で分かること:①商品ページの閲覧から購入までの各段階に何人が進んだかを数える「ファネル分析」のSQL、②初めて買った月ごとに顧客を分け、その後も買い続けているかを追う「コホート分析」のSQL、③最新購入日・購入回数・購入金額で顧客をランク分けする「RFM分析」のSQLと、ウィンドウ関数の考え方。前回は、JOINで表をつなぐ方法と、WITH句で先にまとめてからつなぐ書き方を学びました。今回は、これまでの書き方を組み合わせて、マーケティングの代表的な分析を書いていきます。
この回では、第4回までより大きな架空のサンプルデータを使います。どちらも説明のために作った架空のデータで、本文の結果はこのデータで実際にSQLを実行して確かめたものです。
- events:サイトでの行動の記録(1行=1人の1回の行動)。2026年6月に商品ページを見た2,000人分の、閲覧(view_item)・カート追加(add_to_cart)・購入手続きの開始(begin_checkout)・購入(purchase)の記録
- orders_big:2026年1月〜10月の注文の記録(1行=1件の注文)。顧客600人・注文1,340件
WITH句で「段階的に」組み立てる
分析のSQLは長くなりがちです。いきなり1つの大きな文を書こうとすると、どこで間違えたのか分からなくなります。そこで、第4回で紹介したWITH句を使って、「部品」を1つずつ作り、最後に組み合わせる書き方をします。
WITH 部品1 AS (
  SELECT ...   -- 1段目:元のデータを整える
),
部品2 AS (
  SELECT ... FROM 部品1   -- 2段目:部品1を使って集計する
)
SELECT ... FROM 部品2;    -- 最後:結果を出す
WITH句の部品は、カンマで区切っていくつでも並べられ、後の部品は前の部品を使えます。料理にたとえると、「下ごしらえ」「煮る」「盛り付け」と工程ごとに分けて書くイメージです。途中の部品だけを SELECT * FROM 部品1 のように実行して、中身を確かめながら進められるのも利点です。
ファネル分析:どの段階で離脱しているか
ファネル分析は、購入までの段階ごとに何人が進んだかを数え、どこで多くの人が離れているかを見つける分析です。ECサイトなら「商品ページを見る→カートに入れる→購入手続きを始める→購入する」の4段階がよく使われます。
まず、イベントごとの人数を数えてみましょう。
SELECT event_name,
       COUNT(DISTINCT user_id) AS users
FROM events
GROUP BY event_name
ORDER BY users DESC;
| event_name | users |
|---|---|
| view_item | 2000 |
| add_to_cart | 367 |
| begin_checkout | 188 |
| purchase | 120 |
ここで COUNT(*) ではなく COUNT(DISTINCT user_id) を使っているのは、同じ人が商品ページを何度も見ていても1人と数えるためです(第3回の「件数」と「人数」の違い)。
段階ごとの「進んだ割合」を1行で出す
ファネルで大事なのは、人数そのものより「前の段階から何%が進んだか」です。第3回で学んだCASE式を使い、段階ごとの人数を横に並べてから、割合を計算します。
WITH f AS (
  SELECT
    COUNT(DISTINCT CASE WHEN event_name = 'view_item'      THEN user_id END) AS view_item,
    COUNT(DISTINCT CASE WHEN event_name = 'add_to_cart'    THEN user_id END) AS add_to_cart,
    COUNT(DISTINCT CASE WHEN event_name = 'begin_checkout' THEN user_id END) AS begin_checkout,
    COUNT(DISTINCT CASE WHEN event_name = 'purchase'       THEN user_id END) AS purchase
  FROM events
)
SELECT view_item,
       add_to_cart,
       ROUND(add_to_cart * 100.0 / view_item, 1)      AS cart_rate,
       begin_checkout,
       ROUND(begin_checkout * 100.0 / add_to_cart, 1) AS checkout_rate,
       purchase,
       ROUND(purchase * 100.0 / begin_checkout, 1)    AS purchase_rate,
       ROUND(purchase * 100.0 / view_item, 1)         AS total_rate
FROM f;
| view_item | add_to_cart | cart_rate | begin_checkout | checkout_rate | purchase | purchase_rate | total_rate |
|---|---|---|---|---|---|---|---|
| 2000 | 367 | 18.4 | 188 | 51.2 | 120 | 63.8 | 6.0 |
CASE WHEN event_name = ‘add_to_cart’ THEN user_id END は、カート追加の行ならuser_idを、それ以外ならNULLを返します。COUNT(DISTINCT …) はNULLを数えないので、「カートに入れた人の数」だけが数えられます。この「CASE式で条件に合うものだけを残して数える」書き方は、ファネル以外にもさまざまな場面で使えます。
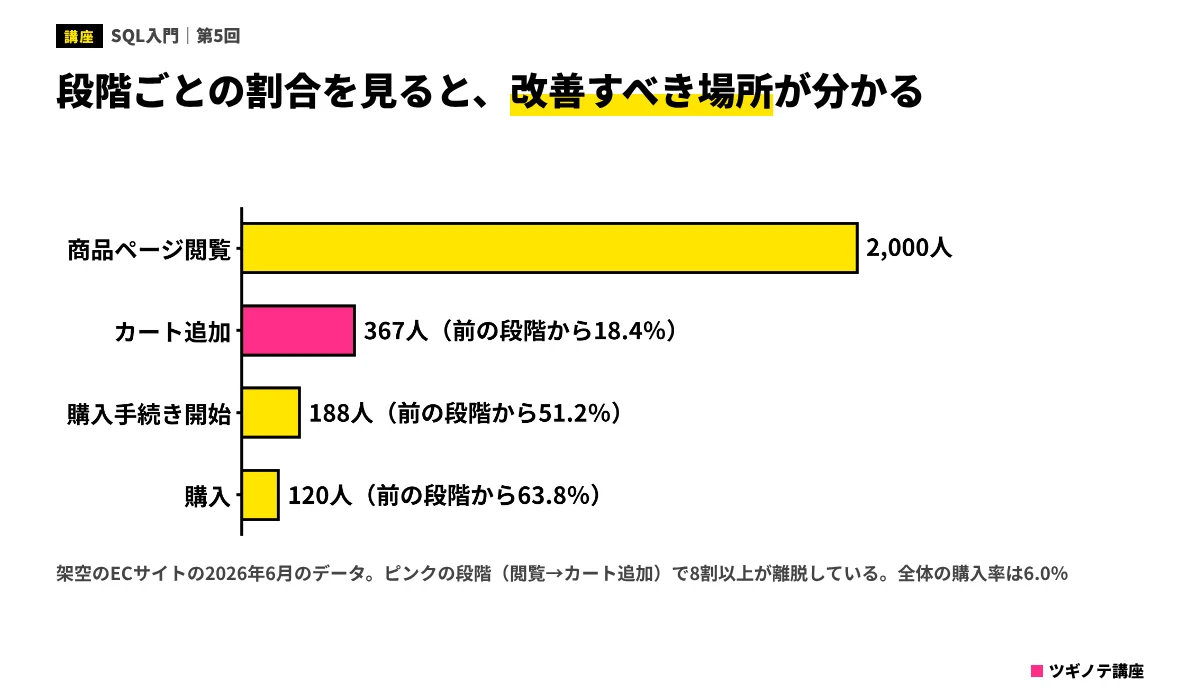
結果を見ると、全体の購入率(閲覧した人のうち購入した人)は6.0%です。段階別では、閲覧からカート追加に進んだのが18.4%と最も低く、ここで8割以上の人が離れています。改善の優先順位を考えるなら、まず商品ページ(写真・説明・価格の見せ方など)を見直すのがよさそうだ、という仮説が立ちます。
よくある誤解:「イベントの人数を数えれば、それがファネル」
上の書き方は「それぞれのイベントをした人の数」を数えています。サンプルデータでは、カートに入れた人は必ず商品ページを見ているので問題ありませんが、実際のデータでは「カートを経由せずに購入した人」「前の段階の記録が取れていない人」もいます。
厳密なファネルにするには、ユーザーごとに「どの段階まで進んだか」を判定してから数えます。WITH句の1段目でユーザー1人=1行にまとめ、各段階をしたかどうかを0か1で持たせ、前の段階もすべて1の人だけを数える、という組み立て方です。サンプルデータでこの厳密な数え方をしても、結果は同じ2,000人・367人・188人・120人になることを確かめています。期間の区切り(同じ日のうちか、7日以内か)も、分析の目的に合わせて決めておきましょう。
ファネル分析で COUNT(DISTINCT CASE WHEN event_name = ‘purchase’ THEN user_id END) が数えているものはどれでしょう?
- すべてのイベントの件数
- 購入(purchase)のイベントをしたユーザーの人数(同じ人は1人と数える)
- 購入のイベントの件数(同じ人が2回買えば2と数える)
答えと解説
正解は2です。CASE式で購入の行だけuser_idを残し、それ以外はNULLにします。COUNT(DISTINCT …) はNULLを数えず、重複も除くので、購入した人の人数になります。
コホート分析:買い続けてくれているか
コホートとは、「同じ時期に同じ体験をした人の集まり」のことです。顧客の分析では、初めて買った月でグループを作ることがよくあります。コホートごとに「1か月後、2か月後……にも買っているか」を追うと、顧客の定着の様子が分かります。
月別の売上だけを見ていると、新規の顧客が増えたのか、既存の顧客が買い続けているのかが区別できません。コホート分析は、この2つを分けて見るための方法です。
SQLは、次の3段階で組み立てます。
- 顧客ごとに、初めて買った日(MINで求める)を出す
- 注文の表とJOINして、各注文が「初回購入の何か月後か」を計算する
- 初回購入の月(コホート)ごとに、0か月後・1か月後……に買った人数を数える
WITH first_order AS (
  SELECT customer_id, MIN(order_date) AS first_date
  FROM orders_big
  GROUP BY customer_id
),
activity AS (
  SELECT f.customer_id,
         substr(f.first_date, 1, 7) AS cohort,
         (CAST(substr(o.order_date, 1, 4) AS INTEGER) * 12 + CAST(substr(o.order_date, 6, 2) AS INTEGER))
       - (CAST(substr(f.first_date, 1, 4) AS INTEGER) * 12 + CAST(substr(f.first_date, 6, 2) AS INTEGER)) AS month_n
  FROM first_order AS f
  INNER JOIN orders_big AS o ON f.customer_id = o.customer_id
)
SELECT cohort,
       COUNT(DISTINCT CASE WHEN month_n = 0 THEN customer_id END) AS m0,
       COUNT(DISTINCT CASE WHEN month_n = 1 THEN customer_id END) AS m1,
       COUNT(DISTINCT CASE WHEN month_n = 2 THEN customer_id END) AS m2,
       COUNT(DISTINCT CASE WHEN month_n = 3 THEN customer_id END) AS m3
FROM activity
GROUP BY cohort
ORDER BY cohort;
| cohort | m0 | m1 | m2 | m3 |
|---|---|---|---|---|
| 2026-01 | 111 | 30 | 30 | 18 |
| 2026-02 | 103 | 24 | 23 | 22 |
| 2026-03 | 95 | 29 | 33 | 18 |
| 2026-04 | 92 | 27 | 33 | 18 |
| 2026-05 | 93 | 21 | 31 | 17 |
| 2026-06 | 106 | 30 | 36 | 26 |
2段目の month_n は、「年×12+月」の差で、初回購入の月から何か月後かを計算しています。これはSQLiteで動かすための書き方です。BigQueryなら、日付型の列に対して DATE_DIFF(o.order_date, f.first_date, MONTH) のように、日付の差を月単位で求める関数が使えます(第6回)。
m0 はその月に初めて買った人数、m1 は1か月後にも買った人数です。人数のままでは比べにくいので、m0 に対する割合にすると次のようになります(最後の SELECT で m1 * 100.0 / m0 のように計算した結果)。
| cohort | m0 | m1(%) | m2(%) | m3(%) |
|---|---|---|---|---|
| 2026-01 | 111 | 27.0 | 27.0 | 16.2 |
| 2026-02 | 103 | 23.3 | 22.3 | 21.4 |
| 2026-03 | 95 | 30.5 | 34.7 | 18.9 |
| 2026-04 | 92 | 29.3 | 35.9 | 19.6 |
| 2026-05 | 93 | 22.6 | 33.3 | 18.3 |
| 2026-06 | 106 | 28.3 | 34.0 | 24.5 |
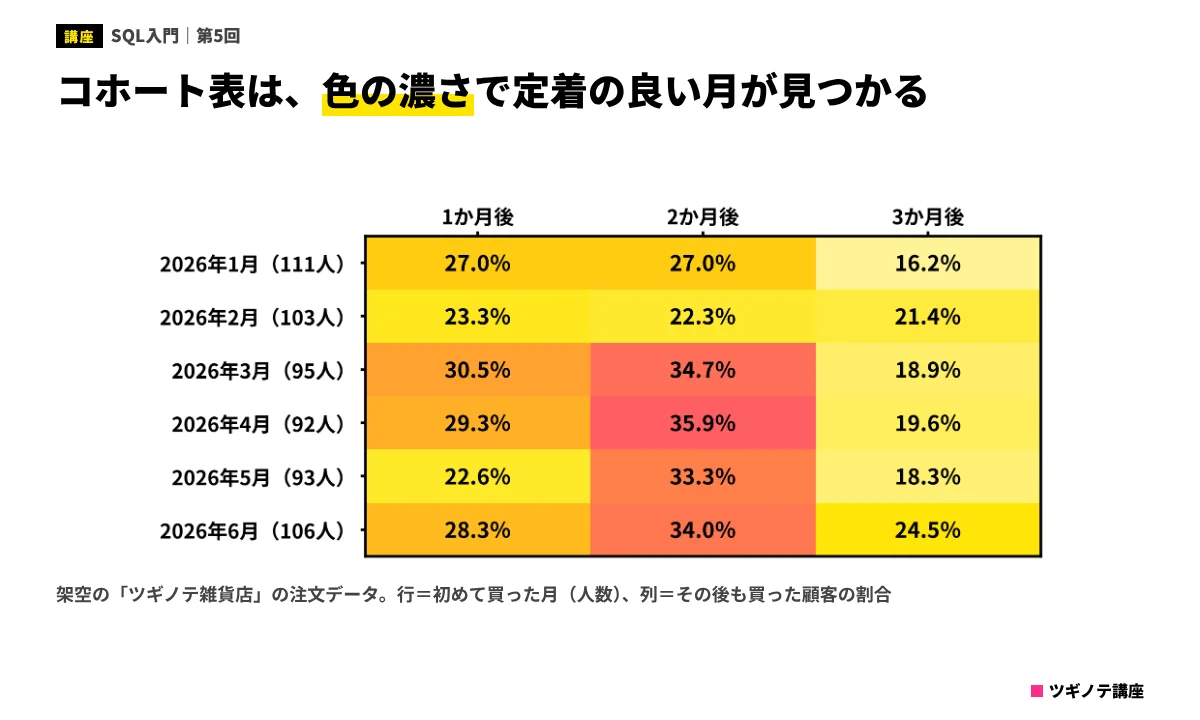
表を横に読むと、1つのコホートが時間とともにどれだけ残っているかが分かります。縦に読むと、同じ「〇か月後」をコホートどうしで比べられます。たとえば3か月後の継続率は、6月に初めて買った顧客が24.5%と、ほかの月より高くなっています。「6月に始めた施策(同梱物やフォローメールなど)が効いたのでは」という仮説を立て、詳しく調べるきっかけになります。
なお、このサンプルデータでは、1か月後より2か月後のほうが割合の高い月があります。これは、この架空の店の商品が1〜2か月おきに買われることを想定して作ったためです。実際の分析でも、商品の買い替えの周期によって、どの間隔で見るのがよいかは変わります。
コホート分析の説明として最も適切なものはどれでしょう?
- 月別の売上の合計を、前年同月と比べる分析
- 顧客を購入金額の大きい順に並べる分析
- 初めて買った月などで顧客をグループに分け、その後も買い続けているかを時間を追って比べる分析
答えと解説
正解は3です。コホート分析は、同じ時期に始めた顧客のグループごとに、その後の継続を追います。月別の売上だけでは見えない「新規」と「継続」の違いを分けて見られます。
RFM分析:顧客をランク分けする
RFM分析は、次の3つの指標で顧客を分ける方法です。
- R(Recency):最後に買ったのはいつか(最近ほど良い)
- F(Frequency):何回買ったか(多いほど良い)
- M(Monetary):合計でいくら買ったか(多いほど良い)
3つの組み合わせで、「最近もよく買ってくれる優良顧客」「以前はよく買っていたが最近来ない、離れかけの常連」などを見分け、それぞれに合った施策(特典、休眠の掘り起こしのメールなど)を考えます。
ウィンドウ関数 NTILE で3段階に分ける
各指標を「上・中・下」の3段階に分けるために、ウィンドウ関数を使います。ウィンドウ関数は、GROUP BYのように行をまとめずに、「並べたときの順位」や「全体の中での位置」を各行に付けられる関数です。ここで使う NTILE(3) OVER (ORDER BY 列) は、指定した順に並べて、行を3つのグループにほぼ同じ人数ずつ分け、1〜3の番号を付けます。
WITH base AS (
  SELECT customer_id,
         CAST(julianday('2026-10-31') - julianday(MAX(order_date)) AS INTEGER) AS recency_days,
         COUNT(*)    AS frequency,
         SUM(amount) AS monetary
  FROM orders_big
  GROUP BY customer_id
),
scored AS (
  SELECT customer_id, recency_days, frequency, monetary,
         NTILE(3) OVER (ORDER BY recency_days DESC) AS r,
         NTILE(3) OVER (ORDER BY frequency ASC)     AS f,
         NTILE(3) OVER (ORDER BY monetary ASC)      AS m
  FROM base
)
SELECT r, f, m,
       COUNT(*) AS customers,
       ROUND(AVG(recency_days))  AS avg_recency,
       ROUND(AVG(frequency), 1)  AS avg_frequency,
       ROUND(AVG(monetary))      AS avg_monetary
FROM scored
GROUP BY r, f, m
ORDER BY customers DESC
LIMIT 5;
| r | f | m | customers | avg_recency | avg_frequency | avg_monetary |
|---|---|---|---|---|---|---|
| 3 | 3 | 3 | 142 | 48.0 | 4.3 | 20282.0 |
| 1 | 1 | 1 | 111 | 261.0 | 1.0 | 3402.0 |
| 2 | 1 | 1 | 79 | 166.0 | 1.0 | 3519.0 |
| 1 | 2 | 2 | 70 | 250.0 | 1.3 | 7223.0 |
| 2 | 2 | 2 | 68 | 165.0 | 1.6 | 7912.0 |
1段目(base)で顧客ごとにR・F・Mの値を出し、2段目(scored)で3段階のスコアを付け、最後にスコアの組み合わせごとに人数と平均を出しています。recency_days は、分析の基準日(2026年10月31日)から最後の注文日までの日数です。julianday は日付を日数に変えるSQLiteの関数で、BigQueryなら DATE_DIFF(基準日, 最後の注文日, DAY) で求めます。
結果を見ると、R・F・Mがすべて3(最近買っていて、回数も金額も多い)の優良顧客が142人で、平均で4.3回・約2万円買っています。一方、すべて1(最後の購入から平均261日、1回だけ)の顧客は111人です。前者には感謝の特典や新商品の先行案内、後者には再来店のきっかけになるクーポン、といった施策の分け方が考えられます。
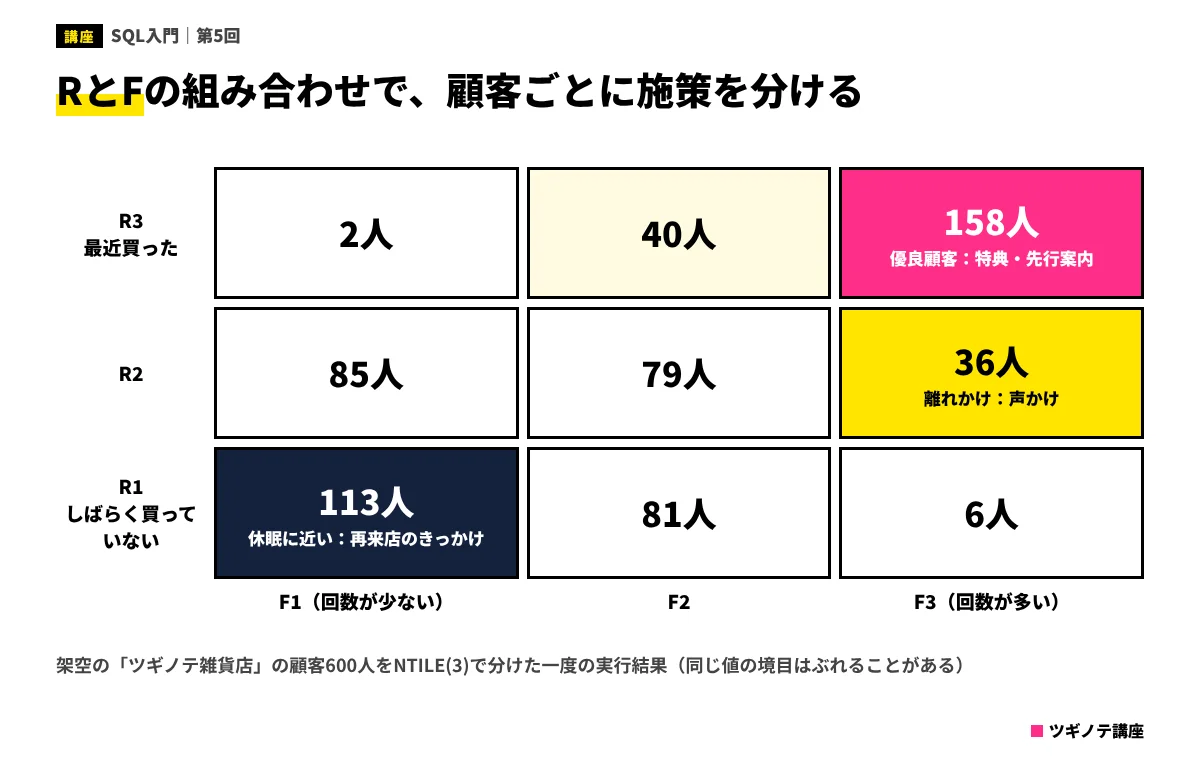
よくある誤解:「NTILEなら、いつも同じ基準できれいに分かれる」
NTILEは「人数がほぼ同じになるように」分けるので、値に同じものが多いと、境目でどちらに入るかが決まりきりません。このサンプルでは、購入回数が1回の顧客が多いため、F(回数)が「1回」でも、スコアが1になる人と2になる人に分かれています(上の表で、平均回数が1.0なのにfが1の行と、1.3なのにfが2の行がある)。どちらに入るかはデータベースや実行のたびに変わることもあります。
報告や施策に使うときは、「購入回数が3回以上なら3」のように、CASE式で意味のある基準を決めて分けるほうが、説明しやすく再現性も高くなります。NTILEは、まず全体の分布をつかむための道具として使うとよいでしょう。
RFM分析の「R(Recency)」が表すものはどれでしょう?
- 最後に購入したのがどれくらい最近か
- これまでに購入した回数
- これまでに購入した金額の合計
答えと解説
正解は1です。Rは最新の購入日の近さ、Fは購入回数、Mは購入金額の合計です。Rは「最後の購入からの日数」で表すことが多く、日数が少ないほど良いと考えます。
実務ではこう使う
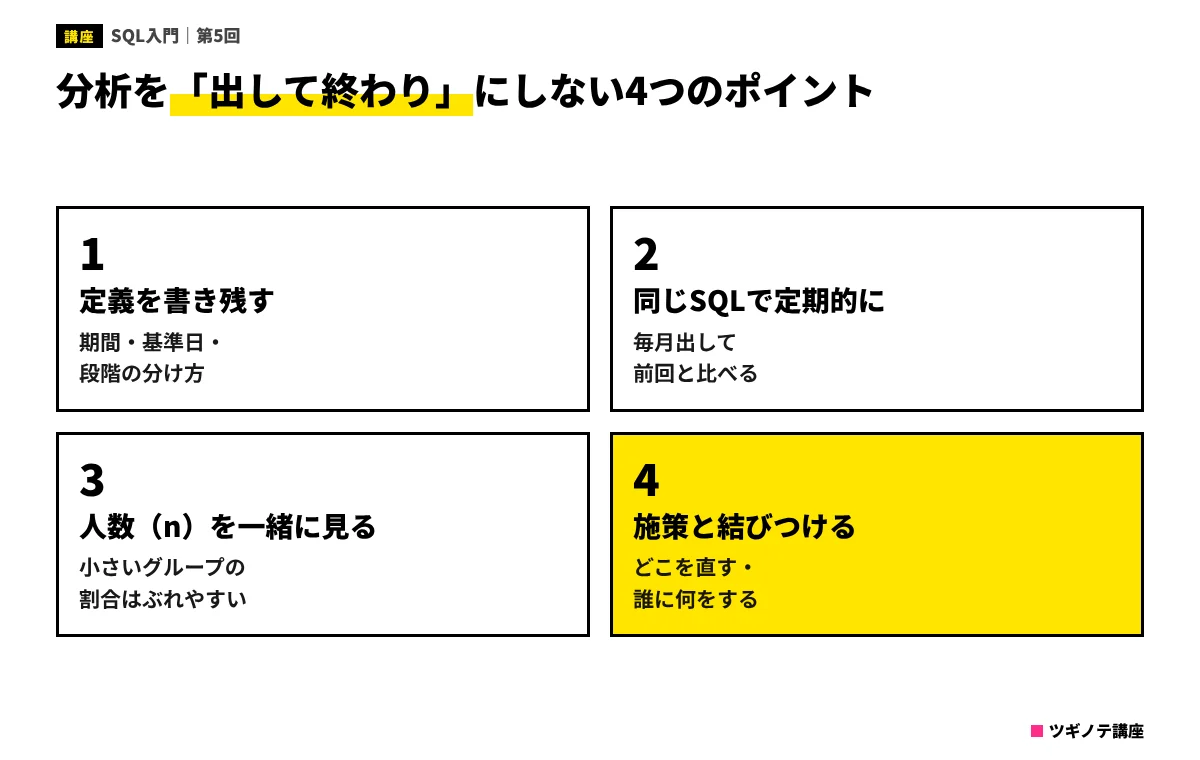
ファネル・コホート・RFMは、どれも「一度出して終わり」ではなく、施策の前後や月ごとに比べてこそ意味が出る分析です。次の点を意識すると、実務で使いやすくなります。
- 定義を書き残す:ファネルの期間(同じ日か、7日以内か)、コホートの基準(初回購入か、会員登録か)、RFMの基準日と段階の分け方を、SQLのコメントやドキュメントに残す
- 同じSQLで定期的に出す:毎月同じSQLを実行し、前回と比べる。数字が大きく動いたら、施策の変化か、データの取り方の変化かを確かめる
- 小さいグループの割合に注意する:人数の少ないコホートやスコアの組み合わせは、割合がぶれやすい。人数(n)を必ず一緒に見る
- 施策と結びつける:「どこで離脱しているか」「どのコホートが残っているか」「どの層に何をするか」まで決めて、はじめて分析が仕事になる
分析した結果を、毎月見られるダッシュボードにまとめるならBIとダッシュボード設計(全6回)が、コホートやRFMの数字の読み方(誤差やサンプルサイズ)を深めるならマーケターのためのデータ分析・統計入門(全10回)が参考になります。顧客をランク分けしたあとの施策を自動化したい場合は、MAツールおすすめ比較も見てみてください。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→この回のまとめ
- 長い分析のSQLは、WITH句で部品に分け、途中の結果を確かめながら段階的に組み立てます。
- ファネル分析は、CASE式とCOUNT(DISTINCT …) で段階ごとの人数を数え、前の段階から進んだ割合で離脱の大きい場所を探します。
- コホート分析は、MINで初回購入日を求め、注文とJOINして「何か月後か」を計算し、コホートごとの継続を比べます。
- RFM分析は、最新購入日・回数・金額で顧客を分けます。NTILEなどのウィンドウ関数で段階を付けられますが、同じ値が多いと境目がぶれます。
- 定義を書き残し、同じSQLで定期的に出し、人数を一緒に見て、施策と結びつけることで分析が生きます。
確認テスト
ファネル分析で「閲覧→カート追加18.4%」「カート追加→購入手続き51.2%」「購入手続き→購入63.8%」でした。最初に見直すべき場所として、この結果から最も自然に言えるのはどれでしょう?
- 購入手続きの画面(最も割合が高いので)
- 購入完了後のお礼のページ
- 商品ページ(閲覧からカート追加の割合が最も低く、多くの人が離れているので)
答えと解説
正解は3です。前の段階から進んだ割合が最も低いのは閲覧→カート追加で、8割以上が離れています。ここを改善すると、後ろの段階に進む人の数全体が増えるため、優先度が高いと考えられます。
コホート分析で、各顧客の「初めて買った日」を求めるのに使う集計関数はどれでしょう?
- MAX(order_date)
- MIN(order_date)
- COUNT(order_date)
答えと解説
正解は2です。顧客ごとにGROUP BYして、注文日の最小値(MIN)を取ると、初めて買った日になります。MAXは最後に買った日で、RFM分析のRで使います。
WITH句を使って分析のSQLを組み立てる利点として、最も適切なものはどれでしょう?
- 処理を部品に分けて書け、途中の部品の結果を確かめながら進められる
- WITH句を使うと、データベースの料金が必ず安くなる
- WITH句を使えば、JOINやGROUP BYが不要になる
答えと解説
正解は1です。WITH句は長いSQLを工程ごとの部品に分けて読みやすくし、途中の結果を確かめやすくします。料金や処理の量が必ず減るわけではありません。
NTILE(3) で購入回数を3段階に分けたところ、同じ「1回」の顧客がスコア1とスコア2に分かれました。報告や施策に使うときの対応として最も適切なものはどれでしょう?
- NTILEの結果をそのまま使い、境目の顧客は気にしない
- NTILE(3) を NTILE(10) に変えれば、境目の問題はなくなる
- 「3回以上なら3」のように、CASE式で意味のある基準を決めて分ける
答えと解説
正解は3です。NTILEは人数をそろえるように分けるので、同じ値が多いと境目がぶれます。説明しやすく再現性のある分け方にするには、意味のある基準をCASE式で決めるのがよい方法です。
次回予告
最終回の次回は、実務でSQLを使うときに欠かせない知識を学びます。BigQueryの料金のしくみ(読み込んだデータ量で決まる)と費用を抑える書き方、権限の考え方、GA4のデータをBigQueryに出力して分析するときの表の構造と注意点を見ていきます。
参考資料
- Google Cloud「GoogleSQL:Date functions(DATE_DIFF)」(確認日:2026年11月12日)https://docs.cloud.google.com/bigquery/docs/reference/standard-sql/date_functions
- Google Cloud「GoogleSQL:Numbering functions(NTILE)」(確認日:2026年11月12日)https://docs.cloud.google.com/bigquery/docs/reference/standard-sql/numbering_functions
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較