
集計の基本:GROUP BYと集計関数で数字をまとめる|マーケターのためのSQL入門 第3回

監修田中 磨生株式会社Abin 代表取締役
株式会社Abin代表取締役。AI SaaSの上場企業やHR系ベンチャーのマーケティング責任者を経て、2023年BtoBマーケティング特化のコンサルティング会社株式会社Abinを設立。創業から30社以上のBtoBマーケティングの戦略立案から実行までを行う。2025年には株式会社プロベルの役員に就任。NYマーケティング株式会社の執行役員も務める。
執筆Abin編集部
この回で分かること:①COUNT・SUM・AVG・MIN・MAXといった集計関数で、たくさんの行を1つの数字にまとめる方法と、「件数」と「人数」の数え分け、②GROUP BYで月別・カテゴリー別・顧客別に数字をまとめる書き方と、守るべきルール、③HAVINGでまとめた結果を絞る方法と、CASE式で自分なりの区分を作る方法。前回は、SELECT・WHERE・ORDER BYで、表から必要な行と列を取り出す方法を学びました。今回は、取り出した行を「まとめて数字にする」方法を学びます。
この回の例も、架空の通販「ツギノテ雑貨店」のサンプルデータで実際に実行し、結果を確かめたものです。データは説明のために作った架空のものです。
FOR BUSINESS
マーケティング・DXの発注先選びに迷ったら
ツギノテを運営する株式会社Abinは、BtoBマーケティングに特化したコンサルティング会社です。創業から30社以上のBtoBマーケティングを支援してきました。
相談無料ツギノテ編集部に相談する→集計関数:たくさんの行を1つの数字にまとめる
マーケティングで知りたい数字の多くは、「合計」「平均」「件数」のように、たくさんの行をまとめた数字です。SQLでは、これを集計関数で計算します。よく使うのは次の5つです。
| 集計関数 | 意味 | マーケティングでの例 |
|---|---|---|
| COUNT | 行の数を数える | 注文件数、会員数 |
| SUM | 合計する | 売上の合計、広告費の合計 |
| AVG | 平均する | 平均の注文金額(客単価) |
| MIN | いちばん小さい値 | 最初の注文日、最安の注文 |
| MAX | いちばん大きい値 | 最後の注文日、最高額の注文 |
注文の表全体について、5つの数字を一度に出してみましょう。
SELECT COUNT(*)    AS orders,
       SUM(amount) AS sales,
       AVG(amount) AS avg_amount,
       MIN(amount) AS min_amount,
       MAX(amount) AS max_amount
FROM orders;
| orders | sales | avg_amount | min_amount | max_amount |
|---|---|---|---|---|
| 15 | 69800 | 4653.333333333333 | 1500 | 12800 |
15件の注文で、売上の合計は69,800円、1件あたりの平均は約4,653円です。平均は割り切れないと小数が長く続くので、レポートに使うときは ROUND(AVG(amount)) のように ROUNDで丸めると読みやすくなります。
集計関数を使うと、15行あった表が1行の結果にまとまります。これが集計の基本の考え方です。
「件数」と「人数」を数え分ける:COUNT(DISTINCT …)
第1回で、注文の表の1行は「1件の注文」だと確認しました。では、「注文した人は何人か」を知りたいときはどうすればよいでしょうか。
SELECT COUNT(*)                    AS orders,
       COUNT(DISTINCT customer_id) AS buyers
FROM orders;
| orders | buyers |
|---|---|
| 15 | 8 |
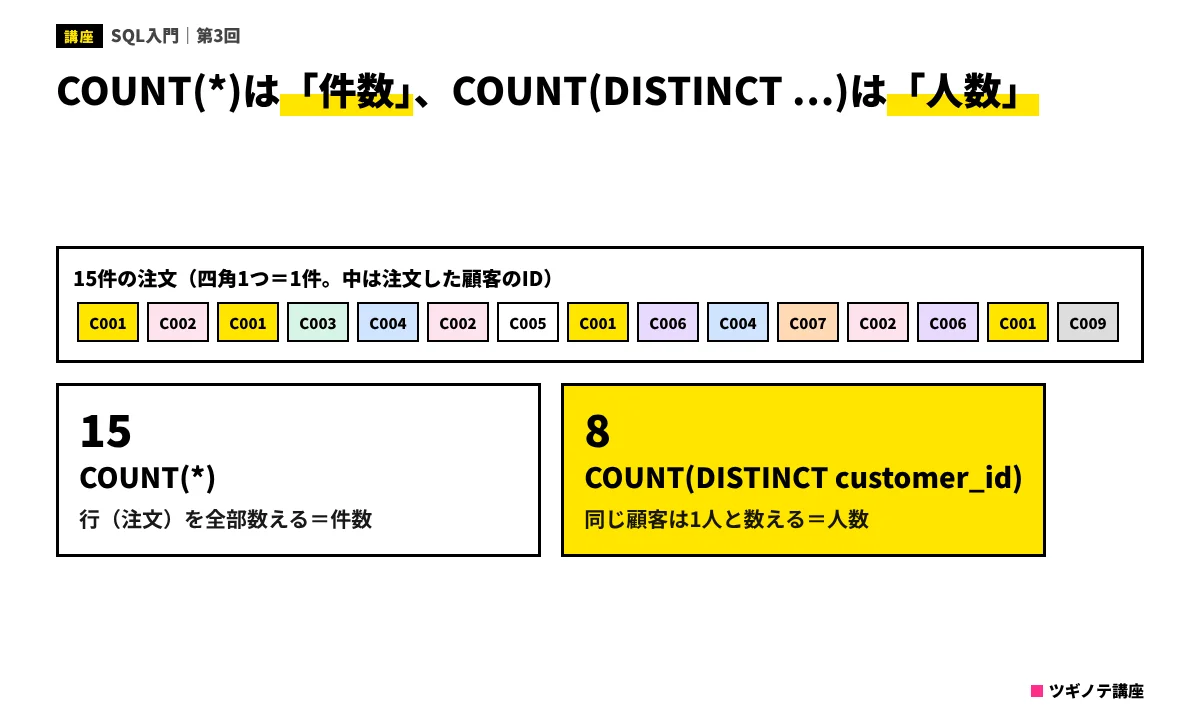
COUNT(DISTINCT 列)は、その列の重複を取り除いてから数えます。注文は15件ですが、同じ顧客が何度も注文しているため、注文した顧客は8人です。
この違いは、マーケティングの数字では特に大切です。たとえば「購入者1人あたりの売上」は、売上の合計を「件数」ではなく「人数」で割らなければなりません。サンプルデータでは、1件あたりの平均は約4,653円ですが、1人あたりの売上は69,800円÷8人=8,725円です。どちらを報告しているのかを、名前と定義ではっきりさせておきましょう。
NULLと集計関数
COUNT・SUM・AVGなどの集計関数は、NULL(値がない)の行を無視して計算します。COUNT(*) は行そのものを数えるのでNULLも含めますが、COUNT(列) はその列がNULLの行を数えません。
これは便利な反面、注意も必要です。たとえば、アンケートの満足度の列に未回答(NULL)が多い場合、AVG(満足度) は「回答した人だけの平均」になります。回答率が低いと、その平均は全体を代表しないかもしれません。集計の前に、NULLがどれくらいあるかを COUNT(*) と COUNT(列) の差で確かめる習慣をつけましょう。
注文の表で「購入者1人あたりの売上」を計算したいとき、正しい考え方はどれでしょう?
- 売上の合計 ÷ COUNT(*)
- 売上の合計 ÷ COUNT(DISTINCT customer_id)
- AVG(amount) をそのまま使う
答えと解説
正解は2です。COUNT() は注文の件数なので、売上÷COUNT() は「1件あたり」の金額(AVG(amount) と同じ)になります。1人あたりにするには、重複を除いた人数で割ります。
GROUP BY:グループごとにまとめる
全体の合計だけでなく、「カテゴリーごと」「月ごと」「顧客ごと」の数字を知りたいことがほとんどです。そのときに使うのがGROUP BYです。カテゴリーごとの注文件数と売上を出してみましょう。
SELECT category,
       COUNT(*)    AS orders,
       SUM(amount) AS sales
FROM orders
GROUP BY category
ORDER BY sales DESC;
| category | orders | sales |
|---|---|---|
| インテリア | 4 | 38600 |
| 食器 | 5 | 18300 |
| 雑貨 | 6 | 12900 |
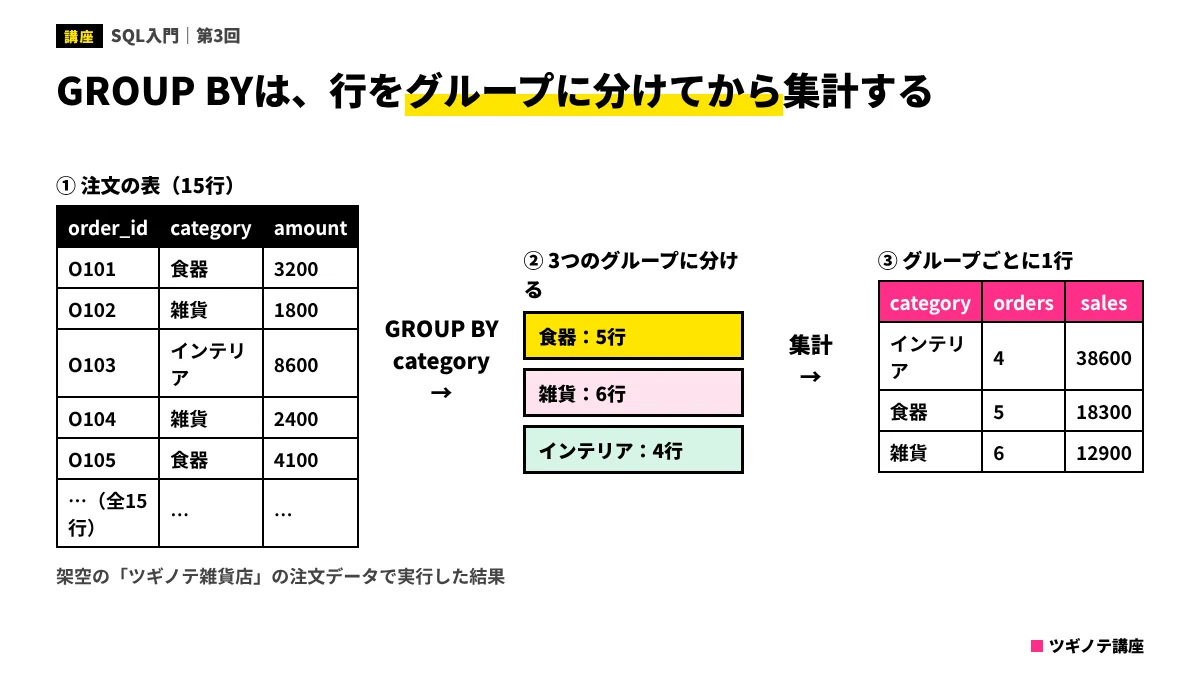
図1のように、GROUP BY category は、15行の注文を「食器」「雑貨」「インテリア」の3つのグループに分け、グループごとに集計関数を計算します。件数がいちばん多いのは雑貨(6件)ですが、売上がいちばん大きいのはインテリア(38,600円)だと分かります。件数だけ、売上だけを見ていると気づかない違いです。
同じように、顧客ごとにまとめると、誰がたくさん買ってくれているかが分かります。
SELECT customer_id,
       COUNT(*)    AS orders,
       SUM(amount) AS sales
FROM orders
GROUP BY customer_id
ORDER BY sales DESC;
| customer_id | orders | sales |
|---|---|---|
| C001 | 4 | 17800 |
| C005 | 1 | 12800 |
| C006 | 2 | 11000 |
| C007 | 1 | 9800 |
| C002 | 3 | 7800 |
| C004 | 2 | 6300 |
| C003 | 1 | 2400 |
| C009 | 1 | 1900 |
GROUP BYのルール:SELECTに書けるもの
GROUP BYを使うときには、大事なルールがあります。SELECTに書けるのは、GROUP BYに書いた列と、集計関数だけです。
たとえば GROUP BY category のときに、SELECTに order_id をそのまま書くと、どうなるでしょうか。食器のグループには5件の注文があるので、どの order_id を出せばよいかが決まりません。BigQueryをはじめ多くのデータベースは、この書き方をエラーにします(SQLiteのように、どれか1つの値を勝手に出してしまうデータベースもあり、かえって間違いに気づきにくくなります)。
グループの中の値を出したいときは、MIN(order_date)(最初の注文日)やMAX(amount)(最高額)のように、集計関数で「どの値を出すか」を決めて書きます。
月別に集計する
マーケティングのレポートで最もよく使うのが、月別の集計です。注文日を「年-月」に変えて、それでGROUP BYします。
SELECT substr(order_date, 1, 7)    AS month,
       COUNT(*)                    AS orders,
       SUM(amount)                 AS sales,
       COUNT(DISTINCT customer_id) AS buyers
FROM orders
GROUP BY month
ORDER BY month;
| month | orders | sales | buyers |
|---|---|---|---|
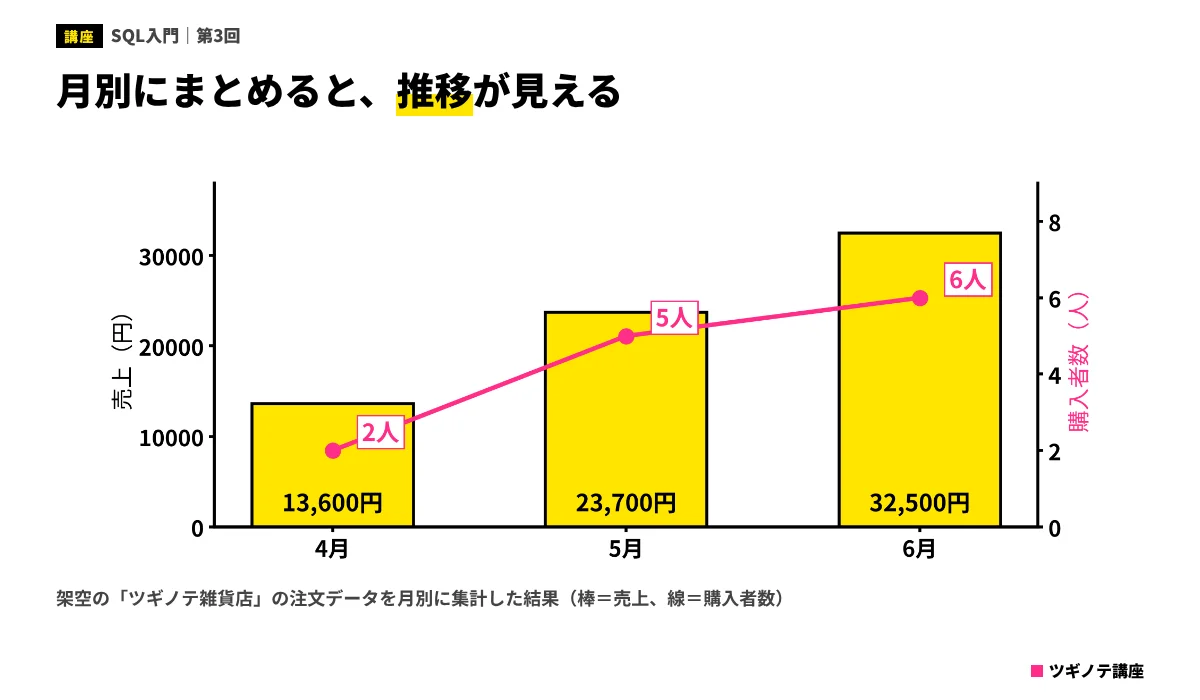
| 2026-04 | 3 | 13600 | 2 |
| 2026-05 | 5 | 23700 | 5 |
| 2026-06 | 7 | 32500 | 6 |
ここで使った substr(order_date, 1, 7) は、「2026-04-05」という文字の1文字目から7文字を取り出して「2026-04」にする書き方です(SQLiteの場合)。日付を月にまとめる書き方は、データベースによって違う「方言」が出やすいところです。BigQueryでは、日付型の列に対して FORMAT_DATE(‘%Y-%m’, order_date) や DATE_TRUNC(order_date, MONTH) を使います。詳しくは第6回で扱います。
また、ここでは GROUP BY に別名の month を書いています。GROUP BY でSELECTの別名を使えるかどうかもデータベースによって違うので、使えない場合は GROUP BY substr(order_date, 1, 7) のように式をそのまま書きます。
GROUP BY category を使うとき、SELECTにそのまま書いてよいものの組み合わせとして正しいものはどれでしょう?
- category と order_id
- order_id と amount
- category と SUM(amount)
答えと解説
正解は3です。GROUP BYを使うと、SELECTに書けるのはGROUP BYに書いた列と集計関数だけです。order_id や amount はグループの中に複数の値があるので、そのままでは書けません。
HAVING:まとめた結果を絞る
GROUP BYでまとめた結果に条件を付けたいときは、WHEREではなくHAVINGを使います。たとえば「2回以上注文している顧客」を出すなら、次のように書きます。
SELECT customer_id,
       COUNT(*) AS orders
FROM orders
GROUP BY customer_id
HAVING COUNT(*) >= 2
ORDER BY orders DESC, customer_id;
| customer_id | orders |
|---|---|
| C001 | 4 |
| C002 | 3 |
| C004 | 2 |
| C006 | 2 |
ORDER BYに「orders DESC, customer_id」と2つの列を書くと、注文回数が同じときは customer_id の順に並びます。並び順を決めきっておくと、何度実行しても同じ結果になります。
WHEREとHAVINGの違い
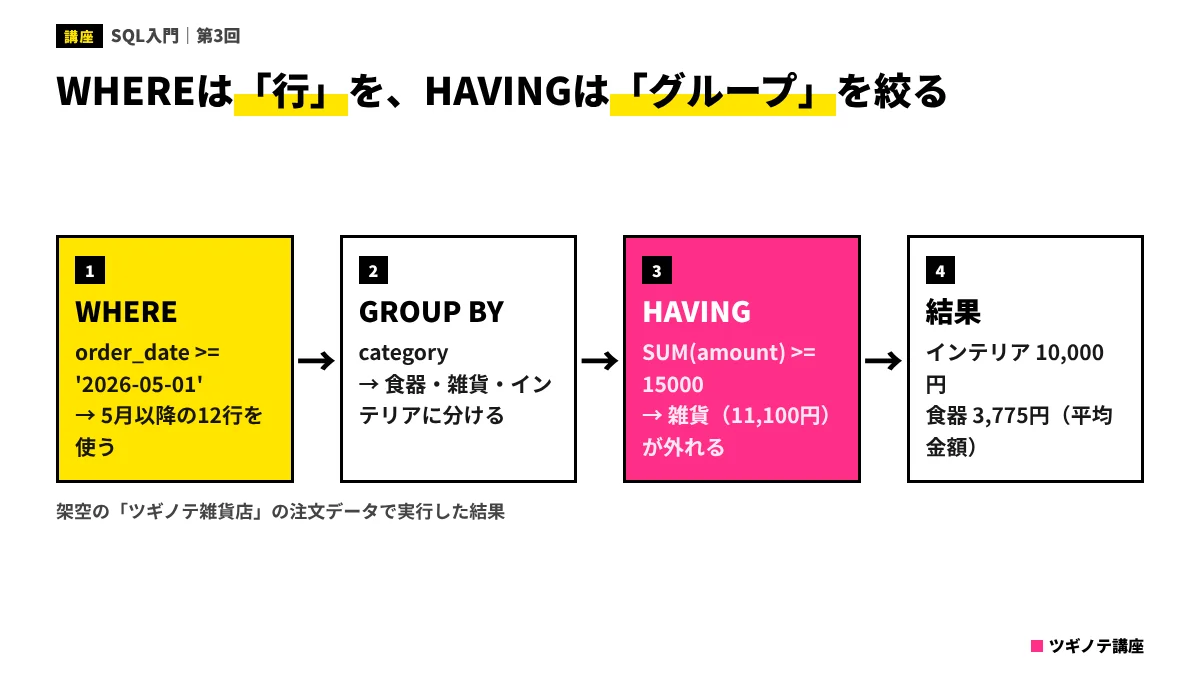
第1回で学んだ処理の順番を思い出してください。WHEREはGROUP BYより前、HAVINGはGROUP BYより後に処理されます。
- WHERE:まとめる前の「1行ずつ」に条件を付ける(例:5月以降の注文だけを使う)
- HAVING:まとめた後の「グループごとの結果」に条件を付ける(例:売上の合計が15,000円以上のカテゴリーだけを出す)
両方を組み合わせることもできます。「5月以降の注文で、売上の合計が15,000円以上のカテゴリーについて、平均の注文金額を出す」なら、次のとおりです。
SELECT category,
       ROUND(AVG(amount)) AS avg_amount
FROM orders
WHERE order_date >= '2026-05-01'
GROUP BY category
HAVING SUM(amount) >= 15000
ORDER BY avg_amount DESC;
| category | avg_amount |
|---|---|
| インテリア | 10000.0 |
| 食器 | 3775.0 |
5月以降の雑貨の売上は11,100円なので、HAVINGの条件で外れました。WHEREで「使う行」を決め、GROUP BYでまとめ、HAVINGで「出すグループ」を決める、という流れです。
よくある誤解:「HAVINGはWHEREの言い換え」
HAVINGとWHEREは、どちらも「条件で絞る」ので、同じものに見えます。しかし、絞る対象が違います。「金額が5,000円以上の注文だけを集計したい」ときに HAVING amount >= 5000 と書くと、エラーになるか、意図しない結果になります。1行ずつの条件はWHERE、集計した値の条件はHAVING、と使い分けましょう。
CASE式:自分なりの区分を作る
データの中にない区分で集計したいこともあります。たとえば「5,000円以上の注文と、それ未満の注文で、売上を比べたい」ときです。このようなときは、CASE式で区分を作ってから、GROUP BYします。
SELECT CASE
         WHEN amount >= 5000 THEN '5000円以上'
         ELSE '5000円未満'
       END AS price_band,
       COUNT(*)    AS orders,
       SUM(amount) AS sales
FROM orders
GROUP BY price_band;
| price_band | orders | sales |
|---|---|---|
| 5000円以上 | 4 | 38600 |
| 5000円未満 | 11 | 31200 |
CASE式は「もし〇〇なら△△、そうでなければ□□」という、表計算ソフトのIF関数のような書き方です。WHENは上から順に判定され、最初に当てはまったものが使われます。注文の件数では4件しかない5,000円以上の注文が、売上では半分以上を占めていることが分かります。
CASE式は、年齢を年代に、金額を価格帯に、流入元を「広告」「広告以外」にまとめるなど、分析の切り口を自分で作るときに欠かせません。第5回のファネル分析でも使います。
「売上の合計が10,000円以上の顧客」だけを出したいとき、条件を書く場所として正しいものはどれでしょう?
- HAVING SUM(amount) >= 10000
- WHERE amount >= 10000
- WHERE SUM(amount) >= 10000
答えと解説
正解は1です。「売上の合計」は顧客ごとにまとめた後の値なので、HAVINGに書きます。WHERE amount >= 10000 は「1件で1万円以上の注文」になり、意味が変わります。WHEREには集計関数を書けません。
実務ではこう使う
集計のSQLを書けるようになると、管理画面にはない切り口の数字を、自分で出せるようになります。たとえば次のようなものです。
- 月別の売上・注文件数・購入者数と、購入者1人あたりの売上
- 商品カテゴリー別、価格帯別の売上の構成
- 2回以上買ってくれた顧客の数(リピーターの数)と、その割合
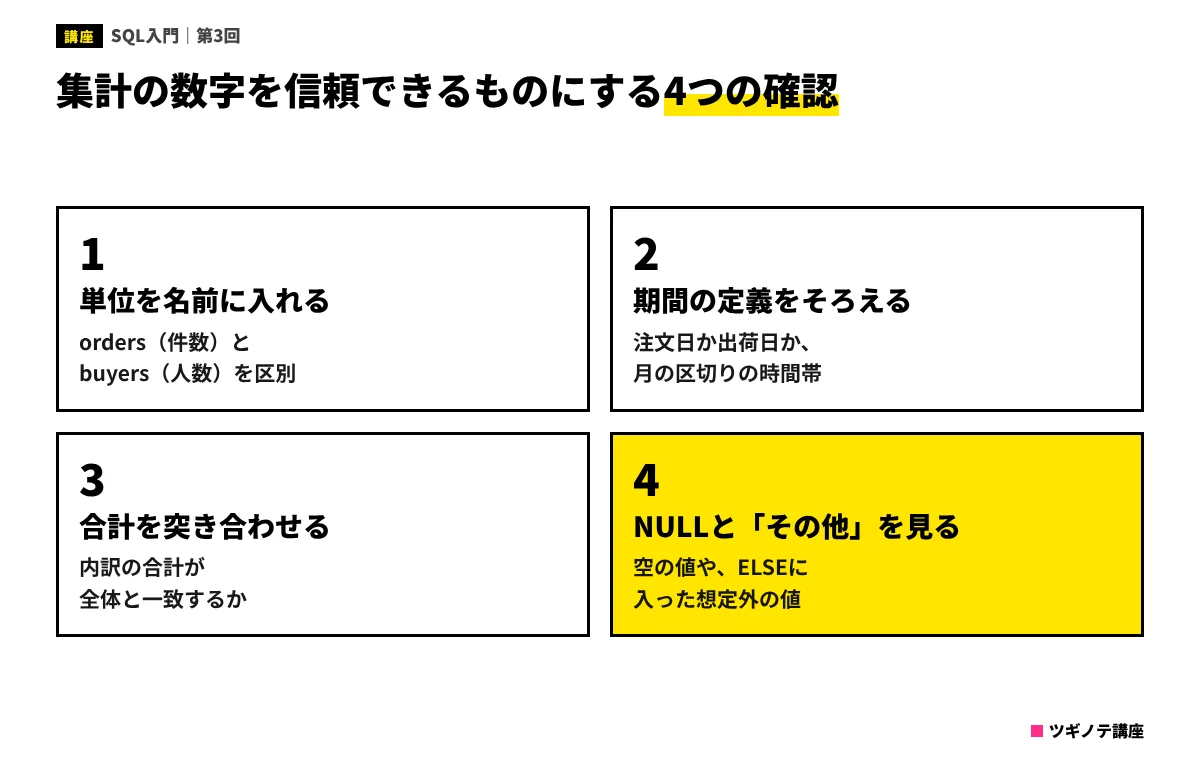
実務では、次の点に気をつけると、数字の食い違いを防げます。
- 数える単位を名前に入れる:orders(件数)と buyers(人数)のように、別名で単位を区別する
- 期間の定義をそろえる:注文日で集計するのか、出荷日で集計するのか。月の区切りは日本時間か
- 合計を突き合わせる:カテゴリー別の売上を足すと、全体の売上と一致するかを確かめる(サンプルでは38,600+18,300+12,900=69,800円で一致)
- NULLと「その他」を確かめる:カテゴリーが空の注文がないか、CASE式のELSEに想定外の値が入っていないか
出した数字の読み方、たとえば平均と中央値の違いや、前月との差が偶然かどうかの見分け方は、マーケターのためのデータ分析・統計入門で詳しく扱っています。
この回のまとめ
- COUNT・SUM・AVG・MIN・MAXの集計関数で、たくさんの行を1つの数字にまとめます。平均はROUNDで丸めると読みやすくなります。
- COUNT(*) は件数、COUNT(DISTINCT 列) は重複を除いた数(人数など)です。集計関数はNULLを無視します。
- GROUP BYで行をグループに分けて、グループごとに集計します。SELECTに書けるのは、GROUP BYの列と集計関数だけです。
- まとめる前の行の条件はWHERE、まとめた後のグループの条件はHAVINGに書きます。
- CASE式で価格帯などの区分を自分で作り、その区分でGROUP BYできます。
確認テスト
注文の表で COUNT(*) が15、COUNT(DISTINCT customer_id) が8でした。この結果から言えることはどれでしょう?
- 注文は8件で、注文した顧客は15人
- 注文した顧客のうち7人は、注文が0件
- 注文は15件で、注文した顧客は8人(何度も注文した顧客がいる)
答えと解説
正解は3です。COUNT(*) は行(注文)の数、COUNT(DISTINCT customer_id) は重複を除いた顧客の数です。件数が人数より多いのは、同じ顧客が複数回注文しているからです。
アンケートの満足度の列に未回答(NULL)が多い表で、AVG(満足度) を計算しました。この平均の説明として正しいものはどれでしょう?
- 未回答を0点として含めた、全員の平均
- 回答した人だけの平均(未回答のNULLは無視される)
- NULLがあるので、必ずエラーになる
答えと解説
正解は2です。AVGなどの集計関数はNULLを無視します。回答率が低いと、その平均は全体を代表しないことがあるので、COUNT(*) と COUNT(満足度) の差で未回答の数を確かめましょう。
WHEREとHAVINGの使い分けとして正しいものはどれでしょう?
- WHEREはまとめる前の行に、HAVINGはGROUP BYでまとめた後のグループに条件を付ける
- WHEREはまとめた後のグループに、HAVINGはまとめる前の行に条件を付ける
- どちらも同じなので、好きなほうを使えばよい
答えと解説
正解は1です。処理の順番はWHERE→GROUP BY→HAVINGです。1行ずつの条件はWHERE、SUM(amount) のような集計した値の条件はHAVINGに書きます。
「5,000円以上の注文」と「5,000円未満の注文」に分けて売上を比べたいとき、最も適した書き方はどれでしょう?
- WHERE amount >= 5000 だけを書いて、1回だけ実行する
- ORDER BY amount DESC で並べて、目で数える
- CASE式で価格帯の区分を作り、その区分でGROUP BYする
答えと解説
正解は3です。CASE式で「5000円以上」「5000円未満」の区分を作ってGROUP BYすれば、1回のSQLで両方の件数と売上を並べて比べられます。
次回予告
次回は、2つ以上の表をつなぐJOINを学びます。顧客の表と注文の表を customer_id でつなぎ、「流入元ごとの売上」のような分析をします。表をつなぐと行が消えたり増えたりする落とし穴と、その避け方も、実際の結果で確かめます。
参考資料
- Google Cloud「GoogleSQL:Query syntax(GROUP BY・HAVING)」(確認日:2026年11月12日)https://docs.cloud.google.com/bigquery/docs/reference/standard-sql/query-syntax
- Google Cloud「GoogleSQL:Date functions(FORMAT_DATE・DATE_TRUNC)」(確認日:2026年11月12日)https://docs.cloud.google.com/bigquery/docs/reference/standard-sql/date_functions
この記事は役に立ちましたか?
NEXTあわせて読みたい
-
 BPOサービス(業務アウトソーシング)おすすめ7選|コンタクトセンター・バックオフィスの外注先を規模・料金・事例で比較
-
 Shopify制作会社おすすめ7選|Shopify Plus・越境EC・運用まで、認定・実績・事例で比較
-
 マーケティング研修おすすめ7選|法人向けの基礎・実践・BtoB研修を料金・形式・実績で比較
-
 ECコンサル会社おすすめ5選|楽天・Amazon・自社ECの売上を伸ばす支援会社を範囲・料金・事例で比較
-
 広報・PR代行(PR会社)おすすめ7選|ベクトル・プラップジャパン・共同ピーアールなどを支援範囲・料金・事例で比較
-
 企業データベースおすすめ6選|Speeda・帝国データバンク・東京商工リサーチ・ユーソナーなどを料金・収録数で比較