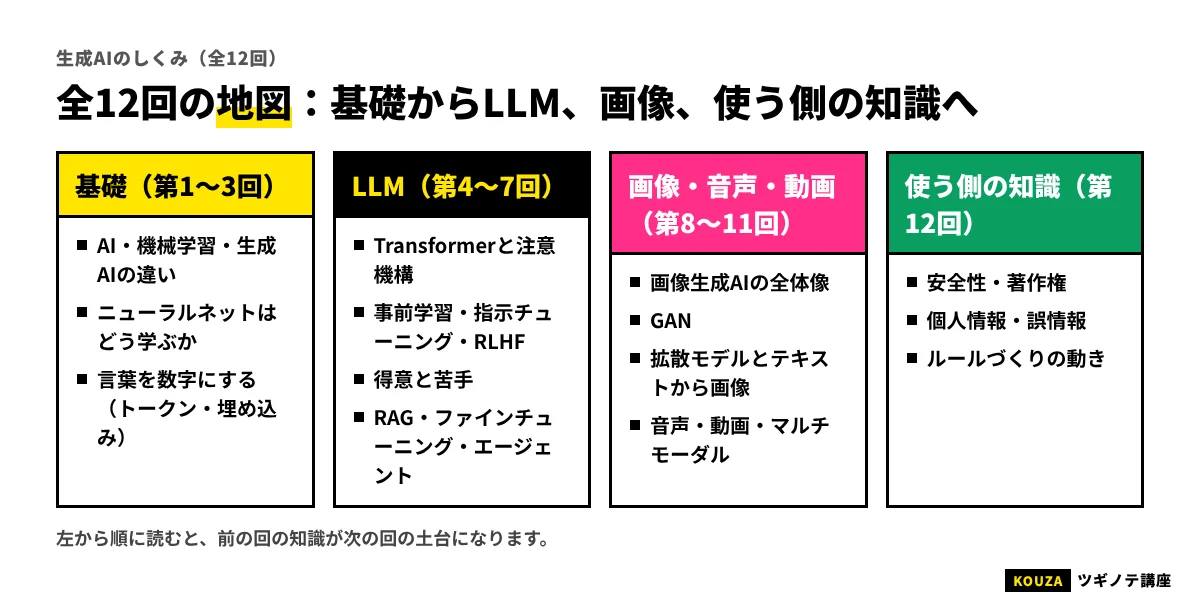
4つの部で学べること
第1部機械学習の基本第1〜2回
- AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 言葉を数字にする:トークンと埋め込み(ベクトル)
- Transformerと注意機構:LLMの心臓部を図で理解する
- LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック
- LLMの得意と苦手:ハルシネーション・コンテキスト長・推論
- 画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか
- GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる
- 拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く
- 音声・動画・マルチモーダル:文字以外を扱う生成AI
- 安全性・著作権・これからの生成AI:使う側が知っておくべきこと
カリキュラム
第1部機械学習の基本第1〜2回
第2部LLMのしくみ第3〜7回
第3部画像を作るAI第8〜10回
全12回を読み終えると、修了です。
修了ページを見る各回の最後の確認テストの点数と、部ごとの修了の記録が、修了ページにまとまります(記録はこのブラウザに残ります)。第4回からは無料の会員登録で読めます。
この講座について
ChatGPTやClaude、Geminiに質問すると、なぜ人間のような文章が返ってくるのか。文字から写真のような画像が生まれるのはなぜか。この講座では、生成AIの「中身」を、数式を使わずに第1回から順番に解き明かします。全12回を読み終えるころには、ニュースで見る「LLM」「Transformer」「GAN」「拡散モデル」「RAG」といった言葉を、自分の言葉で説明できるようになります。
こんな人におすすめ
- 生成AIを仕事で使い始めたが、「なぜ間違えるのか」「どこまで任せてよいのか」が腹落ちしていない人
- 社内でAI活用を推進する立場になり、エンジニアやベンダーと同じ言葉で話せるようになりたい人
- ニュースで見るAIの用語がバラバラに頭に入っていて、一度きちんと整理したい人
- 画像生成AIや動画生成AIの仕組みと、著作権などのリスクを知ったうえで使いたい人
- 数式は苦手だが、仕組みを「なんとなく」ではなく理解したい人
読み終えるとできるようになること
- AI・機械学習・ディープラーニング・生成AIの関係を、図にして説明できる
- LLM(大規模言語モデル)が「次に来る言葉を予測する」仕組みと、Transformerの注意機構の役割を説明できる
- ハルシネーション(もっともらしい誤り)がなぜ起きるかを理解し、業務での防ぎ方を選べる
- RAG・ファインチューニング・AIエージェントの違いと、どんな場面で使い分けるかが分かる
- GANと拡散モデルの仕組みの違いを、たとえ話で説明できる
- 著作権・個人情報・安全性について、生成AIを使う側として最低限押さえるべき点が分かる
シラバス(全12回)
- AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 言葉を数字にする:トークンと埋め込み(ベクトル)
- Transformerと注意機構:LLMの心臓部を図で理解する
- LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック
- LLMの得意と苦手:ハルシネーション・コンテキスト長・推論
- RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法
- 画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか
- GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる
- 拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く
- 音声・動画・マルチモーダル:文字以外を扱う生成AI
- 安全性・著作権・これからの生成AI:使う側が知っておくべきこと
| 回 | ひとことで | キーワード |
|---|---|---|
| 第1回 | AI関連の言葉の「入れ子」を整理する | AI、機械学習、ディープラーニング、生成AI、識別と生成 |
| 第2回 | AIが「学ぶ」とは、ずれを少しずつ直すこと | ニューロン、重み、損失関数、勾配降下法、誤差逆伝播 |
| 第3回 | 文章をAIが扱える数字に変える | トークン、トークナイザー、埋め込み、ベクトル、意味の近さ |
| 第4回 | 文脈を読む仕組み「注意」 | Transformer、自己注意、Query・Key・Value、位置情報 |
| 第5回 | 物知りな予測マシンを、話の通じるアシスタントにする | 事前学習、スケーリング、指示チューニング、RLHF |
| 第6回 | なぜ間違えるのか、どこまで覚えていられるのか | ハルシネーション、コンテキストウィンドウ、推論、温度 |
| 第7回 | 社内データや業務につなぐ方法 | RAG、ファインチューニング、LoRA、ツール利用、エージェント |
| 第8回 | 画像生成AIの系譜を一気に見る | VAE、GAN、拡散モデル、潜在空間 |
| 第9回 | 生成器と識別器の「いたちごっこ」 | 生成器、識別器、敵対的学習、モード崩壊、StyleGAN |
| 第10回 | ノイズから絵が浮かび上がる仕組み | 拡散過程、ノイズ除去、潜在拡散、CLIP、プロンプト |
| 第11回 | 声・音・動画・複数の情報を同時に扱う | 音声認識、音声合成、動画生成、マルチモーダル |
| 第12回 | リスクと付き合い方、この先の展望 | 著作権、個人情報、ディープフェイク、ガイドライン、規制 |
講座の進め方
- 1回あたりの目安:本文を読むのに15〜20分。
- ちょこっとクイズ:各回の途中に2〜3問あります。読み進めながら理解を確かめてください。選択肢を押すと、正解と解説が出ます。
- 確認テスト:各回の最後に3〜5問。全部答えると点数が出ます。満点でなければ、解説を読み直してから次の回へ進むのがおすすめです。
- もう一歩深く:少し専門的な補足です。読み飛ばしても、本筋の理解には困りません。
- 読んだ記録:読んだ回には、このページの目次に✓が付きます(お使いのブラウザに記録されます)。
数式はほとんど使いません。代わりに、表・手順・たとえ話で説明します。ただし、たとえ話は理解の入口であって、仕組みそのものではありません。「たとえとして分かりやすいが、実際はここが違う」という点も、できるだけ書き添えています。
関連する記事
講座で仕組みを学んだら、実際のツール選びや社内展開にも役立ててください。
社内でのAI活用について相談したい場合は、ツギノテ編集部への相談から受け付けています。
この記事は役に立ちましたか?
この講座の全12回
- 第1回AI・機械学習・ディープラーニング・生成AIは何が違う?:言葉の地図をつくる
- 第2回ニューラルネットワークはどう「学ぶ」のか:重み・損失・誤差逆伝播をたとえで
- 第3回言葉を数字にする:トークンと埋め込み(ベクトル)
- 第4回Transformerと注意機構:LLMの心臓部を図で理解する会員
- 第5回LLMはどう育てられるのか:事前学習・指示チューニング・人のフィードバック会員
- 第6回LLMの得意と苦手:ハルシネーション・コンテキスト長・推論会員
- 第7回RAG・ファインチューニング・AIエージェント:LLMを仕事に組み込む3つの方法会員
- 第8回画像生成AIの全体像:画像を「つくる」AIはどう進化してきたか会員
- 第9回GANの仕組み:偽造者と鑑定士の競争で画像が上手くなる会員
- 第10回拡散モデルとテキストから画像:ノイズを少しずつ消して絵を描く会員
- 第11回音声・動画・マルチモーダル:文字以外を扱う生成AI会員
- 第12回安全性・著作権・これからの生成AI:使う側が知っておくべきこと会員