第1部
第2回/全10回
分析の土台:顧客データの整備と名寄せ
この回で分かることは3つです。①顧客データが社内で散らばり、汚れている原因。②複数のシステムにある同じ会社の情報を1つにまとめる「名寄せ」の手順。③分析に使える「1社1行の表」の作り方と、整備に力尽きないための範囲の決め方です。
前回、分析は「問い」から始めると見ました。問いが決まると、必要なデータが決まります。今回は、そのデータを、分析できる形に整える工程です。地味ですが、ここでつまずく会社が最も多い工程です。
顧客データはなぜ散らばり、汚れるか
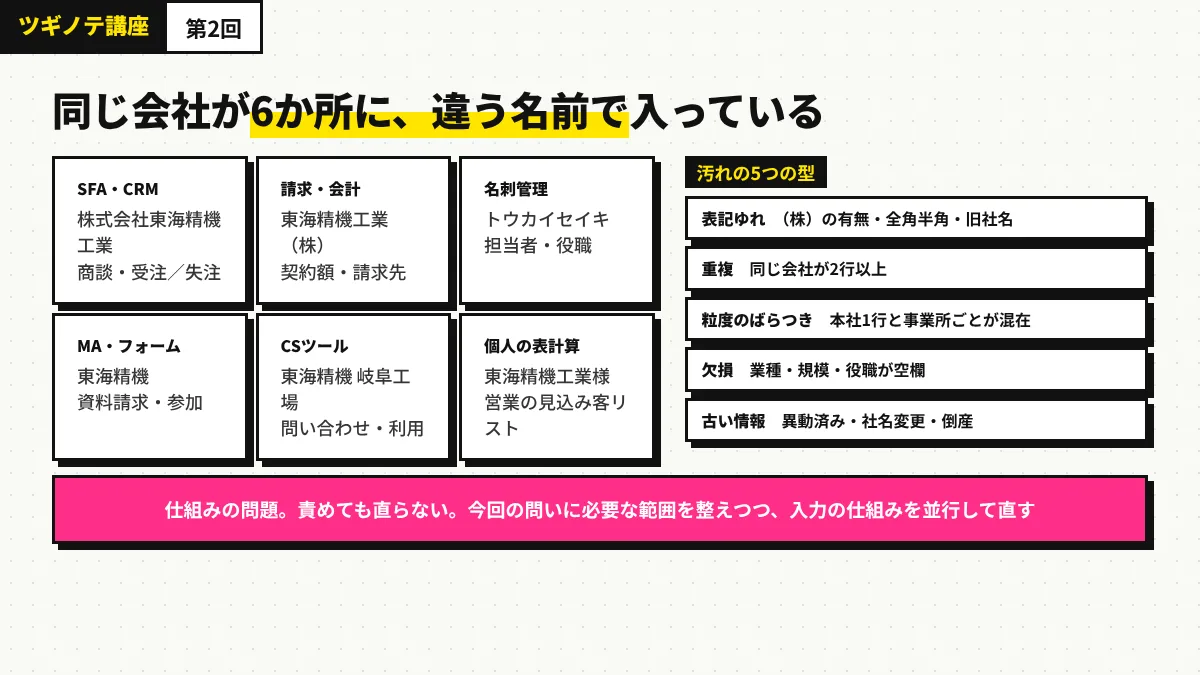
BtoBの会社では、顧客の情報が次のような場所に分かれて入っています。
| 場所 | 入っている情報 | 持っている部門 |
|---|---|---|
| SFA・CRM | 商談、受注/失注、担当営業、活動履歴 | 営業 |
| 請求・会計システム | 契約額、請求先、入金、契約期間 | 経理 |
| 名刺管理ツール | 担当者の氏名・役職・部署、名刺交換日 | 営業個人 |
| MA・問い合わせフォーム | 資料請求、セミナー参加、メールの開封、問い合わせ内容 | マーケ |
| サポート・CSのツール | 問い合わせ、要望、トラブル、利用状況 | CS |
| 表計算ソフトの個人ファイル | 営業が各自で管理している見込み客リスト | 営業個人 |
それぞれ、入れた人も、目的も、時期も違います。だから、同じ会社が「株式会社東海精機工業」「東海精機工業(株)」「トウカイセイキ」「東海精機 岐阜工場」と、別々の名前で、別々の場所に入っています。これが「散らばって、汚れている」状態です。
汚れの5つの型
| 型 | 例 | 起きる原因 |
|---|---|---|
| 表記ゆれ | 「株式会社」の有無・位置、全角半角、略称、旧社名 | 手入力、システムごとのルールの違い |
| 重複 | 同じ会社が2行以上ある | 別の営業が別々に登録、名刺の取り込み |
| 粒度のばらつき | 本社で1行の会社と、事業所ごとに1行の会社が混在 | 取引単位がシステムで違う(契約は本社、請求は事業所) |
| 欠損 | 業種・従業員数・役職が空欄 | 入力が任意、入れる動機がない |
| 古い情報 | 担当者が異動済み、社名が変わった、倒産 | 更新の仕組みがない |
5つとも、「誰かがさぼった」のではなく、仕組みの問題です。だから、責めても直りません。分析のためには、まず「今あるものを、今回の問いに必要な範囲で」整え、並行して、入力の仕組みを少しずつ直します。
ちょこっとクイズ:「本社で1行の会社と、事業所ごとに1行の会社が混ざっている」のは、汚れのどの型?
- 表記ゆれ
- 重複
- 粒度のばらつき
答えと解説
正解は3。契約は本社、請求は事業所、のように、システムごとに取引の単位が違うことで起きます。分析では「会社」の単位を先に決めてから揃えます。
名寄せ:同じ会社を1つにまとめる
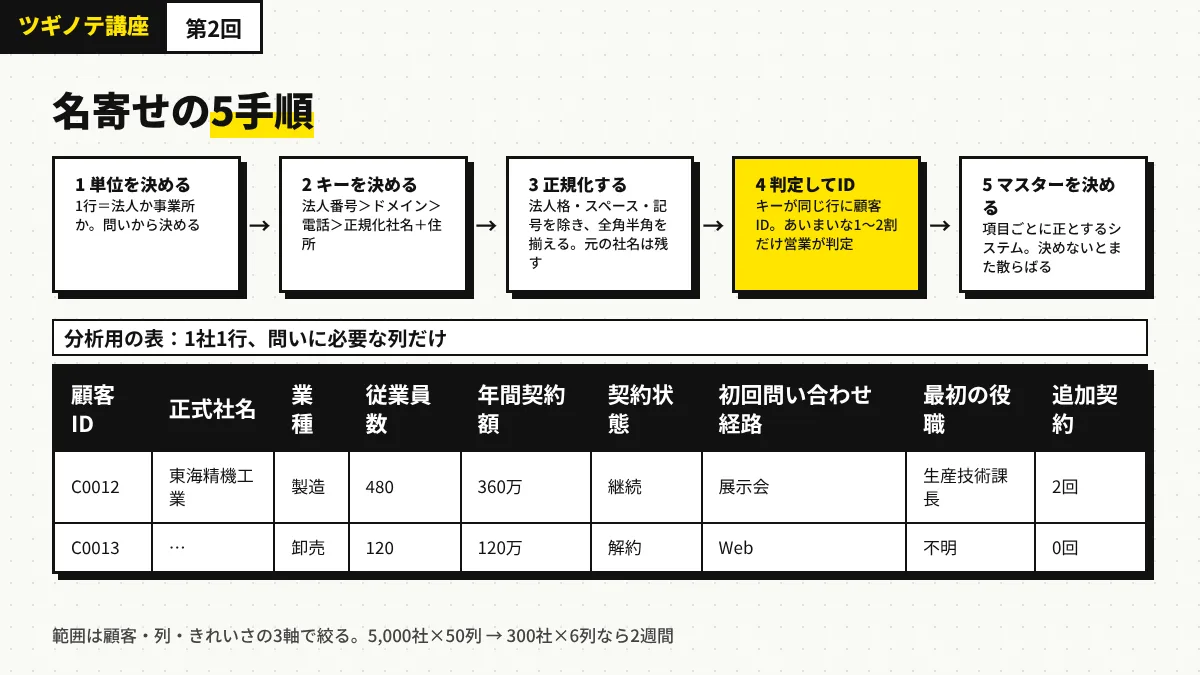
名寄せとは、複数の場所にある同じ会社の情報を、「これは同じ会社だ」と判定して、1つにまとめることです。手順は5つです。
手順1:「会社」の単位を決める
名寄せの前に、「1行=何か」を決めます。多くの場合は「法人」(本社)ですが、事業所ごとに契約が独立している商材(工場ごとに導入する設備など)なら「事業所」です。第1回の問いに戻って、「訪問先を決める」なら法人、「設備の追加提案先を決める」なら事業所、のように決めます。
手順2:キーを決める
「同じ会社」と判定するための手がかり(キー)を決めます。使えるものは、確実な順に次の通りです。
- 法人番号:国税庁が法人ごとに付けている13桁の番号。最も確実。企業データベースや請求情報にあることが多い
- ドメイン:メールアドレスの@以降。「@tokai-seiki.co.jp」なら、ほぼ同じ会社。ただし、グループ会社で共通のこと、フリーメールのことがある
- 電話番号:代表番号で判定。事業所が違うと番号も違う
- 正規化した社名+住所:社名から「株式会社」「(株)」「スペース」を除き、全角半角を揃えた上で、住所(都道府県+市区町村)と組み合わせる
実務では、「法人番号があればそれで、なければドメイン、それもなければ正規化した社名+住所」の順で判定します。
手順3:正規化する
社名の表記を揃える処理です。表計算ソフトの関数か、簡単なスクリプトで行います。
- 「株式会社」「(株)」「(株)」「㈱」「有限会社」「(有)」などの法人格を除く
- 全角英数字・カナを半角に、または半角を全角に揃える
- スペース(全角・半角)を除く
- 「・」「-」「-」などの記号を除く
- 旧社名→新社名の対応表を作って置き換える(これは手作業)
正規化した結果を「名寄せキー」の列に入れます。元の社名は消さず、別の列に残します。
手順4:判定して、IDを振る
名寄せキーが同じ行を「同じ会社」とみなし、共通のID(顧客ID)を振ります。ここで、機械的に判定できない「あいまいなもの」が1〜2割残ります。「東海精機」と「東海精機工業」は同じか、「〇〇ホールディングス」と「〇〇株式会社」は分けるか。これは、営業に見てもらって、人が判定します。全部を人が見るのではなく、あいまいなものだけを一覧にして渡します。
手順5:マスターを1つ決める
名寄せした後、「この会社の正しい情報はどれか」を決める元(マスター)を1つ決めます。社名と住所は請求システム、担当者はSFA、業種と従業員数は企業データベース、のように、項目ごとに「どのシステムを正とするか」を決めます。決めないと、次に更新するときに、また散らばります。
ちょこっとクイズ:名寄せのキーとして、最も確実なものは?
- 法人番号
- 社名(入力されたまま)
- 担当者の氏名
答えと解説
正解は1。法人番号は国税庁が法人ごとに付けている13桁の番号で、表記ゆれがありません。なければドメイン、電話番号、正規化した社名+住所の順で使います。
分析用の「1社1行の表」を作る
名寄せができたら、分析のための表を1つ作ります。縦に顧客(1社1行)、横に項目です。この表が、第3回以降のすべての分析の土台になります。
列の構成
| 区分 | 列の例 | 元のシステム |
|---|---|---|
| ID・名前 | 顧客ID、正式社名、名寄せキー | 名寄せの結果 |
| 属性 | 業種、従業員数、売上規模、所在地、拠点数 | 企業データベース、SFA |
| 取引 | 初回受注日、現在の契約額(年間)、累計売上、契約状態(継続・解約)、追加契約の回数 | 請求・会計、SFA |
| 商談 | 最初の問い合わせ経路、最初に問い合わせた人の役職、受注までの日数、失注の有無と理由 | SFA、MA |
| 行動 | 資料請求・セミナー参加の回数、サポート問い合わせ件数、ログイン頻度(SaaSの場合) | MA、CSツール、製品のログ |
この表は、最初から全列を埋める必要はありません。第1回の問いに必要な列だけを、最初に埋めます。前回のケース(新任営業の担当顧客群を決める)なら、業種・従業員数・受注/失注・追加契約の有無、の4列で足ります。
「問いに必要な最小限」の決め方
整備で力尽きないために、範囲を3つの軸で絞ります。
- 顧客の範囲:全顧客ではなく、問いに関係する顧客。「直近2年に商談があった会社」「現在契約中の会社」など
- 列の範囲:問いの「選択肢」と「判断の基準」に出てくる項目だけ
- きれいさの範囲:欠損が3割あっても、残り7割で傾向が見えるなら進める。全行を埋めてから、ではない
この3つで絞ると、全顧客5,000社×50列の整備が、300社×6列になります。1〜2週間で終わります。
欠損の埋め方
絞っても、業種や従業員数が空欄の行は残ります。埋め方は、確実な順に次の通りです。
- 企業データベース(有料・無料)で、社名か法人番号から引く
- 会社のサイトの会社概要から、手で拾う(100社以下なら現実的)
- 営業に「この会社の業種・規模は」と聞く
- 埋まらないものは「不明」として残し、分析から除くか、「不明」という1つの区分として扱う
「不明」が多い項目は、入力の仕組みの問題です。並行して、SFAの入力項目に「業種(選択式)」「従業員数(区分選択)」を必須にする、名刺取り込み時に企業データベースと自動で突き合わせる、といった仕組みを入れます。
ケースで考える:整備に3か月かけて力尽きた会社と、2週間で終えた会社
A社は、「顧客分析をするなら、まずデータをきれいにしよう」と、全顧客4,200社の全項目の名寄せと欠損の補完を始めました。3か月後、名寄せは終わりましたが、欠損の補完が半分も進まず、担当者は異動になり、分析は始まりませんでした。
B社は、第1回の問い(「解約した顧客に共通する導入後3か月の行動は何か」)を先に決めました。必要な顧客は「直近2年に解約した38社と、同時期に契約して継続している200社」、必要な列は「業種・従業員数・導入後3か月のログイン回数・サポート問い合わせ件数・導入支援の有無」の5つでした。名寄せは、この238社だけ。ログインとサポートのデータは、製品のログとCSツールから、顧客IDで結合しました。2週間で表ができ、3週目に「解約した顧客は、導入後3か月のログイン回数が継続顧客の3分の1以下、かつ導入支援を受けていない」という結果が出て、CSが「導入後1か月でログインが少ない顧客に先に連絡する」運用を始めました。
A社とB社の差は、データの量でも、ツールでも、担当者の技術でもなく、「問いから範囲を絞ったか」だけです。
実務ではこう使う:整備の作業計画(2週間)
| 日程 | やること | 成果物 |
|---|---|---|
| 1〜2日目 | 問いから、顧客の範囲・列の範囲を決める。各列の元システムを確認 | 範囲の定義(1枚) |
| 3〜4日目 | 各システムから、範囲内の顧客のデータを書き出す | システムごとの書き出しファイル |
| 5〜7日目 | 社名を正規化し、キーで名寄せ。あいまいなものを一覧にする | 名寄せ結果、あいまい一覧 |
| 8日目 | あいまい一覧を営業に見てもらい、判定 | 判定済み一覧 |
| 9〜10日目 | 顧客IDで各システムのデータを結合し、1社1行の表にする | 分析用の表 |
| 11〜12日目 | 欠損を、企業データベースとサイトで埋める。埋まらないものは「不明」 | 補完済みの表 |
| 13〜14日目 | 項目ごとのマスターを決め、次回の更新手順をメモする | マスター定義、更新手順 |
この表を、第3回以降で使います。
この回のまとめ
- 顧客データは、SFA・請求・名刺管理・MA・CSツール・個人ファイルに散らばり、表記ゆれ・重複・粒度のばらつき・欠損・古い情報の5つの型で汚れています。仕組みの問題なので、責めても直りません。
- 名寄せは、会社の単位を決める→キーを決める(法人番号>ドメイン>電話>正規化社名+住所)→正規化する→判定してIDを振る→マスターを決める、の5手順。あいまいな1〜2割だけ人が判定します。
- 分析用の表は1社1行。属性・取引・商談・行動の列を、問いに必要なものだけ埋めます。
- 範囲は、顧客・列・きれいさの3軸で絞ります。5,000社×50列を300社×6列にすれば、2週間で終わります。
- 欠損は、企業データベース→サイト→営業の順で埋め、残りは「不明」として扱います。入力の仕組みは並行して直します。
確認テスト
顧客データが汚れる原因についての正しい考え方は?
- 入力した営業がさぼったからで、注意すれば直る
- 入れた人・目的・時期が違う仕組みの問題で、今回の範囲を整えつつ、入力の仕組みを並行して直す
- 新しいシステムを入れれば自動で直る
答えと解説
正解は2。表記ゆれも重複も欠損も、仕組みから起きます。責めても直らず、システムを変えても入力の仕組みが同じなら同じように汚れます。
名寄せで、機械的に判定できない「あいまいなもの」はどうするか?
- すべて別の会社として扱う
- すべて同じ会社として扱う
- あいまいなものだけを一覧にして、営業に判定してもらう
答えと解説
正解は3。あいまいなものは1〜2割残ります。全部を人が見るのではなく、あいまいなものだけを渡すのがコツです。
整備で力尽きないための範囲の絞り方は?
- 顧客の範囲・列の範囲・きれいさの範囲を、問いに必要な最小限にする
- 最も古いデータから順に整備する
- 最も入力が多いシステムだけを使う
答えと解説
正解は1。全顧客×全列を、問いに関係する顧客×問いに出てくる列に絞り、欠損が3割あっても傾向が見えるなら進めます。
名寄せの後に「マスターを1つ決める」理由は?
- システムの費用を減らすため
- 項目ごとに正とするシステムを決めないと、次の更新でまた散らばるため
- 法律で決まっているため
答えと解説
正解は2。社名と住所は請求システム、担当者はSFA、業種は企業データベース、のように決めておくと、更新のたびに名寄せをやり直さずに済みます。
次回予告
第3回は「どのデータを見るか:属性・行動・取引の3層」です。1社1行の表の列を、属性・行動・取引の3層で整理し、それぞれどこから手に入り、何が分かり、最初に見るべき項目は何かを扱います。
NEXT|第3回どのデータを見るか:属性・行動・取引の3層次の回へ進む →この記事は役に立ちましたか?